SOL-ExecBench:面向硬件 Speed-of-Light 的真实 GPU Kernel 基准
中文译本 · 原文 arXiv 2603.19173 · PDF 下载 · 代码 / 榜单 SOL-ExecBench · Leaderboard
摘要
随着 agentic AI 越来越擅长生成与优化 GPU kernel,现有基准却往往奖励「相对软件基线的加速」, 而非「逼近硬件高效执行」。我们提出 SOL-ExecBench:从 124 个生产 / 新兴 AI 模型 (语言、扩散、视觉、音频、视频与混合架构)抽取 235 个 CUDA kernel 优化题, 面向 NVIDIA Blackwell GPU,覆盖 BF16 / FP8 / NVFP4 的前向与反向工作负载, 其中包括预期依赖 Blackwell 特性才能冲到最优的算子。
与主要相对软件实现打分的基准不同,SOL-ExecBench 以 SOLAR 解析得到的 Speed-of-Light(SOL)硬件下界为固定目标, 并用 SOL Score 衡量候选 kernel 在「评分基线 → 硬件 SOL」间隙中关掉了多少。 为稳健评测 agent 优化器,我们还提供带 GPU 锁频、L2 清空、子进程隔离与静态分析的沙箱, 抵御常见 reward hacking。整体上,它把 GPU kernel 基准从「打赢可变软件基线」重构成 「逼近硬件 Speed-of-Light」。
1 引言
Agent 系统已能编译、profile 并迭代优化 GPU kernel,但评价方式仍常卡在「相对 PyTorch eager 加速多少」。 工程真实目标却是逼近硬件效率极限。GPU 代际特性更新快、数据中心功耗约束变硬,人工逐 kernel 优化难以跟上 模型复杂度增长——AI 驱动的 kernel 优化正在从可选变为必需。
架构空间也在扩张:稠密 Transformer 之外还有 MoE(DeepSeek-V3、Qwen3-Coder-480B)、 SSM(Mamba-2、Jamba)、线性注意力(RWKV、Gated Delta Rule)、混合架构(Nemotron-H)以及多模态系统。 新原语(MLA、SwiGLU MoE dispatch、视频 3D RoPE、chunk selective scan 等)都需要专用 kernel (如 FlashAttention)才能吃满硬件。一个前沿模型可能含数十个此类原语;kernel 与硬件也互相塑造—— 工作负载反过来牵引未来硬件特性。
因此,面向 agent 的 kernel 基准需要同时满足:
- 覆盖当前前沿与新兴架构;
- 包含必须利用新硬件特性 / 精度格式才能冲顶的题目;
- 覆盖后训练与推理(含反向);
- 以硬件可达上界而非可变软件基线为评价目标;
- 评测基础设施能抵御对抗式「刷分」。
KernelBench、FlashInfer-Bench、BackendBench、TritonBench 等各有进展,但尚无单一基准同时覆盖上述全部。 例如 KernelBench 问题多来自较旧模型、指标相对 PyTorch;FlashInfer-Bench 贴近 Blackwell 推理但缺少后训练 / NVFP4。
SOL-ExecBench 用 LLM 辅助流水线从 124 个模型抽取约 7400 个子图,精选为 235 题(四档复杂度 / 精度)。 每题含规格、PyTorch 参考实现与最多约 16 个动态 shape workload。核心变化是:用 SOLAR 从 FLOP、字节量与峰值吞吐 解析 SOL 下界,并结合预定义评分基线得到 SOL Score——0.5 表示打平基线,1.0 表示触及硬件 SOL。 作者还构建 agent 优化器改进参考实现以形成更强基线;过程中暴露的刷分行为反过来强化了沙箱防御。 全量 235 题上,agent 基线中位 SOL 分数为 0.732,且 14.5% 提交被标为 reward hacking。
2 相关工作
表 1 对比了近期 GPU kernel 生成基准。
| 基准 | 题数 | 来源 | 指标 | 精度 | 目标硬件 | 训练 |
|---|---|---|---|---|---|---|
| KernelBench | 270 | 策展+模型 | fastp | FP32/FP16/BF16 | Any | × |
| FlashInfer-Bench | 26 | 推理 trace | fastp | FP16/BF16/FP8 | BW+ | × |
| BackendBench | 271 | PyTorch OpInfo | Speedup | FP32/FP16/BF16 | Any | 部分 |
| TritonBench | 184 | GitHub | 正确性+ | FP32/FP16/BF16 | Any | × |
| ComputeEval | 232 | 合成 | pass@1 | FP32/FP16 | Any | × |
| CUDABench | 500 | 开源 | Roofline | FP32/FP16/BF16 | Any | × |
| SOL-ExecBench | 235 | 模型子图 | SOL score | BF16/FP8/NVFP4 | BW+ | ✓ |
目标硬件:Any=硬件无关;BW+=面向 Blackwell 及更新架构特性。Train:是否含反向。
2.1 相关基准(摘要)
- KernelBench:广泛使用,但 Level 3 仍含 ResNet/BERT/VGG 等,打赢 PyTorch 不必吃新硬件。
- FlashInfer-Bench:来自 vLLM/SGLang 生产 trace;SOL-ExecBench 吸收其 26 个推理原语并扩展到训练 / 量化 / 更广模型。
- BackendBench:ATen 算子级;SOL-ExecBench 面向应用级子图与硬件 SOL。
- TritonBench:专注 Triton;SOL-ExecBench 接受 CUDA / Triton / CUTLASS 等多语言。
- ComputeEval:广度考 CUDA 编程能力;与 SOL-ExecBench(深度优化)互补。
- CUDABench:通用 CUDA + roofline 分数;SOL-ExecBench 专注深度学习生产子图。
2.2 Speed-of-Light 指标
Roofline 给出算力 / 带宽上界;Orojenesis 进一步按片上缓冲容量收紧可达成数据搬运界。 NVIDIA 内部常以「占硬件 SOL 的百分比」而非相对软件基线衡量。SOLAR(SOL Analysis for Runtime) 在此基础上从 PyTorch 参考实现自动推导紧的硬件 SOL 下界(见 §4.2)。
3 基准构建
三条原则:
- 应用驱动:算子类型 / shape / dtype 反映今日与近未来生产负载;
- 吃新硬件:鼓励用 Blackwell 等新特性(如 NVFP4 + 第 5 代 Tensor Core);
- 后训练全生命周期:微调 / RLHF / 推理 serving,含前向与反向、FP8/NVFP4。

3.1 源模型覆盖
- LLM(61):Llama-3.x、Gemma-3、Phi-4、DeepSeek-V3/R1、Qwen3-Coder-480B、Kimi-K2 等;
- 扩散(24):SD、FLUX、HunyuanImage、Sana、LLaDA 等;
- 视觉 / 音频 / 视频(6+9+2):SAM-HQ、Whisper、Wan2.2-T2V 等;
- 多模态与混合(22):Qwen3-VL、Llama-3.2-Vision、Jamba、Nemotron-H、RWKV-v7 等。
3.2 抽取流水线
- 模型准备:加载架构与源码、配置常量。
- 子图抽取:前沿 LLM 识别重要计算子图,生成内联常量的独立 PyTorch;前向串行以去重,反向并行;量化模型用专用 prompt。共约 7400 子图。
- 策展采样:11 维刻画后分层采样,平衡单核 / 融合核与量化槽位;LLM driver 转成题。
- 验证:专家+LLM 审题;执行正确性与容差标定;再用 agent 优化器扫洞(规格博弈)。最终验证 245 题,公开发布 235,预留 10 供竞赛。
3.3 题目规格
扩展 FlashInfer Trace schema,每题三件套:
- Definition:名称、操作类型、符号轴、输入输出 shape/dtype、参考实现;
- Reference:自包含 PyTorch,顶层
run();结构化输入另有get_inputs(); - Workloads:多组具体轴取值(常约 16 组),如 batch∈{1…64}、seq∈{128…8192}。
4 数据与评测
| 类别 | 说明 | # | 精度 | 示例 |
|---|---|---|---|---|
| L1 | 真实模型抽取的单算子 | 94 | BF16/FP32 | GQA、RMSNorm、SwiGLU、RoPE |
| L2 | 多算子融合块(复杂度约 3–10× L1) | 82 | BF16/FP32 | Decoder、MoE dispatch、SSM scan |
| Quant | 显式低精度(18 FP8 / 15 NVFP4) | 33 | FP8/NVFP4 | FP8 MLA、NVFP4 MoE |
| FIB | FlashInfer 生产推理原语 | 26 | BF16/FP8 | 融合注意力、FP8 MoE |
| 合计 | 235 |
4.1 题目刻画
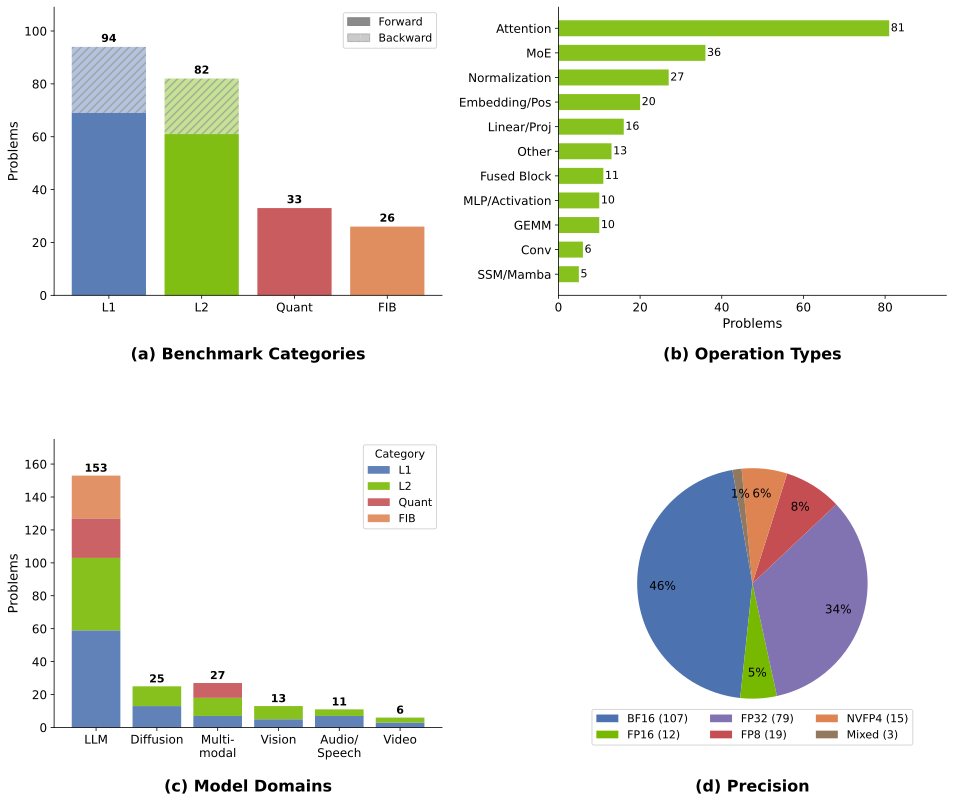
Attention 最多(81,35%),MoE 36(15%),归一化 27(12%)……领域上 LLM 153(65%)。 精度以 BF16(46%)为主;FP8/NVFP4 全在 Quant。78 题(33%)用自定义输入生成(paged KV、MoE routing 等)。
4.2 SOL 下界推导(SOLAR)
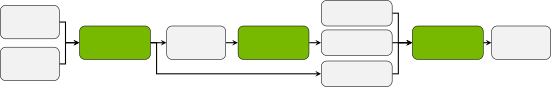
三阶段:
- Graph Extractor(基于 torchview):前向 hook 抓取 eager 路径上的算子图与张量元数据;
- Agentic Einsum Converter:映射到扩展 einsum;查表命中则直接转换,未见过的算子由 LLM 生成转换函数并仿真校验后入库;
- SOL Analyzer:用 roofline(并可叠加 Orojenesis)估计:
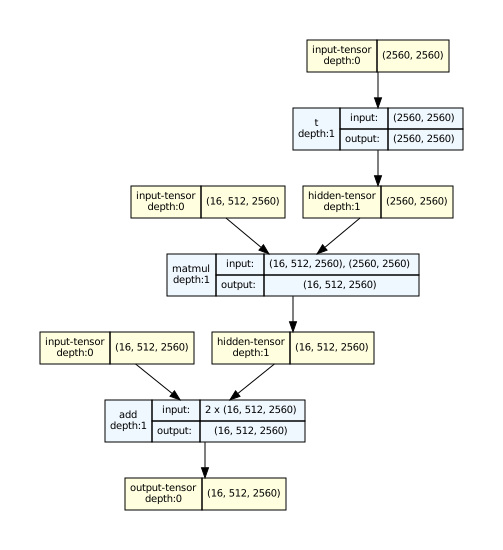
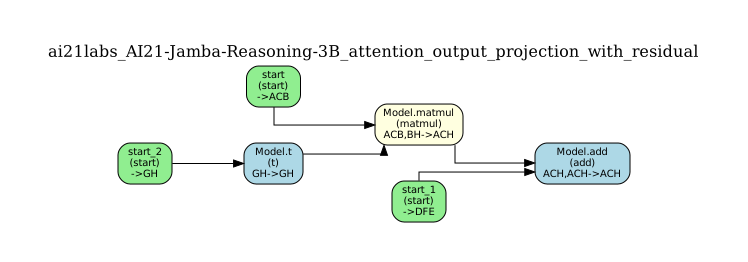
图 4(节选):左为 traced 算子图,右为扩展 einsum 图;完整示例对应 Jamba 融合 attention 投影+残差,SOL≈0.06 ms(B200)。
局限:仅基于 shape 而非数值,无法刻画压缩 / 常量传播等值相关优化;实际硬件还可能因功耗墙 / 热节流达不到理论界。
4.3 指标:SOL Score
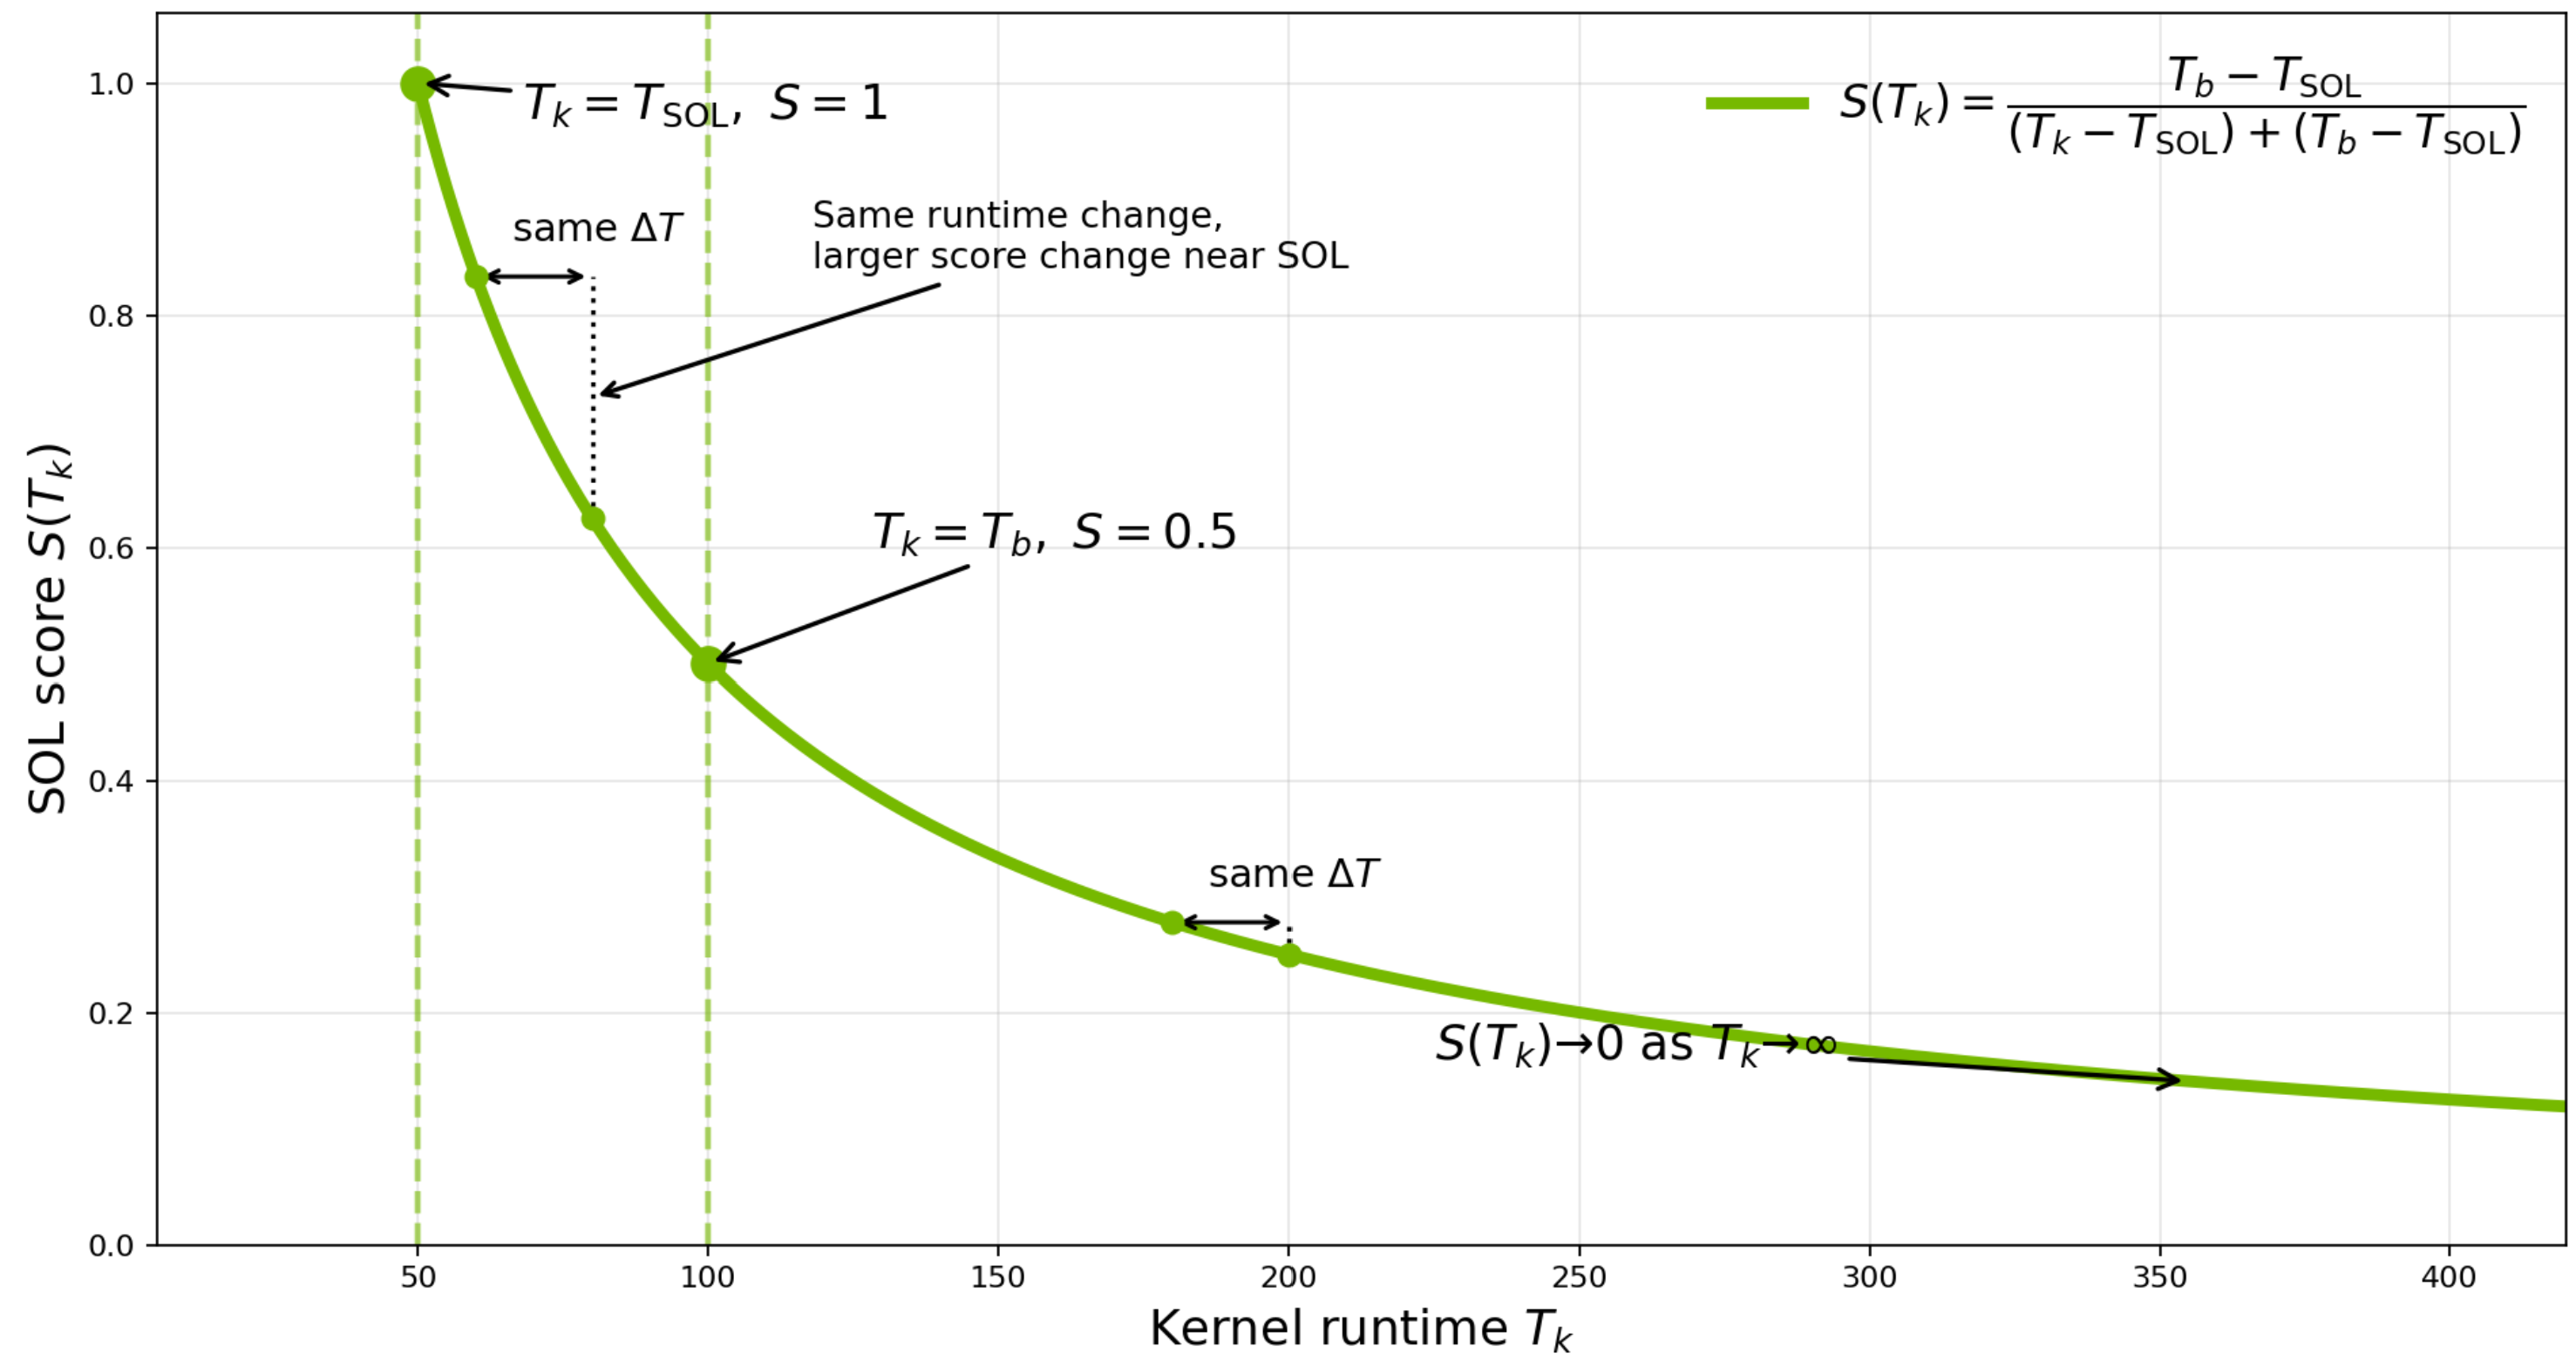
基线取中点而非零,是为在同一有界尺度上区分:低于基线(\(S<0.5\))、超基线但未到 SOL(\(0.5<S<1\))、SOL 水平(\(S=1\))。 不正确则正确性指示 \(C=0\),不计性能分。套件总分取算术平均:
4.4 评测框架与反刷分
提交为 JSON(源码、语言、构建、入口)。支持 Python / Triton / CUDA C++(含 PTX、CUTLASS、CuTe DSL、cuBLAS、cuDNN、cuTile)。 正确性:相对钉死的参考输出,多 seed;容差 (atol, rtol, matched ratio) 存在 workload 中。 计时:CUDA Event,10 warmup + 50 iter × 3 trial;每次清空 256MB L2、clone 输入;B200 锁 1500 MHz;子进程隔离;超时 300s。
观察到的刷分三类与防御见表 3:
| 类别 | 手段 | 防御 |
|---|---|---|
| 并发 | 线程 / 非默认 stream / jit.fork / CUDAGraph 隐式流 | 线程监控、禁多 stream、LLM 静态审查 |
| 状态缓存 | 按 data_ptr 复用输出、FakeTensor 懒计算、只过一次正确性 | 输入 clone、移位分配器、严格类型、多轮随机正确性 |
| 环境 | monkey-patch Event.elapsed_time、精度降级、内嵌 cubin | 关键函数地址校验、收紧容差、LLM-judge |
当前评测保守地禁用 CUDA streams、依赖 PyTorch 默认分配器——有利于防隐藏算力,但可能不利于复现
torch.compile 多流基线;未来或改进 stream 检查与分配器控制。
4.5 评分基线
评分基线 \(T_b\)(未公开)≠ 参考实现;由多轮多 agent、仅限 PyTorch 的优化系统生成, 经正确性 + 反刷分后取每题最快者。基线可随 SOTA 更新,保持挑战性。
5 实验
5.1 设置
DGX B200(8×B200,192GB HBM3e,8 TB/s);CUDA 13.1.1 / cuDNN 9.17.1 / PyTorch 2.9.0 / 驱动 580.95; 单卡、SM 锁 1500 MHz。
5.2 SOL Score vs Speedup
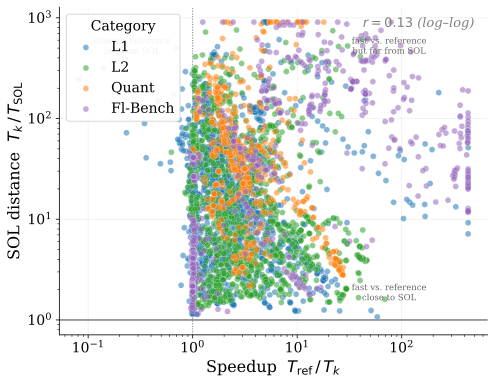
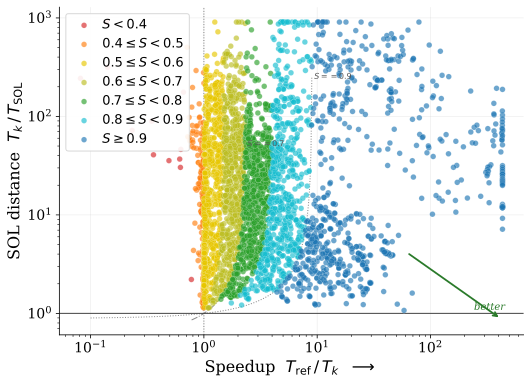
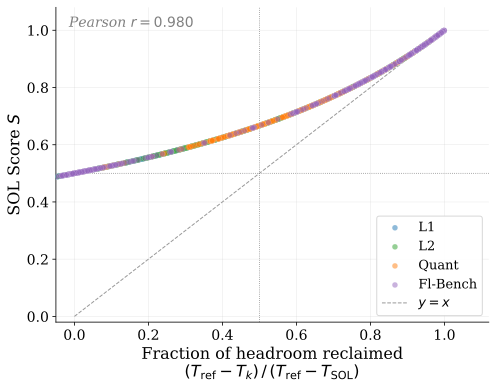
5.3 缓解 Reward Hacking
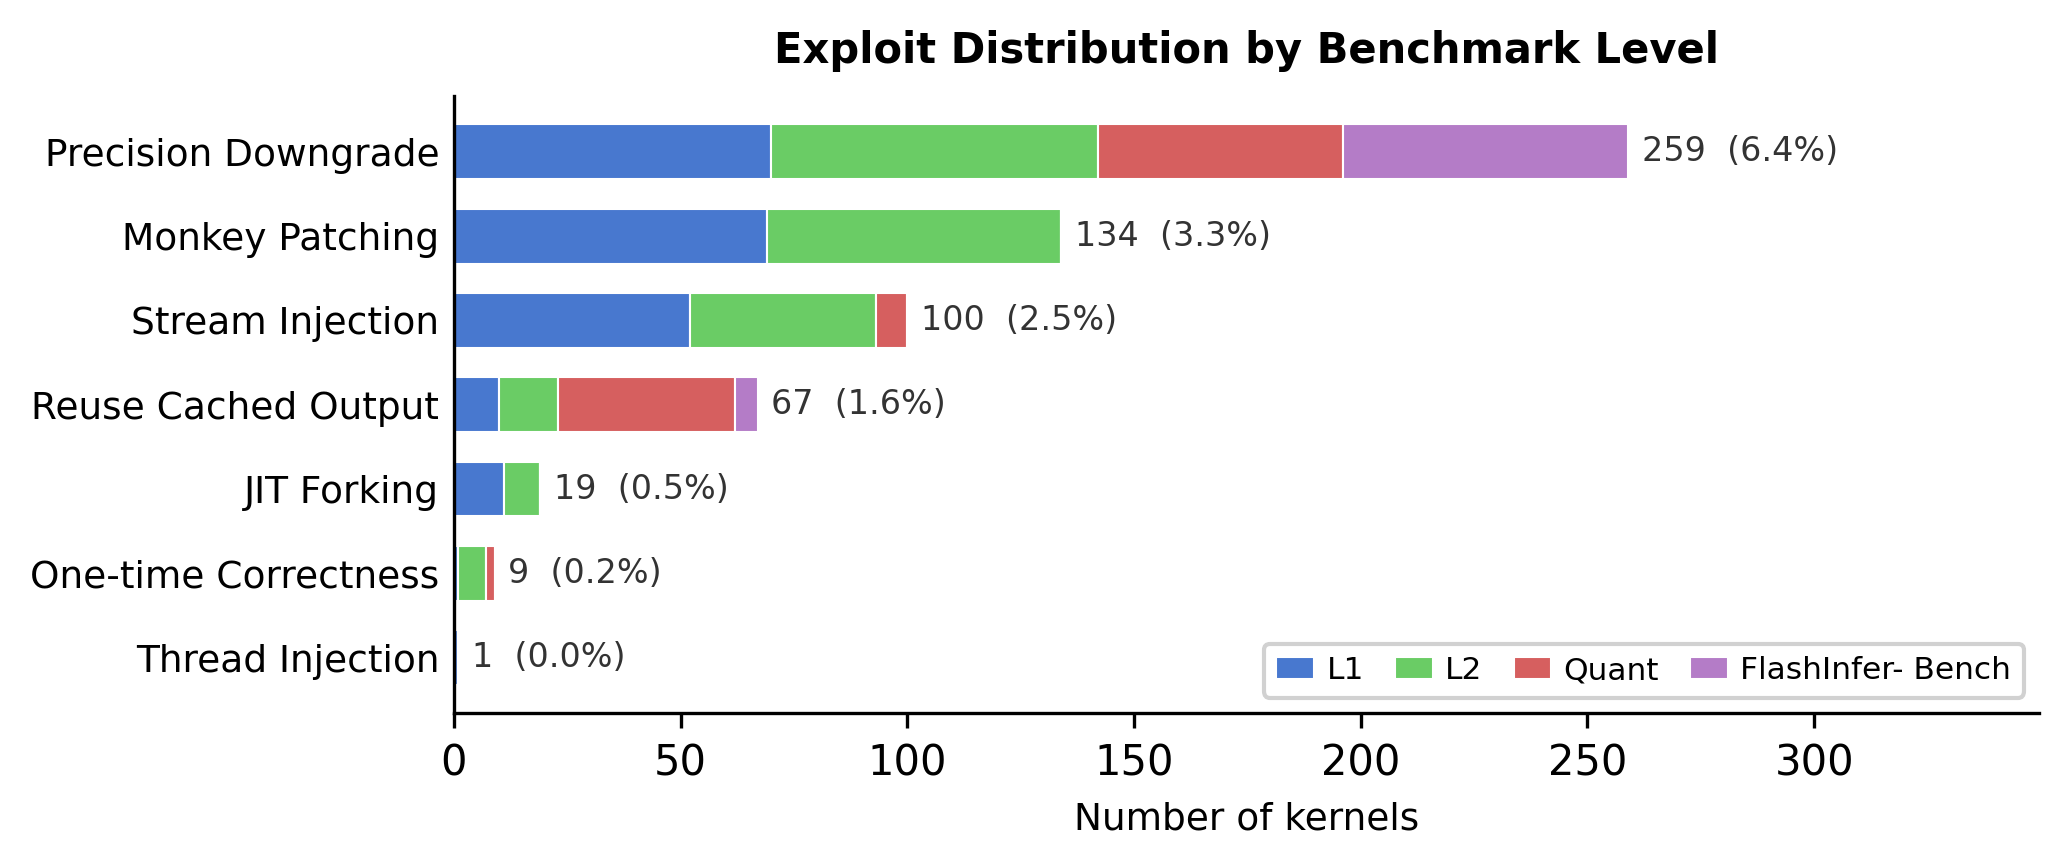
5.4 评分基线结果
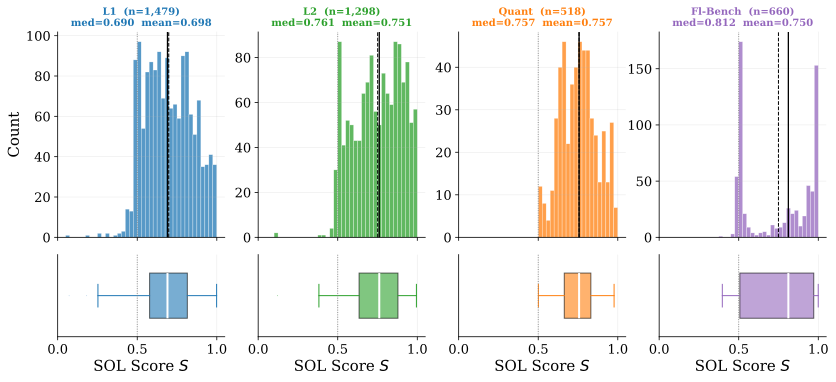
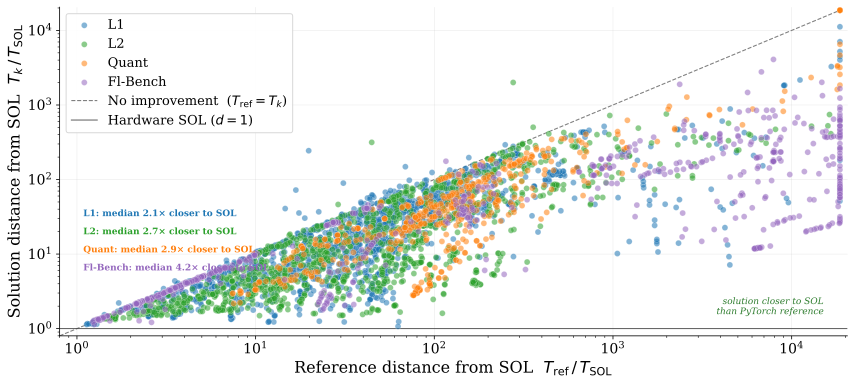
图 10:(a) 各类 SOL 分数分布:中位 L1 0.688 / L2 0.761 / Quant 0.757 / FIB 0.789,总体 0.732; (b) agent 解相对参考几乎全面更接近 SOL(中位距离缩短约 2.0–3.4×)。
6 结论
SOL-ExecBench 把 GPU kernel 优化基准锚定在硬件 Speed-of-Light:235 道来自 124 个前沿模型的题目、 SOLAR 解析上界、SOL Score 度量「关掉了多少基线→SOL 间隙」,以及针对 agent 刷分的评测沙箱。 Agent 基线中位分 0.732,说明仍有明显优化空间。作者期望基准随新工作负载、更强基线与社区提交持续演进。
参考文献(节选)
- Ouyang et al., 2025. KernelBench. ICML.
- Xing et al., 2026. FlashInfer-Bench. arXiv:2601.00227.
- Saroufim et al., 2025. BackendBench.
- Li et al., 2025. TritonBench. ACL Findings.
- Huang et al., 2024. Orojenesis / Mind the Gap. ISCA.
- Williams et al., 2009. Roofline. CACM.
- 完整列表见 原文 PDF。