MegaScale:把大语言模型训练扩展到一万张以上 GPU
MegaScale: Scaling Large Language Model Training to More Than 10,000 GPUs(arXiv:2402.15627)中文译本
原文 PDF:arxiv.org/pdf/2402.15627 · HTML:arxiv.org/html/2402.15627 · 代码:github.com/volcengine/veScale
原文:arXiv:2402.15627 · ByteDance & Peking University。并列一作:Ziheng Jiang、Haibin Lin、Yinmin Zhong;通讯:Xin Jin、Xin Liu。本页为忠实于原意的中文编译(意译与精炼为主),图表优先使用原文嵌入图;部分矢量示意图以 PDF 页渲染保留排版。数值与结论以原文为准。
摘要
本文介绍生产系统 MegaScale 的设计、实现与工程经验:在超过 10,000 张 GPU 的规模上训练大语言模型(LLM)。如此规模带来训练效率与稳定性的双重挑战。作者采取全栈协同设计:算法与系统在模型块与优化器、计算-通信重叠、算子优化、数据管线与网络调优等环节共同发力。
对生产而言,在长达数周的 LLM 训练中持续保持高效率(稳定性)尤为关键。许多难题只在大规模才出现,深度可观测性是关键。团队构建了一套诊断工具,监控栈深处的组件与事件、定位根因,并形成容错与拖尾缓解技术。在 12,288 GPU 上训练 175B 模型时,MegaScale 达到 55.2% MFU,相对 Megatron-LM 提升 1.34×。文中亦分享故障与拖尾的运维经验,希望从系统视角启发后续 LLM 系统研究。
1 引言
LLM 已成为 AI 的变革性技术。Scaling law 表明模型规模与训练数据规模决定能力上限;为达到 SOTA,业界在海量 token 上训练千亿甚至万亿参数模型(如 GPT-3 175B、PaLM 540B),并建设上万卡 AI 集群。
把训练扩展到数万 GPU 带来前所未有的挑战。相对 ResNet 等数十到数百卡任务,LLM 单作业独占上万卡。系统视角有两大难题:
- 规模化高效率:MFU(Model FLOPs Utilization)衡量相对峰值算力的有效吞吐。LLM 训练并非易并行——模型切分后 GPU 间通信密集;算子、数据预处理与显存同样显著影响 MFU。
- 规模化高稳定性:训练可持续数周。故障与拖尾是常态而非例外。单点拖尾会拖慢整作业上万卡。
MegaScale 遵循两条原则:算法–系统协同设计与深度可观测性。算法侧引入并行 Transformer block、滑动窗口注意力、LAMB 等;并行侧组合 DP/PP/TP/SP 并按模式最大化计算-通信重叠;数据管线预取与树状加载;集合通信初始化去全局屏障;网络侧定制拓扑、降低 ECMP 冲突、定制拥塞控制与重传超时。稳定性上构建心跳异常检测、诊断用例、优化 checkpoint/恢复,以及分布式时间线热力图与 3D 并行可视化。
部署结果:标准 175B Transformer、12,288 GPU 上 MFU 55.2%,相对开源 Megatron-LM 提升 1.34×;真实生产中数百亿参数、数万亿 token、数周训练中损失持续收敛,并在故障下修复恢复百余次。相关组件开源进展见 veScale。
2 背景
LLM 训练依赖多种并行策略跨设备分布计算。
数据并行(DP)与 ZeRO。复制模型,按数据切分;迭代末同步。ZeRO 将优化器状态、梯度、参数分片到各 DP 进程,传统 all-reduce 拆为 reduce-scatter + all-gather。常采用 ZeRO-2(分片优化器状态与梯度,不额外增加通信)。
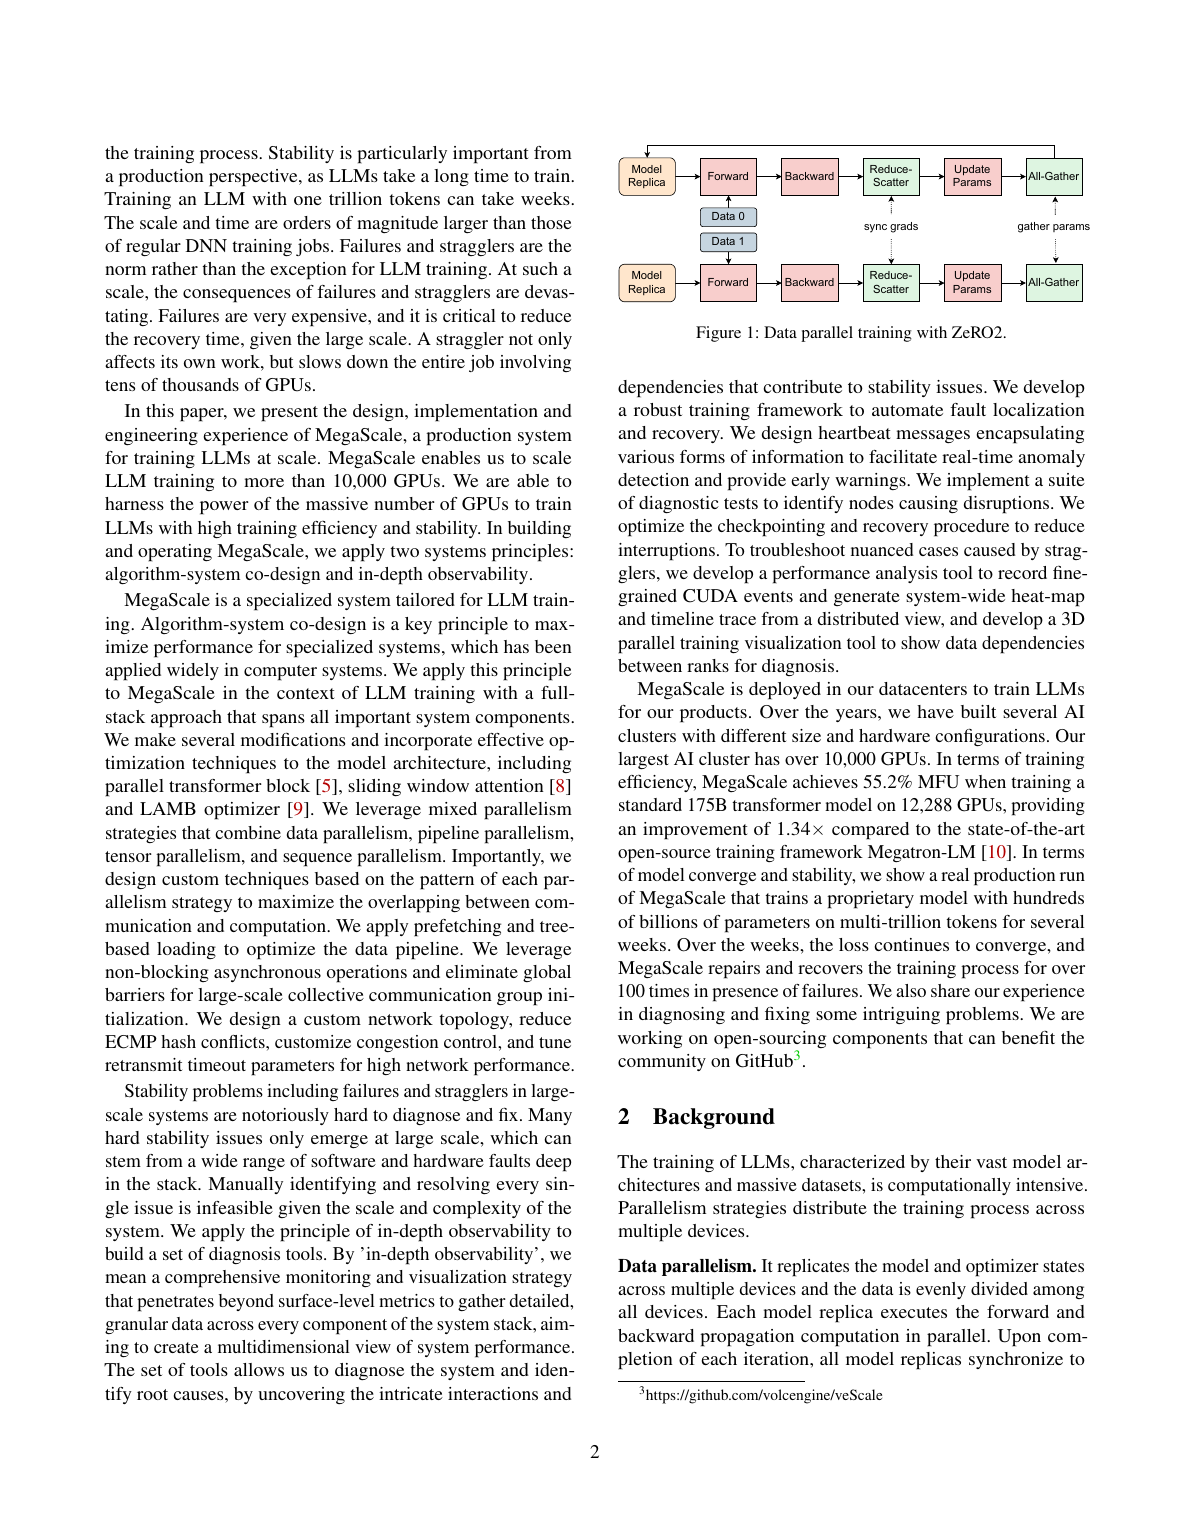
图 1–2 相关示意(原文 PDF 排版页):ZeRO-2 数据并行与交错 1F1B 流水线。
流水线并行(PP)。按层切分设备,batch 再切 micro-batch。调度包括 GPipe、PipeDream 1F1B 等;Megatron-LM 常用交错 1F1B:每阶段再分虚拟阶段(model chunk),经历 warm-up、稳态 1F1B、cool-down。
张量并行(TP)与序列并行(SP)。把算子(如 Attention/MLP 中的 GEMM)切到多卡;LayerNorm/Dropout 等算力轻但激活显存大,可沿序列维做 SP 以省显存。
3D 并行组合。TP 通信开销大,宜限制在节点内;DP/PP 更适合跨节点。实践中优先构建 DP 组以减轻跨 pod 通信。
3 规模化高效训练
3.1 算法优化
并行 Transformer block。将标准串行形式
改为
使 Attention 与 MLP 可并行,缩短计算时间;既往工作表明对千亿参数模型质量影响可接受。
滑动窗口注意力(SWA)。复杂度 \(O(s\cdot w)\),当 \(w\ll s\) 时优于全注意力 \(O(s^2)\);堆叠窗口层可保持大感受野。
LAMB 优化器。支撑更大 batch。交错 PP 下,将 1× batch 训四步改为 4× batch 训一步,可显著削减 pipeline bubble(原文给出约 87.5% 的 bubble 减少)。
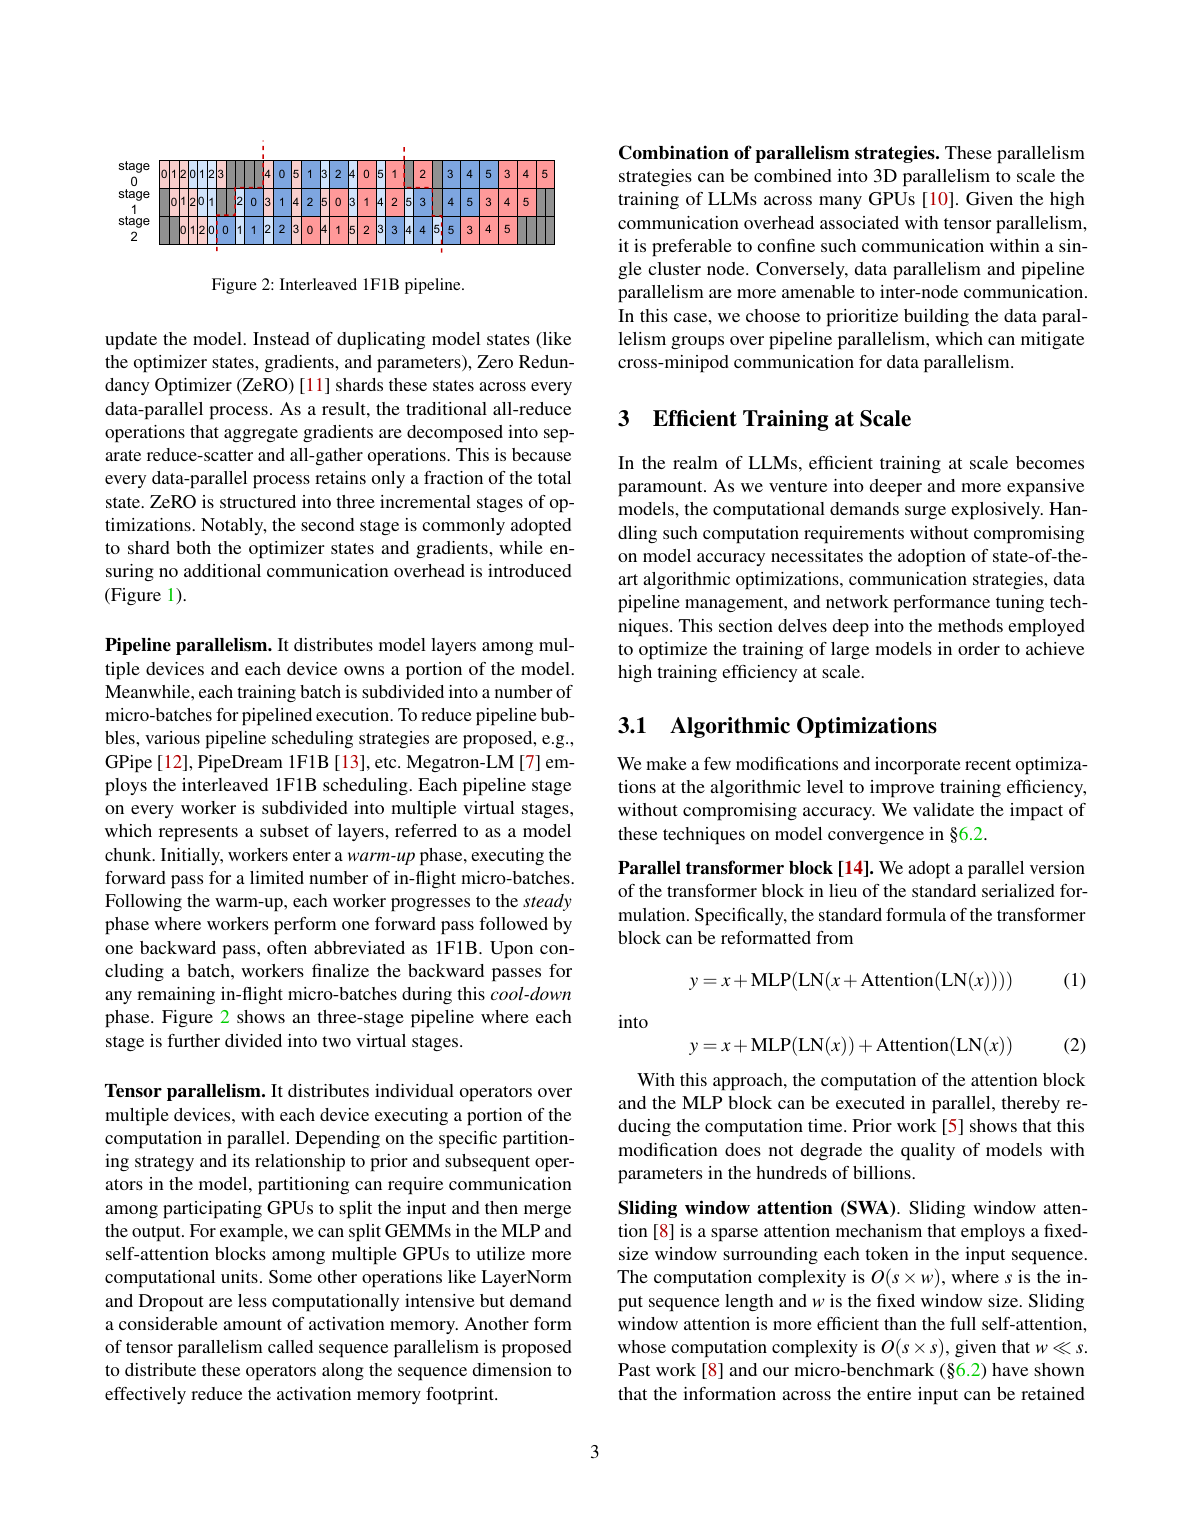
图 3:在并行 Transformer block 下,张量/序列并行的通信与 GEMM 重叠(原文页)。
3.2 3D 并行中的通信重叠
DP:前向依赖 all-gather 最新参数,反向 reduce-scatter 梯度。按 model chunk 重叠;首个 all-gather 可与数据加载预取重叠,通信时间约降为 \(1/(2\cdot vpp\_size)\);按依赖顺序优先高优先级通信。
PP:点对点 send/recv。Warm-up 阶段前向只依赖先前 recv,可将 send/recv 解耦使 send 与计算重叠;稳态阶段前后向相对邻近通信独立,可异步发射。
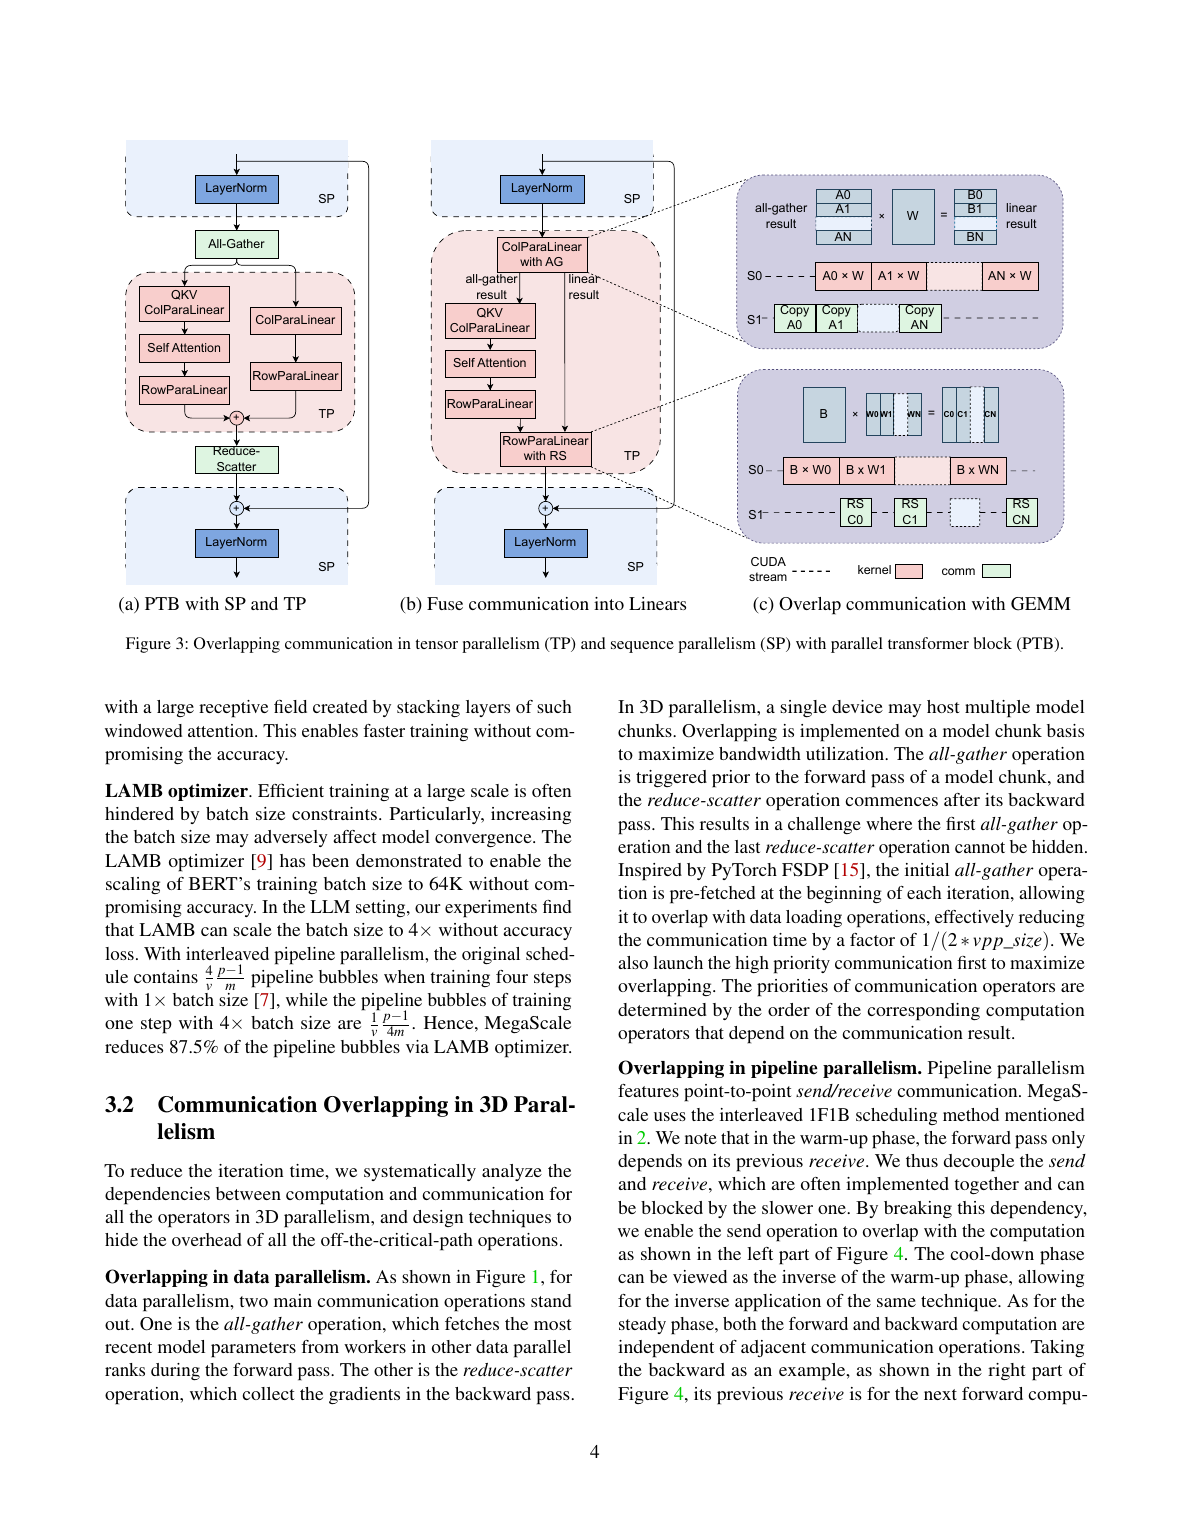
图 4:流水线并行中的通信重叠(原文页)。
TP/SP:关键路径上的 all-gather/reduce-scatter 可与 FFN 路径较大 GEMM 融合并分块流水,从而隐藏通信;反向类似。
3.3 高效算子
Attention 采用 FlashAttention-2;LayerNorm、GeLU 等细粒度核融合,减少启动开销并改善访存。
3.4 数据管线
预处理与加载常在每步开头造成 GPU 空闲。MegaScale 通过预取与树状加载等降低该空泡。
3.5 网络与集合通信
定制网络拓扑、降低 ECMP 哈希冲突、定制拥塞控制与重传超时;大规模进程组初始化采用非阻塞异步、消除全局屏障,避免上万卡启动被同步拖死。
4 容错
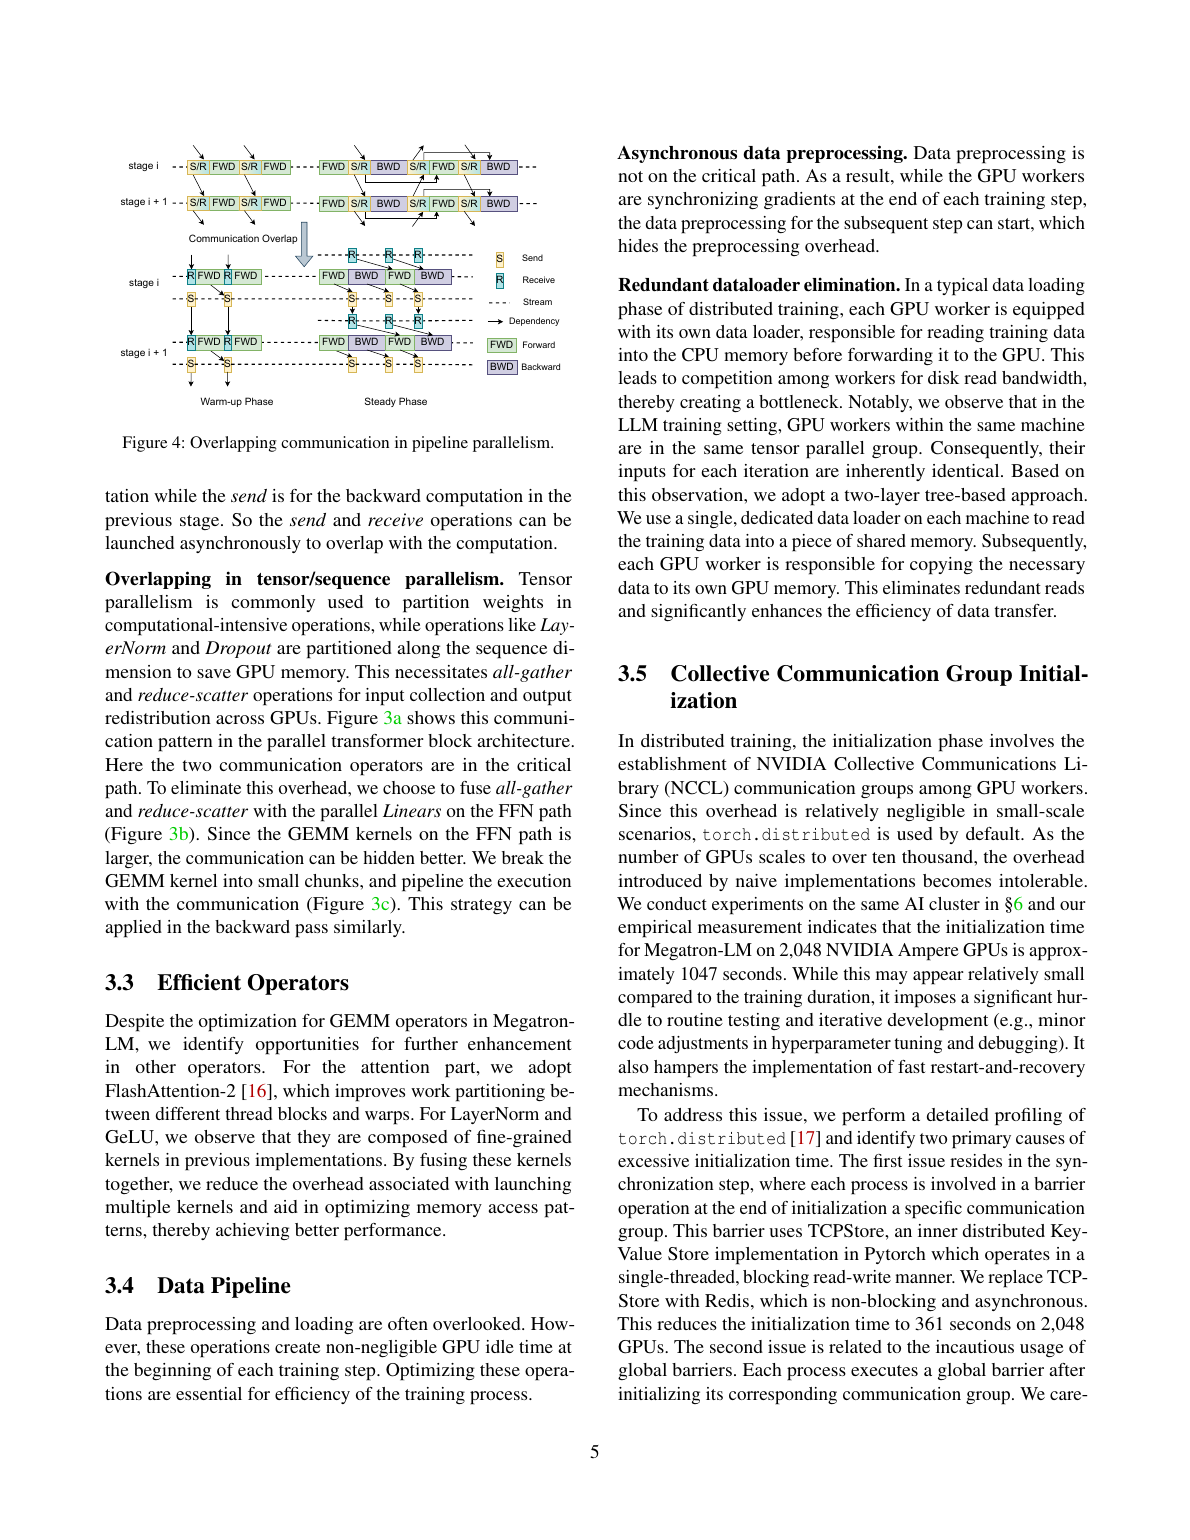
图 5:稳健训练工作流(原文页)。
大规模故障定位困难。MegaScale 构建稳健训练框架:心跳携带多维信息以实时异常检测与预警;诊断用例识别“毒节点”;优化 checkpoint 与恢复以缩短中断。目标是自动化故障定位与恢复,使周级训练可承受上百次修复。
5 训练排障
细粒度拖尾难以靠粗指标发现。团队开发性能分析工具,记录细粒度 CUDA 事件,生成集群热力图与统一时间线;并用 3D 并行可视化展示 rank 间数据依赖。
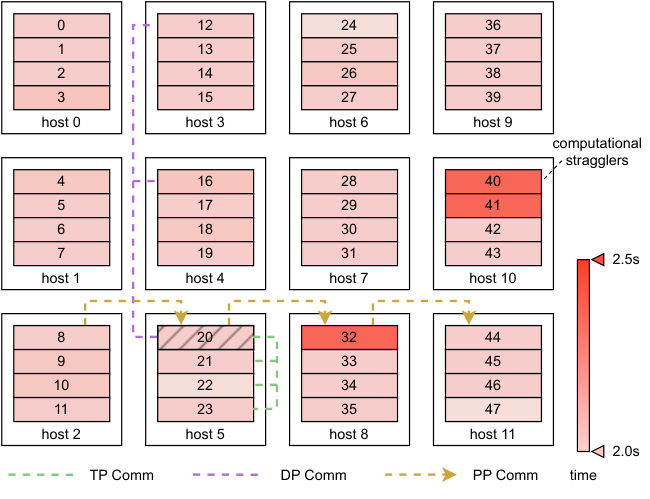
图 7:性能热力图。颜色表示运行时间;可见计算拖尾与流水线依赖导致的等待。
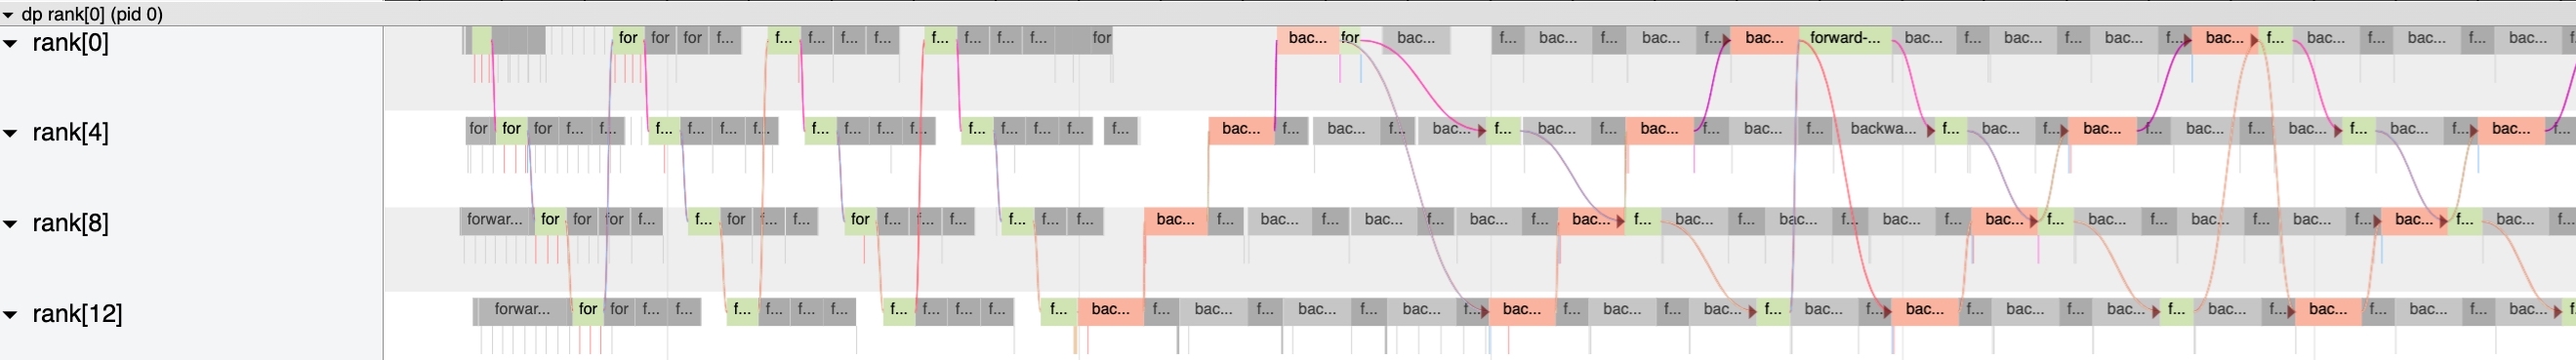
图 8:流水线组内事件统一时间线;选中事件可看到依赖关系。
大规模训练中还观察到 MFU 不一致(图 6,见原文);结合热力图与追踪可区分计算拖尾、通信异常与依赖放大。
6 经验
6.1 效率与扩展性
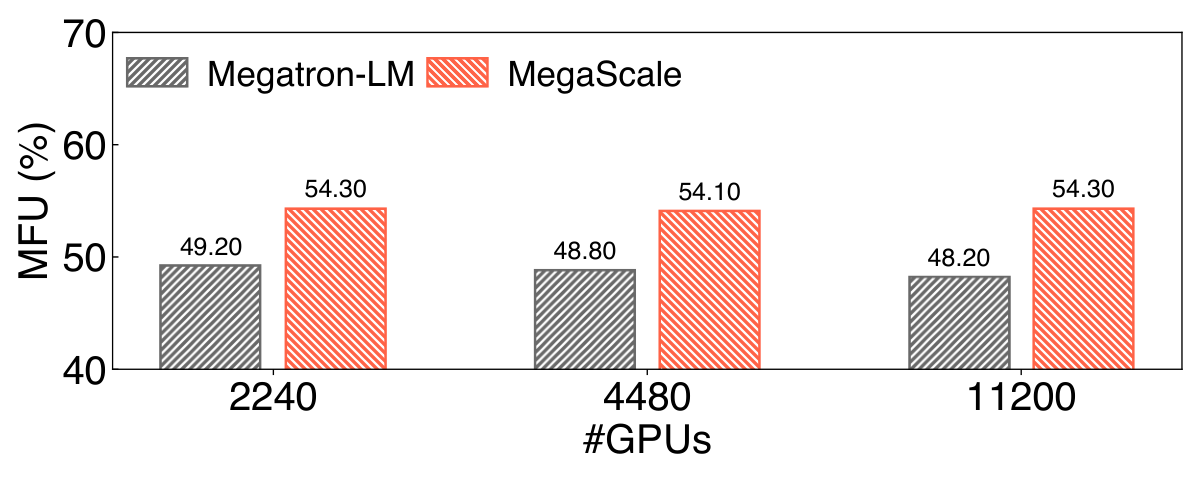
图 9:Megatron-LM 与 MegaScale 的弱扩展训练性能(MFU vs GPU 数)。MegaScale 在 2240–11200 GPU 上 MFU 更稳、更高。
在 12,288 GPU、175B 设定下达到 55.2% MFU,相对 Megatron-LM 约 1.34×。消融表明算法改造、通信重叠、算子与网络优化逐项抬升 MFU。
6.2 收敛与生产稳定性
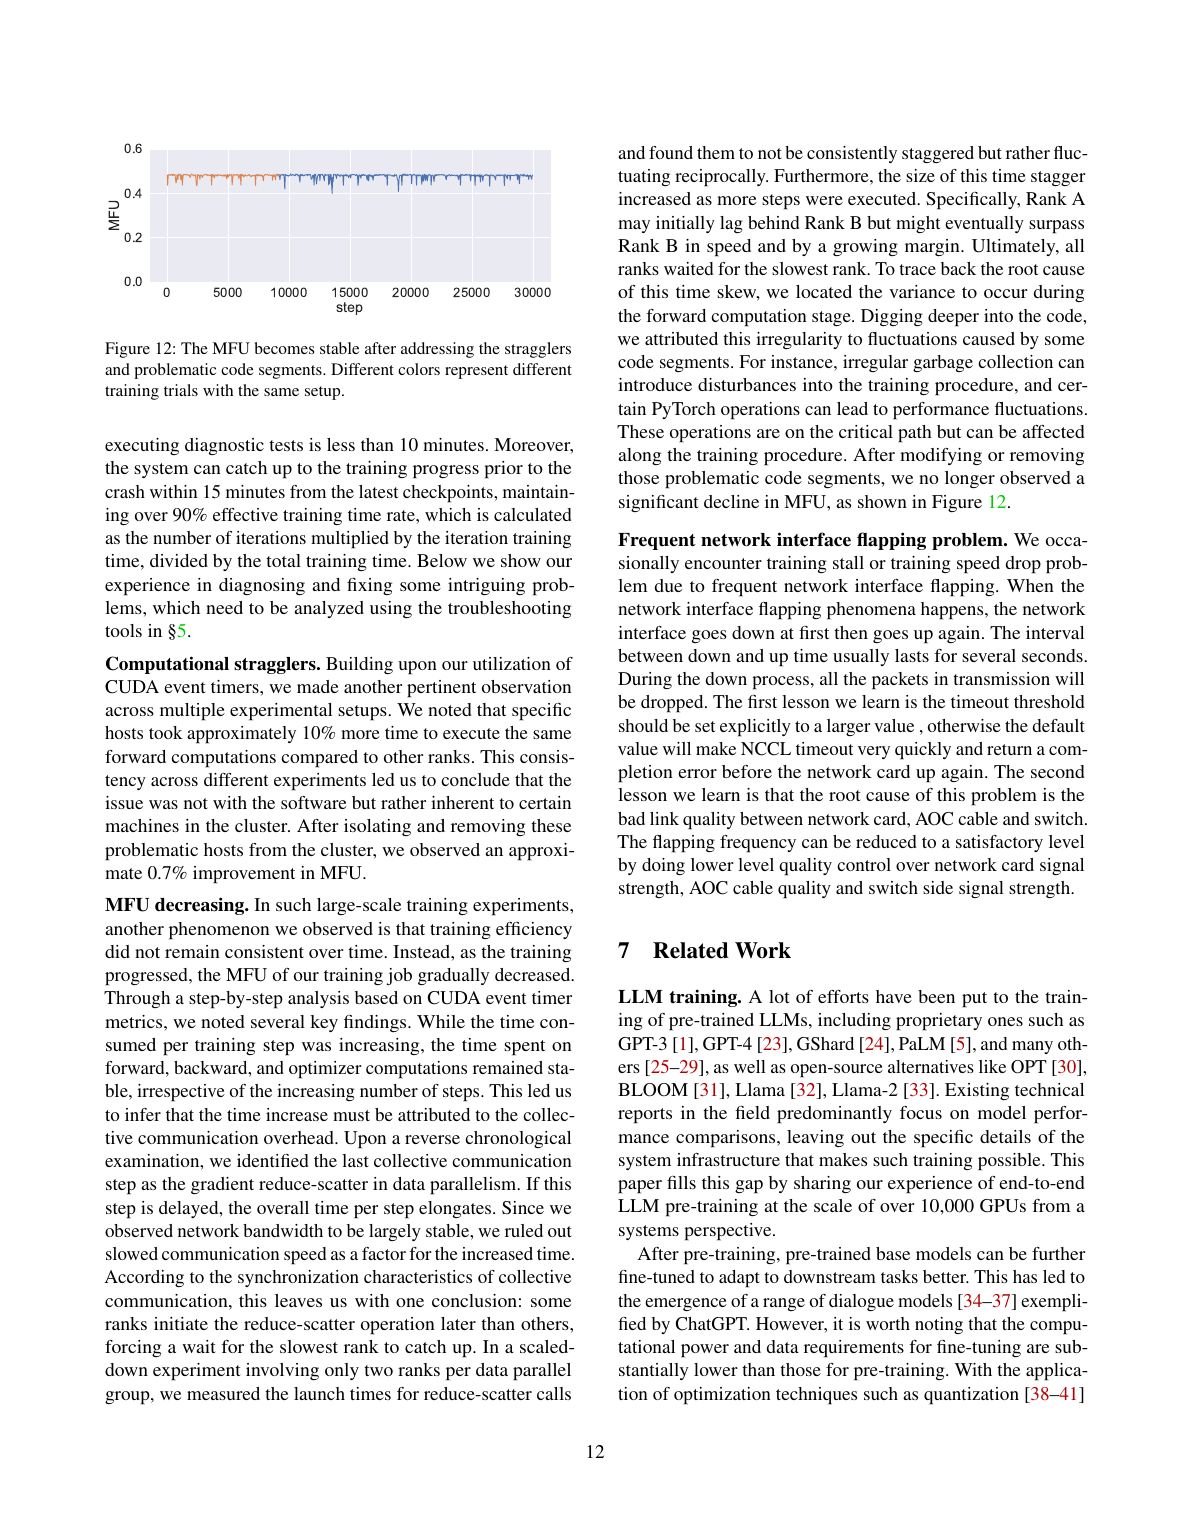
图 10–11 相关:微基准损失曲线与真实万卡级生产训练损失(原文页)。
微基准验证并行 Transformer、SWA、LAMB 等对收敛的影响可接受。真实生产:数百亿参数、数万亿 token、数周、>10,000 GPU,损失持续下降;期间自动修复恢复百余次。
图 12:治理拖尾后 MFU 趋于稳定(原文页)。
6.3 运维故事线(摘要)
- 网络哈希冲突与链路异常导致间歇性吞吐塌陷 → 拓扑/ECMP/拥塞控制协同。
- 个别节点 CUDA/驱动异常表现为“算力拖尾” → 心跳 + 诊断用例隔离替换。
- Checkpoint 过慢放大故障影响面 → 异步/分层 checkpoint 与更快恢复路径。
3.4 数据管线(补充)
- 异步预处理:梯度同步期间可启动下一步预处理,隐藏开销。
- 消除冗余 DataLoader:同机 TP 组输入相同,采用两层树:每机一个专用 loader 读入共享内存,各 GPU 再拷入显存,避免争抢磁盘带宽。
3.5 集合通信组初始化
默认 torch.distributed 在小规模可接受,但到两千卡以上初始化极慢(原文测 2048 Ampere 约 1047s)。剖析后两点:
- 组初始化末尾 barrier 走单线程阻塞的 TCPStore → 换 Redis 异步后降至约 361s。
- 不必要的全局 barrier,复杂度近 \(O(n^2)\) → 调整初始化顺序后到 \(O(n)\)。2048 卡 <5s,万卡级 <30s。
3.6 网络性能调优
- 拓扑:Tomahawk 4、CLOS 类三层,上下行 1:1,小直径高带宽。
- 降低 ECMP 冲突:ToR 400G 拆双 200G、八网卡多轨上联不同交换机;重通信节点尽量同 ToR。
- 拥塞控制:融合 Swift 与 DCQCN,RTT + ECN,减轻 PFC/HoL。
- 重传:调 NCCL 超时/重试,启用 NIC
adap_retrans应对链路抖动。
4.1–4.4 容错细节
Driver + 定制 Kubernetes:每节点 executor + 稳健训练 daemon 心跳。异常或心跳超时 → 全员暂停自检 → 驱逐故障节点并补健康节点 → 从最近 checkpoint 恢复。
- 心跳内容:基础硬件信息、训练状态、stdout/stderr 关键字、RDMA 流量(周期训练下流量应规律,骤降/停流即告警或自动恢复)。毫秒级监控看拥塞与并行传输是否顶满。
- 自检:主机内 loopback / RNIC 全互测;节点内 GPU all-to-all;同 ToR 邻机 all-reduce。
- 两阶段 checkpoint:① GPU→主机 pinned 内存(秒级,少挡训练);② 后台异步刷 HDFS。恢复时同 DP 组只由一员读 HDFS 再 broadcast,缓解读带宽瓶颈。
6.1 性能表摘录
表 1:175B(Heads 128, Hidden 12288, Layers 96, TP8, PP8);530B(160 / 20480 / 105, TP8, PP35)。
| Batch | 方法 | GPUs | Iter (s) | 吞吐 (tok/s) | MFU |
|---|---|---|---|---|---|
| 6144 | Megatron-LM | 12288 | 8.57 | 1466.8k | 41.2% |
| 6144 | MegaScale | 12288 | 6.34 | 1984.0k | 55.2% (1.34×) |
| 768 | Megatron-LM | 1024 | 11.9 | 132.7k | 44.7% |
| 768 | MegaScale | 1024 | 8.9 | 176.9k | 59.0% (1.32×) |
表 2 节选:175B 强扩展;训练 300B tokens 的时间等完整数据见原文。
| # | 配置 | MFU(Δ) |
|---|---|---|
| 1 | baseline Megatron-LM | 47.7% |
| 2 | + PTB | 52.3% (+4.6) |
| 3 | + SWA | 53.3% (+5.6) |
| 4–6 | + TP/PP/DP overlap | 59.5% (+11.8) |
| 7 | + 高效算子 | 61.2% (+13.5) |
| 8 | + 杂项 | 62.3% (+14.6) |
| 9 | + LAMB(BS×3) | 65.3% (+17.6) |
表 3:256 GPU、BS=256 上 MFU 消融(网络优化对两边均开启)。
6.3 问题案例
- 计算拖尾机:约 0.5% 主机前向慢 ~10%,剔除后 MFU +0.7%。
- MFU 随时间下滑:前后向时间稳定,根因是某些 rank 更晚进入 DP reduce-scatter;追踪到前向阶段 GC/部分 PyTorch 操作抖动。清理后 MFU 稳定(图 12)。
- 网卡频繁 flapping:显式加大 NCCL 超时;根因是光模块/线缆/交换机信号质量,通过底层质控降低频率。
7 相关工作
与 GPT/PaLM 等技术报告侧重模型效果不同,本文补齐万卡预训系统基建细节。微调/量化/LoRA 算力远低于预训。效率方向还包括稀疏/线性注意力、RWKV/RetNet、梯度压缩与更多通信重叠工作。诊断工具谱系含 Pingmesh、EverFlow、LossRadar、NetBouncer、Hostping 等;容错则涵盖 Retry/Replication/Checkpoint/Message Logging 与预迁移等。MegaScale 的特点是把这些能力接到 LLM 3D 并行训练的生产闭环里。
与 Megatron-LM、DeepSpeed、PaLM/GPT 训练系统等工作相比,MegaScale 强调生产万卡下的全栈效率与稳定性工程,以及面向拖尾/故障的深度观测工具链。算法并行策略与前述系统同源,差异在于规模化工程化与诊断闭环。
8 结论
MegaScale 展示了在超过一万张 GPU 上训练 LLM 的生产路径:算法–系统协同设计抬升 MFU,深度可观测性与自动化容错支撑周级稳定运行。作者希望问题表述与经验能推动后续 LLM 系统研究;组件开源见 veScale。
致谢与参考文献见原文 PDF。本译本未逐条翻译全部参考文献列表。