DeepInfer 代码导读:DeepSeek V4.1 大规模推理引擎
读
deepseek-ai/DeepInfer
源码与仓库内
doc/inference_deployment_qa.md
后的结构化笔记。本地对照的是 2026-10-24 的 checkout(约 5.5 万行 Python、6 千行 C++)。
1. 它解决什么问题
部署问答把目标写得很直:在多厂商加速器上,用普通 8 卡机器做 Prefill、用 64–128 卡超节点做 Decode, 并把 KV cache 留住超过 72 小时,让命中前缀时不必重做 Prefill。吞吐和延迟同时要,靠的是两件事叠在一起:
- MoE 用专家并行(EP),把 batch 做大,提高矩阵乘效率。
- 视觉编码 / Prefill / Decode 拆开部署,TTFT 和 TBT 分开控资源。
Attention 侧沿用 V3/R1 的做法:DP 数等于 EP 数。请求协议和 token 序列之间的转换不在这个仓库, 而在另外开源的 deepseek-recipe。
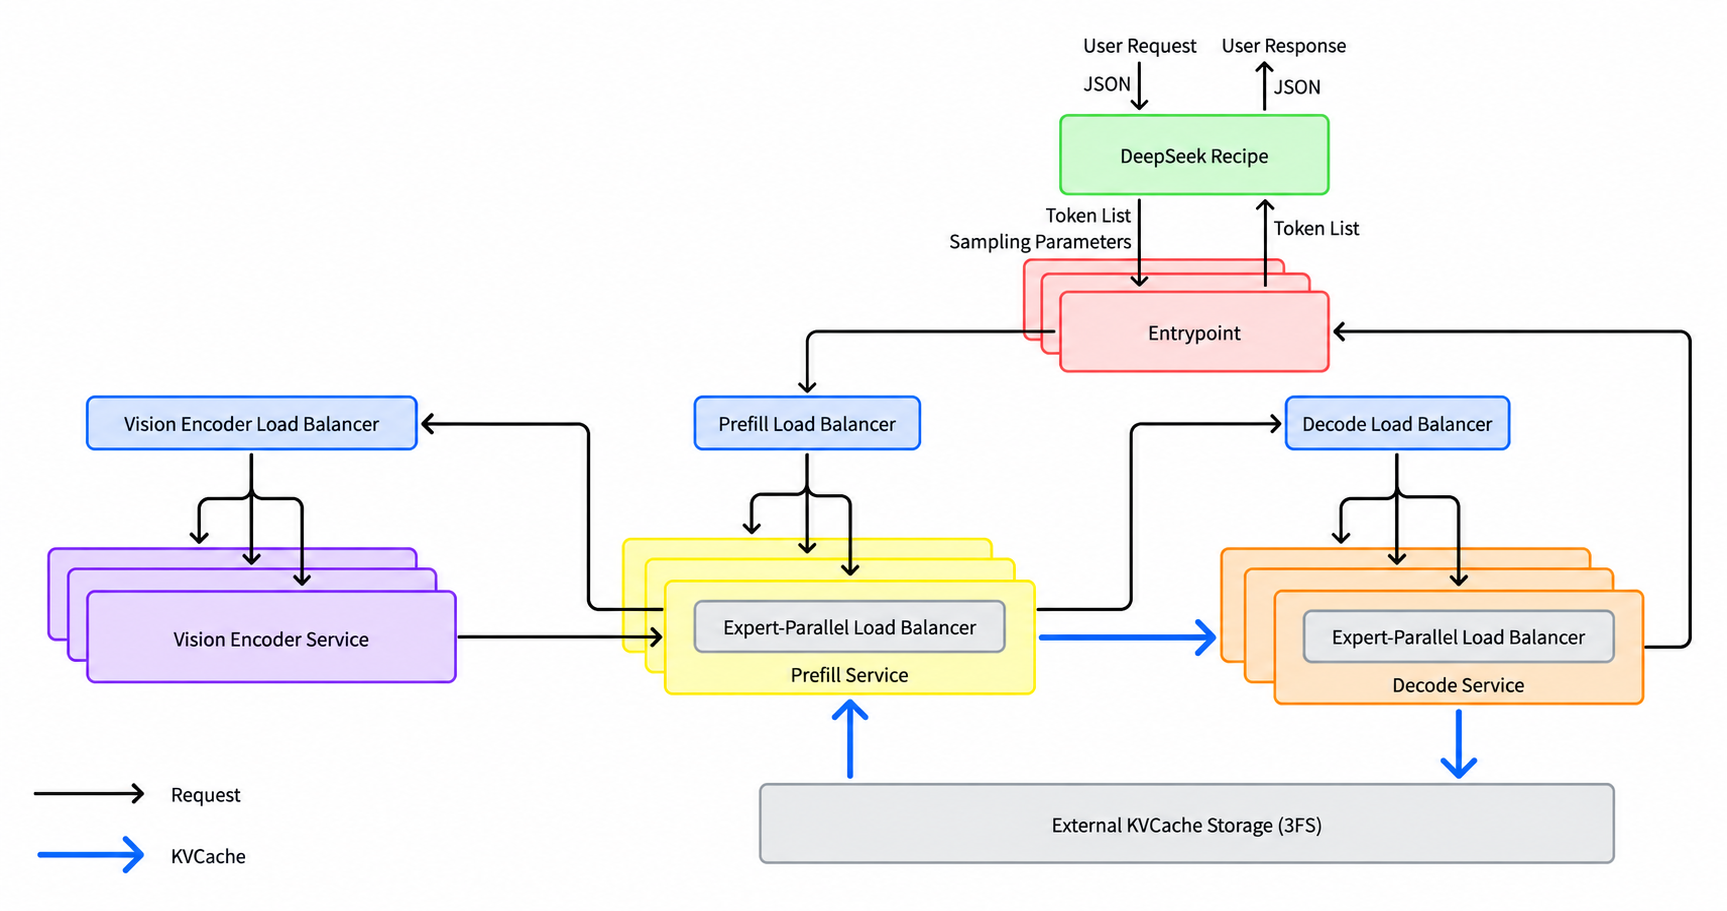
doc/images/architecture_overview.png。图里的负载均衡和 3FS 存储是生产系统的形状;
开源代码实现的是图中间的引擎。
2. 开源了什么,钩子留在哪
对外入口是 deepinfer/entrypoints/llm.py 的 LLM.generate()。
LLMEngine 的文档写明:这一版没有在线服务封装。
引擎类型已经按分离部署切好(deepinfer/engine/engine_type.py,与
csrc/engine/scheduler.hpp 的枚举对齐):
| EngineType | 职责 |
|---|---|
NORMAL |
同一实例既做 prompt 也做 completion,离线例子走这条 |
PROMPT |
只做 Prefill;step() 里断言不会进入 decode |
COMPLETION |
只做 Decode |
PD 分离和 KV 落盘在 llm_engine.py 里是一组空的虚函数:
init_pd_split、do_save_kvcache、pe_do_save_kvcache、
send_processed_prompts。调度主循环会调用它们,生产实现不在这个仓库。
问答里描述的 3FS、入口点前缀匹配、GDR swap-in、DP 负载均衡,都要对照文档理解,不能在代码里找到完整实现。
3. 代码怎么分层
flowchart TD
  llm["entrypoints/llm.py
LLM.generate"] --> eng["engine/llm_engine.py
step 主循环"]
  eng --> sched["csrc/engine
Scheduler / BlockManager"]
  eng --> worker["worker/
每卡一个 Worker"]
  worker --> runner["model_runner + CUDA Graph"]
  runner --> model["models/deepseek.py
v4_modules"]
  model --> kernels["tilelang_ops/{cuda,asc}
+ vendor FlashMLA / DeepGEMM / DeepEP"]
| 路径 | 作用 |
|---|---|
deepinfer/engine/ |
引擎主循环、统计日志、profile HTTP 服务。约 2 千行 |
csrc/engine/ |
C++ 调度器、block 管理、序列状态、采样准备,pybind 给 Python |
deepinfer/worker/ |
模型执行、KV/state cache、CUDA Graph、DFlash graph runner |
models/v4_modules/ |
MLA、index attention、MoE、KV 压缩、YOCO、Engram、mHC |
models/mtp/dflash.py |
投机解码的 draft 模型 |
models/vision_encoder/ |
多模态 ViT 与 aligner |
layers/tilelang_ops/ |
约 2.5 万行 TileLang 算子,cuda/ 与 asc/ 各一套 |
model_executor/eplb/ |
冗余专家放置与专家权重重分布 |
structure_output/ |
基于 xgrammar 的正则 / JSON Schema / EBNF 约束 |
deep_cluster/ |
识别 NVIDIA / Ascend,做 CPU 与 NUMA 绑核 |
vendor/ |
子模块:FlashMLA、DeepGEMM、DeepEP、DeepSelect,后三个有昇腾对应仓库 |
目前模型注册只认 DeepSeek-V4.1-Flash。它最初长在 vLLM 上,也吸收了 SGLang 和 TensorRT-LLM 的做法, 但对外不是通用 serving 框架。
4. 一步推理在做什么
LLMEngine.step() 的顺序:
- C++
scheduler.schedule()选出本步序列,并给出要 clone / zero 的 state 与 block。 post_schedule:Prefill 最后一块若开了结构化输出,在这里把 grammar matcher 挂上,状态不对就当步杀掉该请求。- Decode 步里按
should_copy_state异步拷状态(生产上用来准备 KV 落盘;开源实现默认不拷)。 - 多模态进程把图像预处理结果取回;坏图直接 abort 对应请求。
execute_model_step下发到各 worker:forward、sample,返回RequestOutput池里的句柄。句柄默认下一步释放,要留住必须clone。
离线例子在 examples/offline_inference.py:--ep / --dp / --cp
组网,默认模型 deepseek-ai/DeepSeek-V4.1-Flash-1017。
examples/benchmark.py 把 Prefill 和 Decode 的计时拆开,Decode 吞吐按「满接受」记账:
每请求每步 1 + nextn 个 token。
5. 并行:DP、CP、Wide-EP
Attention 走数据并行;可选上下文并行(model_executor/parallel_utils/cp.py),
--cp 必须整除 EP。MoE 走专家并行,并用 EPLB 把热专家复制到各卡的冗余槽里。
- Prefill:EP2–8 / DP2–8,在显存放得下的前提下尽量小。冗余专家从每卡 4 个起,100 步统计、1000 步重分配。EP4 实测
moe_lb(最慢 rank / 均值)约 1.074。 - Decode:EP64–128。冗余专家从每卡 1 个起,再向上取整到能被
ep_size整除。1000 步统计、10000 步重分配。moe_lb约 1.090。 - 视觉编码:单卡实例即可,问答建议用更便宜的卡。
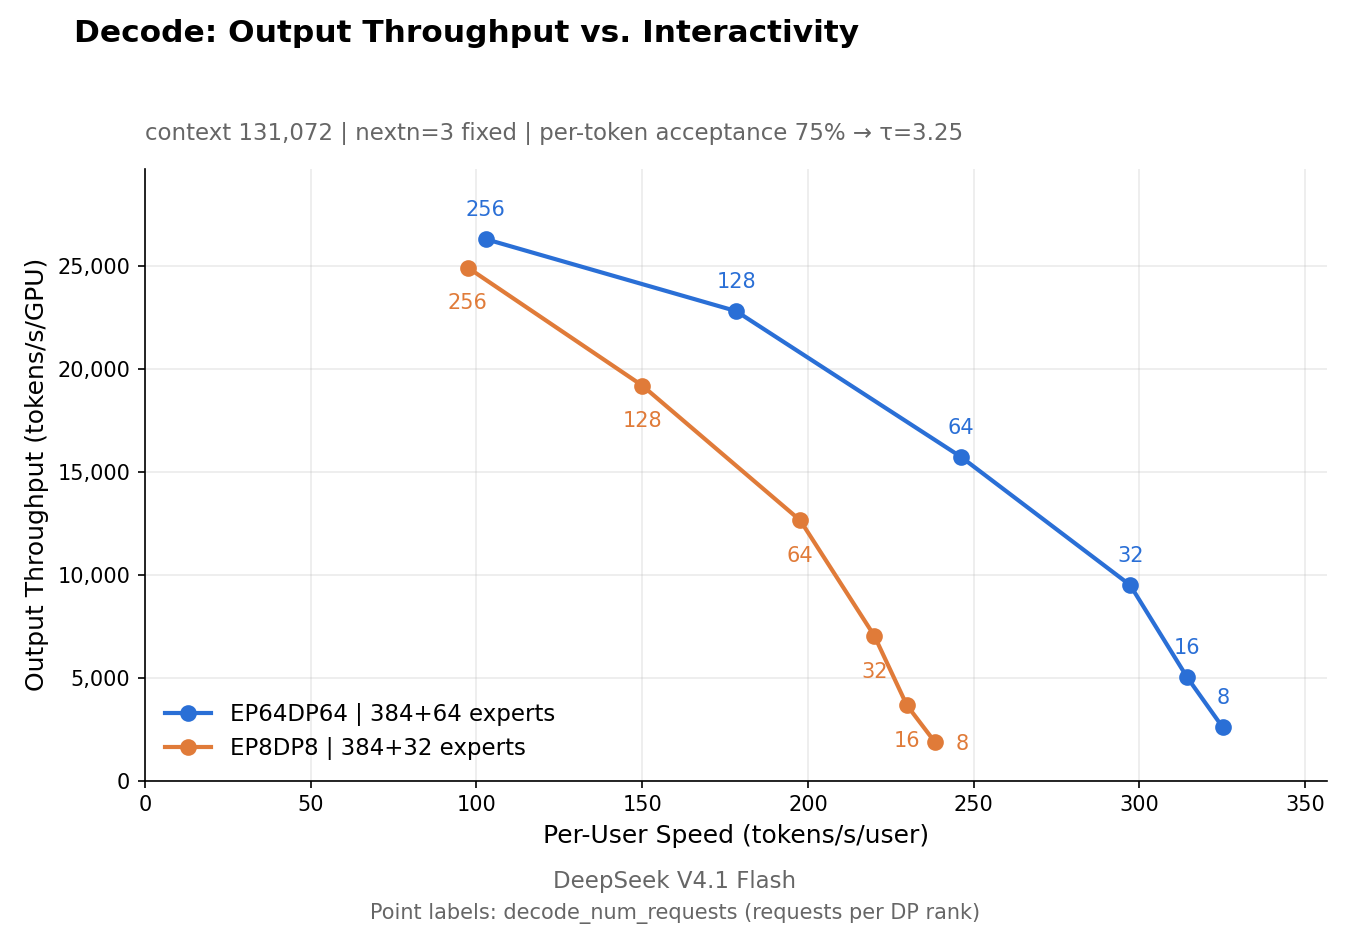
doc/images/wide_ep_decode_pareto.png。Wide-EP 压的是 MoE 专家部分每步的显存流量。
问答给出的最小高效部署大约是 Prefill 64 卡加 Decode 64 卡,P:D 卡数比接近 1:1。 1P+1D 能跑,但 Decode 不到 EP64 就吃不到 Wide-EP 的收益。单卡故障会拆掉整个通信域; 重启时按当时健康卡数重新决定 EP 大小。
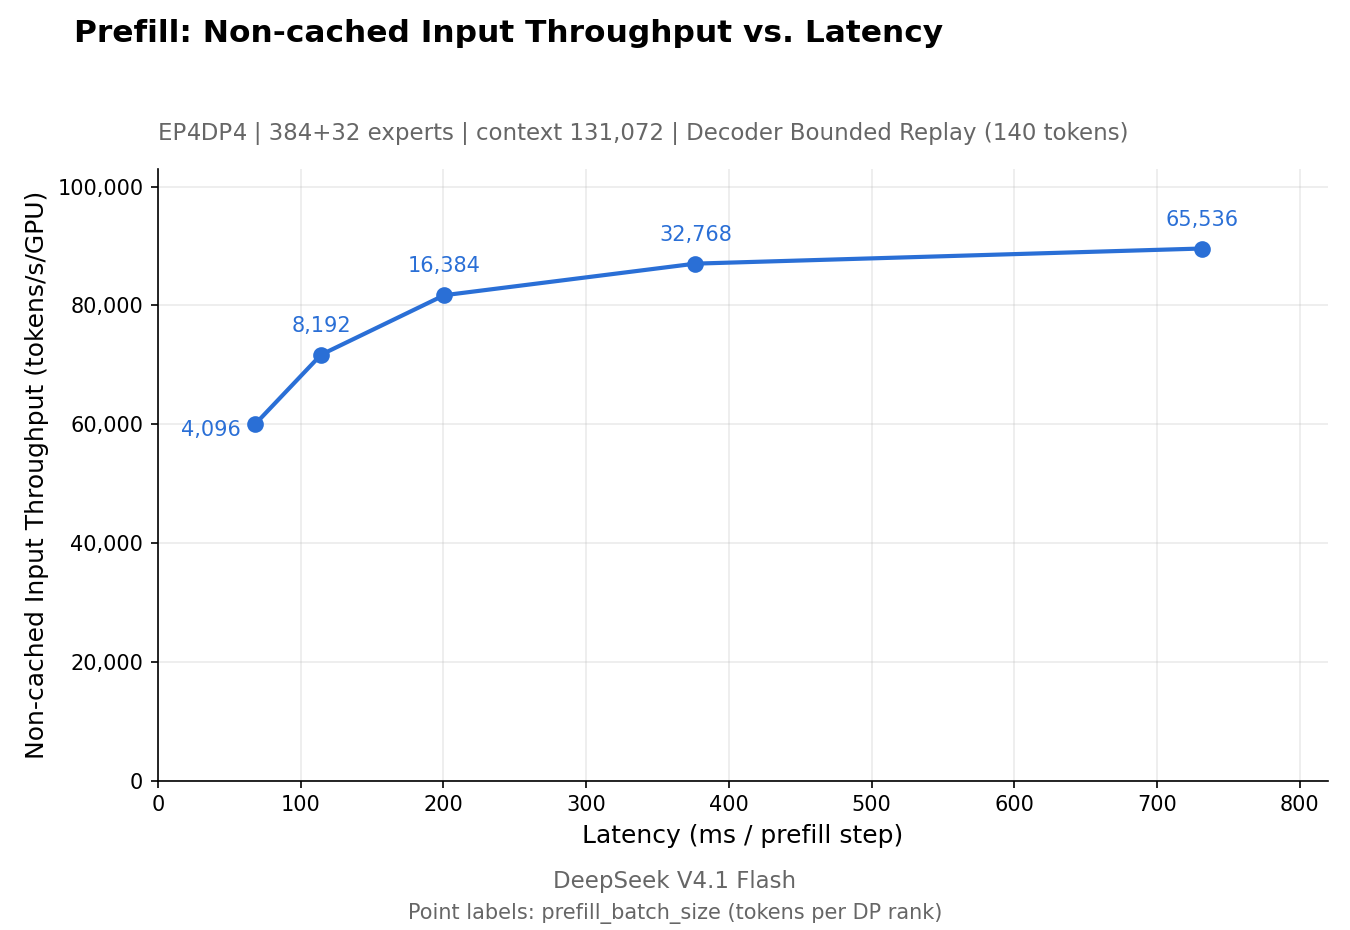
doc/images/prefill_pareto.png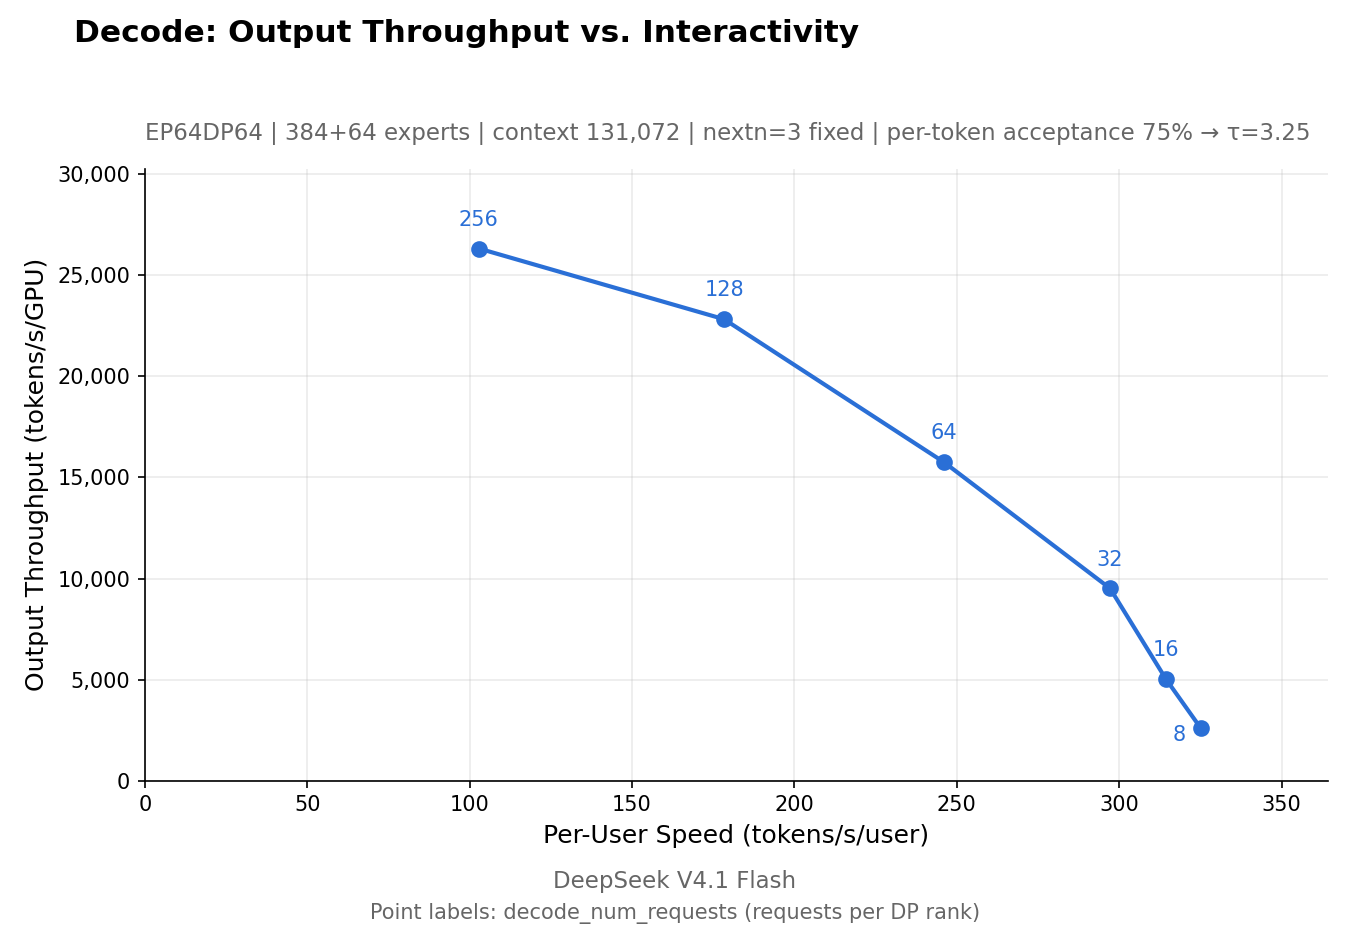
doc/images/decode_pareto.png6. DSpark:按置信度裁验证长度
环境变量 DEEPINFER_ENABLE_MTP_VARLEN=1,draft 长度
DEEPINFER_USE_NEXTN_DECODE(默认 5)。Draft 模型一次给 5 个 token,
Confidence Head 预测每个位置被接受的概率。固定长度会把算力花在低概率 token 上,
所以调度时按期望接受率排序,只验证收益最高的前缀。
问答里的 EP64/DP64 数字:动态长度把每步验证 token 从 5.00 降到大约 3.2–4.4, 平均接受长度仍在 3.2 左右。大约 60 并发序列/卡时,吞吐相对固定 5 提升约 5%; 96 并发时约 +11%;16 并发时略亏(−1.5%),因为低并发时验证本身不是瓶颈。
和异步调度咬合的地方:CPU 做 schedule(N+1) 时,第 N 步的置信度还没回到主机。
CPU 只定总预算,每条请求的长度由 GPU 上的 TileLang kernel 重算(累积、全局 top-k、remap scatter),
再写回 pinned buffer。对应算子在 tilelang_ops 的 schedule_mtp_varlen。
7. 零开销调度
朴素 decode 步是 schedule → forward → sample → post-process。
sample 之后要同步才能做 CPU 后处理,GPU 在后处理和下一步调度期间空转。
异步调度(代码里叫 ZOS,默认对 NORMAL 和 COMPLETION 打开)把流水线错开:
GPU 跑 forward(N) → sample(N) 时,CPU 同时做
schedule(N+1) → launch_forward(N+1) → post-process(N−1) → launch_sample(N+1)。
思路和 SGLang、NanoFlow 一类实现相同。process_output 的注释写明:ZOS 打开时,
这一步处理的是上一步吐出的 token。
8. SWA 有界重放
V4.1 把 KV 拆成两类。块 KV(主 KV + indexer K)进分页缓存,生产上放到专用 3FS 集群, 这样任意 Prefill 机器都能命中任意前缀。SWA KV 不进页,每条序列一个固定槽,只在 128 token 边界上存, 并且只留在产出它的那台机器的内存里,跨机命中靠入口点目录加 400G VLAN 拉回。
命中长度由块 KV 决定。SWA KV 缺失时,后退一个 128-token 块重算。重算时 query 只看重放段内部的 key
(max(s, i−127) … i),代价变成常数,跟上下文长度、层数脱钩。
- Encoder:前缀命中只依赖块 KV;SWA 缺失就重算命中前缀的最后 128 个 token,块 KV 原样复用。
- Decoder:块 KV 由最后一层 encoder hidden state 投影出来,真正要算的是 decoder 的 SWA。精确重建要跑最后 2560 个 token × 20 层;实际每次 Prefill 只重算 prompt 末尾 128 个 token,结果只给 decode 用,不写回前缀缓存。问答称这把 Prefill 计算量砍掉近一半。
开源侧用 DEEPINFER_YOCO_PREFILL_TRUNCATION_MODE=compact 和
DEEPINFER_YOCO_PREFILL_KEEP_TOKENS=140(窗口再加最大回溯长度)。
等价性检查在 examples/yoco/。
9. 低精度、结构化输出、可复现
- FP4:主 KV 为 per-16 e4m3(类似 NVFP4,无 global scale);indexer KV 与路由专家权重为 per-32 ue8m0 MXFP4。节点内 MoE 走 Mega MoE,问答说它在各种 EP 和 batch 下都明显快于未融合实现。
- 结构化输出:编译和推理解耦。约束先编成自动机,decode 每步推进自动机、生成合法 token mask 再送进采样。
SamplingParams.so_args接收 schema;例子在examples/_structured_output.py。 - Batch 不变与确定性采样:
DEEPINFER_BATCH_INVARIANT=1,目前仅 NVIDIA。确定性采样还要关掉 MTP 变长,并给SamplingParams固定seq_seed。
构建要求:Linux、GCC ≥ 13、Python 3.12;NVIDIA 要 CUDA 13,昇腾要 CANN 9.2。
DEEPINFER_ACCELERATOR=nvidia|ascend 后跑 ./build.sh。
10. 适合用在哪
- 自建 V4.1-Flash 服务的内核。引擎、算子、EPLB、投机解码、结构化输出可以直接用;KV 存储、入口负载均衡、OpenAI 兼容 API 要自己接,协议转换用 deepseek-recipe。
- 昇腾 950 上的 DeepSeek 推理。算子有完整的
asc/实现,DeepEP / DeepGEMM 有昇腾子模块,视觉注意力在npu_ops/。 - 读生产级推理系统。EPLB 的统计窗口、投机解码的动态验证长度、ZOS 与置信度回传的时序、SWA 只重算 128 token,这些在问答和代码里能对上。
- 评测。
eval/里有 AIME、GPQA、HLE;examples/sweep/扫 batch 画帕累托曲线。