1. 引言
前沿是稀疏的。阅读时长:1-2 天。为获得最佳阅读体验,建议不要使用手机。在 Artificial Analysis 指数上,得分最高的 20 个开放权重模型中,有 18 个是混合专家模型(两个例外是排名第十二和第十三的 Nanbeige4.3-33B 和 Qwen3.8 27B,它们是稠密模型)1。其中包括五家领先实验室各自的最强模型:DeepSeek V4.1 Flash 1017、GLM-5.3、MiMo-V2.6-Pro、Ling 3.1 Flash 1019 和 MiniMax-M3.1-Flash1。

MoE 的价值在于它如何花费推理算力。每个 token 只经过其中少数几个专家,因此模型可以容纳远多于单个 token 实际使用的参数:你将在第 2 章训练的小型 MoE 有 6.86B 参数,其中每个 token 激活 1.22B。把这种推理上的节省转化为更快的训练,才是难点所在。
我们之前关于训练的深度文章 Smol Training Playbook 讲的是稠密模型的训练,只是简单涉及了 MoE 的设计。由于那本手册的主角 SmolLM3 是稠密 Transformer,它的训练不需要任何 MoE 特有的技术,比如专家并行(expert parallelism)。不过,我们在该手册的“Going Sparse: MoE”一节中粗略介绍了 MoE 的高层设计选择:稀疏度、粒度、共享专家和负载均衡。那一节点出了分布式 MoE 训练复杂的主要原因:专家放置、负载均衡和 all-to-all 通信,但没有深入细节2。本手册就从这份清单出发。
从稠密模型转向 MoE,会带来三个需要管理的新挑战:一个决定每个 token 使用哪些专家的路由器(router),一个必须在各专家之间保持均衡的负载,以及一旦专家被拆分到多块 GPU 上,每个 MoE 层都要在这些 GPU 之间进行的token 交换。每个方面都带来了稠密训练从未有过的设置,也带来了训练失败的新方式。接下来的各章会逐一讲解这些设置并详细剖析,附带可以运行的代码,并且在大多数情况下,还有来自我们自己集群实验的直接结果和数据。
训练跑偏时,你只会看到症状,而看不到背后的原因。下面的地图是一个高层视图,帮助你追溯根源:从训练如何失败入手,找到不良行为的第一个信号(煤矿里的金丝雀),再去阅读文中解释可能原因的部分。你可以把这张地图放在手边,以备哪天训练出问题时使用。
在开始之前,先简单说明一下目标读者。这本手册适合谁?如果你已经在 GPU 集群上训练过稠密模型,并想接着训练 MoE,那么你会从中受益。第 2 章会准备好你所需要的一切,并带你在单个节点上训练那个小型 MoE。如果你更好奇 MoE 的工作原理以及前沿模型的选择,而不是亲自运行,可以直接跳到第 3 章“MoE 训练剖析”。

一旦专家分布在不同的 GPU 上,每个 MoE 层都要在它们之间交换 token,这是我们的稠密训练从未用过的模式。在你改动模型的任何一行代码之前,你能信任集群的链路承受得住它吗?
2. 环境准备与第一次训练
2.0 你需要准备什么
本章的每条命令都是为同一种机器编写的,这样每个人运行的环境一致:由八卡节点组成的 Slurm 集群。本节介绍这套环境、只有一块 GPU 或没有 GPU 时你能跟着读到多少内容,以及如何在 Hugging Face Jobs 上租用一台八卡节点。如果你的机器不同,仍然可以跟着理解讲解,并自行调整命令。
命令所假设的集群
这些命令假定有一个 Slurm 集群,其 GPU 节点各有八块 GPU。容器通过 Enroot 和 Pyxis 启动,二者让 srun 可以在镜像内启动任务。3,42.1 中的单节点就绪检查使用 NVIDIA 的 DCGM 诊断。我们的运行使用通过 Elastic Fabric Adapter(EFA)互联的 AWS P5 节点,每个节点有八块 80 GB 的 H100 GPU。
本章的大部分内容在单个节点上即可完成。稠密基线和第一个 MoE 各自申请一个带八块约 80 GB GPU 的节点。只有网络检查需要更多节点:2.1 中的 all-to-all 测试在两个、四个和八个节点上运行,2.2 中的 EFA 镜像在两个节点上验证。
软件来自两个固定版本的来源。第一个是 NGC PyTorch 镜像 26.06-py3,2.2 会导入它,并用集群的网络库对其进行扩展。第二个是位于提交 d6316eb45 的 Megatron 检出副本,你需要把它挂载到容器中,而不是构建进镜像里。你还需要一个 CPU 工作进程和 GPU 节点都能读取的文件系统,因为 2.3 在 CPU 分区上对数据做 tokenize,训练作业再从那里读取结果。
只用一块 GPU 或不用 GPU 阅读
没有集群,你也能读懂本文的大部分内容。第 3 章把 MoE 层拆开:每个部分做什么、前沿模型对它做了什么选择,以及每个选择背后的证据。你可以从头读到尾而无需运行任何东西,把其中的参数留到有硬件时再用。第 4 章把同样的选择从预训练延伸到推理服务和强化学习。
本章中,2.3 的 tokenize 在 CPU 上运行。它的小样本在没有 Slurm 的单机上即可运行,因此你可以生成并检查训练所读取的同样的文件。2.4 和 2.5 中的训练配方假定有八块约 80 GB 的 GPU,MoE 把专家分布在全部八块 GPU 上。GPU 较少时,请把它们当作方法来读:两次训练之间哪些保持不变、专家宽度如何选择,以及该比较什么。2.1 中的 all-to-all 测试和 2.2 中的 EFA 配置需要多个节点才能按原样运行。
在 Hugging Face Jobs 上租用节点
如果你想在没有硬件的情况下运行单节点部分,Hugging Face Jobs 可以在 Hugging Face 的机器上运行 Docker 镜像和命令,按分钟计费。任何账户余额为正的用户或组织都可以使用,PRO、Team 或 Enterprise 订阅的月度额度也可以用来支付作业费用。5hf jobs hardware 列出的最大硬件选项有八块 GPU,与 2.4 和 2.5 使用的数量一致;例如 h200x8 配有八块各 141 GB 的 H200。6
一个作业由来自 Docker Hub 或 Hugging Face Space 的 Docker 镜像、一条命令和一个硬件选项定义,因此要在那里运行本章,就需要把 2.2 中的镜像打包成 Docker 镜像,并把 Slurm 启动器替换成 Jobs 命令。除非另行设置超时,作业会在 30 分钟后停止。7第一条命令只检查作业是否能看到全部八块 GPU:
hf jobs run --flavor h200x8 --timeout 10m \
    pytorch/pytorch:2.6.0-cuda12.4-cudnn9-devel \
    python -c "import torch; print(torch.cuda.device_count())"
无论你是在自己的集群上还是在租用的节点上运行这些配方,拿到的机器都未必能达到规格所说的性能。你要怎样才能发现某块 GPU 或某条链路悄悄地性能不达标?
2.1 测试你的硬件
在开始调优模型之前,先弄清楚这些机器能做什么。使用 Megatron 的 alltoall dispatcher 时,每个 MoE 层把 token 发送到持有对应专家的 GPU,再通过另一次 all-to-all 把结果送回。因此 GPU 之间的链路也属于你需要测试的工作内容:仅仅得到健康的 all-reduce 结果,并不能告诉你这些 token 交换会跑多快。
请在作业分配内、启动训练之前运行下面的检查。借助 Pyxis,srun --container-image 会启动一个容器;下一节将解释如何准备训练镜像。3
检查每个节点
先对每个已分配的节点做就绪检查。NVIDIA 的 DCGM 提供多个诊断级别,其中 1 级用于就绪检查,更高级别增加了有助于排查故障的测试。下面的命令每个节点运行一个任务,这样你可以在开始训练前检查每个结果。8
NNODES=$SLURM_JOB_NUM_NODES
srun --nodes="$NNODES" --ntasks="$NNODES" --ntasks-per-node=1 \
    dcgmi diag -r 1 --fail-early
如果所有节点都通过,就继续做通信测试。如果某个节点失败,请保留它的诊断输出,并在继续之前进行排查。例如,在我们的一个节点上,2 级诊断报告了三块 GPU 的过热违规,同时 PCIe 和内存测试失败。
更长时间的诊断应放在单独的维护窗口中进行。NVIDIA 把 3 级和 4 级描述为管理员事后分析(post-mortem)测试,而 1 级则是就绪检查。8
准备诊断镜像
如果你的集群已经提供了 nccl-tests 镜像,请把 NCCL_TESTS_IMAGE 设为它的路径。否则,在带 EFA 的 AWS 上,你可以导入随 AWS NCCL 测试配方一起维护的公共镜像。请选择一个已分配节点都能访问的文件系统作为目标位置:9
NCCL_TESTS_IMAGE=/shared/images/nccl-tests.sqsh
mkdir -p "$(dirname "$NCCL_TESTS_IMAGE")"
enroot import -o "$NCCL_TESTS_IMAGE" \
    'docker://public.ecr.aws#hpc-cloud/nccl-tests:latest'
请把导入得到的 SquashFS 文件与你的基线一起保存,因为再次导入 latest 可能得到不同的镜像。若想要可复现的导入,请从 AWS 配方中选用带版本号的标签来替代 latest。10,9
如果需要自己构建镜像,AWS 配方还提供了 Dockerfile。对于其他网络结构,请使用其支持的 CUDA、NCCL、MPI 和网络插件栈;NVIDIA 的 nccl-tests 构建说明讲解了如何选择这些库路径。多节点测试需要使用 MPI=1 构建。下面的基准测试假定 MPI 可以通过 Slurm 的 PMIx 集成启动,所以请让镜像与集群的 MPI 配置相匹配。11
测量你将要使用的集合通信
节点通过后,测量整个分配范围内的 all-to-all 带宽。下面的命令为每块 GPU 启动一个 rank,并让每个 rank 交换 8 GiB 的缓冲区,与我们基线所用的大消息测试一致。请使用上面准备好的 NCCL_TESTS_IMAGE 路径;如果你的镜像把 nccl-tests 安装在别处,请调整可执行文件路径。
srun --nodes="$NNODES" --ntasks="$((8 * NNODES))" \
    --ntasks-per-node=8 --gres=gpu:8 --mpi=pmix --cpu-bind=none \
    --container-image="$NCCL_TESTS_IMAGE" --no-container-mount-home \
    /opt/nccl-tests/build/alltoall_perf \
    -b 8G -e 8G -g 1 -c 1 -n 20
读取结果之前先检查 rank 列表:两个八卡节点的分配应列出 16 个 rank。然后查看所测大小对应的 busbw 和 #wrong 列。下面是我们两节点基线的 out-of-place 结果,省略了其他列:
size (B)      busbw (GB/s)    #wrong
8589934592    77.14           0
#wrong 为零表示该结果通过了正确性检查。带宽为你之后在相同节点数、每节点 GPU 数和测试设置下的分配提供了参考。请把节点列表与它保存在一起,这样以后出现缓慢结果时,可以追溯到涉及的机器。在另一次单独的两节点分配中,设置了 NCCL 调优变量运行,相同消息大小达到了 39.84 GB/s,所以请记录每个基线是由哪些节点和设置得到的。
All-reduce 作为对比仍然有用,但这两种集合通信在同一批机器上的表现可能大相径庭。那次较慢的两节点测试,all-reduce 达到 398.52 GB/s,而 all-to-all 结果为 39.84 GB/s。对于要跨这些节点交换 token 的 MoE 来说,第二个测量才是检验相关通信模式的指标。
为每种分配规模选择基线
随着节点增加,all-to-all 交换中有更多部分要跨越节点间网络。我们的多节点扫描说明了为什么基线必须取决于节点数:两个节点时达到 77.14 GB/s,四个节点时为 39.25 GB/s,八个节点时为 30.91 GB/s。请把每次分配与同样节点数的基线比较,使用相同的消息大小和相同的结果列。
在选定参考之前,请在硬件、软件和测试设置固定不变的已知良好配置上重复检查。用得到的范围来判断新的分配是否已准备好训练。一个实用的起始策略是要求达到基线带宽的 90% 并通过正确性检查。以上面的两节点结果为例,带宽阈值约为 69 GB/s。请根据你集群观察到的波动调整阈值。例如,固定的 33 GB/s 阈值会接受那个缓慢的两节点结果,却会拒绝八节点扫描的结果。
排查缓慢的分配时,请保持这个基线不变。如果你还想尝试 NCCL 调优变量,请在相同节点上用相同的测试参数比较这些设置。我们的默认运行和调优运行使用了不同的节点对,因此它们的带宽差异无法说明这些变量的影响。
检查训练过程中的变化
若要在训练期间定期做硬件检查,请使用 Megatron 的 --gpu-sniff-test-interval <n>。它会在训练前以及每 n 次迭代运行一次(training.py#L4850-L4852、training.py#L4484-L4489),其中包括在专家并行组上的一次 all-to-all(gpu_sniff_test.py#L5-L21)。出现变慢时,它的离群值警告会指出需要排查的 rank(gpu_sniff_test.py#L104-L118)。
诊断镜像让你测试了 GPU 及其链路。训练镜像需要访问同样的硬件,所以我们来准备它,并检查其网络库。
2.2 构建你的镜像
训练环境有两部分需要做好:运行 GPU 计算的库,以及跨节点连接这些 GPU 的网络库。我们先从 NVIDIA PyTorch 容器开始处理第一部分,再添加集群所需的网络支持。把 Megatron 放在单独的检出目录中,可以在保持同一个镜像的同时修改训练代码。
这里的示例在 Slurm 上使用 Enroot 和 Pyxis。基础镜像是 NGC PyTorch 26.06-py3;针对网络的说明适用于我们带 EFA 的 AWS P5 节点。在其他集群上,镜像中的这一部分请使用其支持的网络栈。3,4
导入基础镜像
Enroot 把容器镜像导入为 SquashFS 文件,Pyxis 可以通过 srun 启动它。请选择计算节点可访问的输出路径,然后导入基础镜像:4
IMAGE=/path/to/images/pytorch-26.06.sqsh
enroot import -o "$IMAGE" docker://nvcr.io#nvidia/pytorch:26.06-py3
请把 Megatron 检出目录放在这个镜像之外,并在启动训练时把它挂载进容器。本文中的参数针对提交 d6316eb45;显式检出该提交,可以让你对照示例阅读的代码与实际运行的代码一致。源码说明列出了每项测量所用的镜像和提交。
请把这个检出目录,以及之后的数据和 tokenizer,放在 CPU 工作进程和 GPU 节点都能读取的文件系统上。在下面的命令中,SHARED_ROOT 是该目录,PROJECT_DIR 是你的项目目录,配套脚本被克隆到其 scripts/ 文件夹中。
export SHARED_ROOT=/path/to/shared/work
export PROJECT_DIR="$SHARED_ROOT/moe-blogpost"
git clone https://gist.github.com/nmntz/5de952d686f66d7bce5bce8cba9d7139.git "$PROJECT_DIR/scripts"
git clone https://github.com/NVIDIA/Megatron-LM.git "$SHARED_ROOT/Megatron-LM"
cd "$SHARED_ROOT/Megatron-LM"
git checkout d6316eb45bf1bfbb6f1f848c0b56e55166564d80
验证 GPU 访问
在添加集群的网络库之前,先检查基础镜像能否导入 PyTorch 和 Transformer Engine 并看到这些 GPU。请在已分配的八卡节点内运行,使用上面的 IMAGE 路径:
srun --nodes=1 --ntasks=1 --gres=gpu:8 \
    --container-image="$IMAGE" --no-container-mount-home \
    python -c '
import torch, transformer_engine
print("torch", torch.__version__)
print("transformer_engine", transformer_engine.__version__)
print("device_count", torch.cuda.device_count())
x = torch.randn(8).cuda().sum()
print("cuda sum ok", x.item())
'
原版镜像报告了以下版本和设备数量。命令的最后一行还会打印在 GPU 上计算的一个和,因此在继续之前,请连同导入结果一起检查这个结果。
torch 2.13.0a0+8145d630e8.nv26.06
transformer_engine 2.16.0+4220403e
device_count 8
CUDA 的结果检查的是本节点内 GPU 上的执行。对于跨节点的 EFA 通信,请添加下面描述的网络插件及其依赖。
添加 EFA 支持
在我们的 AWS 节点上,网络层由 EFA 用户态库和针对镜像内 NCCL 构建的 aws-ofi-nccl 插件组成。构建使用了 EFA 安装器 1.49.0 和 aws-ofi-nccl v1.19.2。请把这两个版本与基础镜像一起记录在你的构建配方中。
EFA 镜像构建脚本会基于基础镜像创建一个可写的 Enroot 容器,用 --skip-kmod 安装 EFA 用户态库,并针对镜像的 NCCL 编译插件。然后它导出一个新的 SquashFS 镜像并删除临时容器。请在具有 Enroot 和 GPU 访问权限的已分配计算节点上运行它,并选择一个新的输出路径:
EFA_IMAGE=/path/to/images/pytorch-26.06-efa.sqsh
bash "$PROJECT_DIR/scripts/build_efa_image.sh" "$IMAGE" "$EFA_IMAGE"
后续的训练启动请把 EFA_IMAGE 用作 --container-image 路径。该脚本准备的是网络层;请把下面的环境设置与该镜像一起保存,以便作业能够找到并选择其库。
这里的库路径指的是安装在容器内的副本,NCCL_NET_PLUGIN=ofi 按名称选择插件。在我们的环境中,把文件系统路径作为插件值传入,会导致 NCCL 构造出无效的库名。
export LD_LIBRARY_PATH=/opt/amazon/ofi-nccl/lib:/opt/amazon/efa/lib:${LD_LIBRARY_PATH:-}
export NCCL_NET_PLUGIN=ofi
export FI_PROVIDER=efa
export FI_EFA_USE_DEVICE_RDMA=1
export NCCL_SOCKET_IFNAME='^lo,docker0,veth_def_agent'
export NCCL_DEBUG=INFO
排除 socket 接口,处理的是 NCCL 用来建立通信的初始连接。在我们的节点上,NCCL 选中了 veth_def_agent,尝试连接它的链路本地地址,并以 Connection refused 失败。排除该接口后,启动得以继续。复用之前,请根据你集群的接口调整排除列表。
验证网络路径
第一次多节点训练启动时,请在解读训练性能之前先检查 NCCL 初始化日志。这是从训练镜像本身检查网络路径。对于这里描述的 EFA 镜像,应当找的是这一行:
NCCL INFO Using network Libfabric如果你看到的是 Using network Socket,请阅读它正上方的插件加载消息。无效的插件名或缺少的库版本,都可能让 NCCL 改用 socket。例如,EFA_1.4 错误指出缺少一个库版本,需要先解决再重试。
日志确认了作业选择的传输方式;测量其带宽仍是另一项检查。请把训练镜像和网络设置与 2.1 的诊断结果一起记录,在比较性能时明确区分这两个环境。
硬件检查完毕、镜像准备就绪,我们可以转入第一次训练了。它从数据开始:把原始文本转为 token 序列,并存成 Megatron 期望的格式。
2.3 Tokenize
Megatron 从成对的索引文件中读取训练文本。.bin 文件存储 token ID,.idx 文件告诉加载器每个序列从哪里开始、到哪里结束。这些文件只需准备一次,稠密和 MoE 两次训练就能读取相同的 token,因此换模型不会同时改变数据。
我们将使用 FineWeb-Edu 和 Llama 3.2 tokenizer。Datatrove 的 MegatronDocumentTokenizer 可直接写出该格式;剩下的工作是选择输出目录、检查一个小样本,并提交更大的 tokenize 作业。
准备 tokenizer
请把数据和 tokenizer 放在 SHARED_ROOT 下,即 2.2 中的共享目录。tokenize 脚本在本地运行样本,并为更大的作业提交一个 Slurm 数组。
export TOKENIZER_DIR="$SHARED_ROOT/tokenizer"
python3.11 -m venv "$SHARED_ROOT/tokenize-venv"
source "$SHARED_ROOT/tokenize-venv/bin/activate"
python -m pip install \
    'datatrove @ git+https://github.com/huggingface/datatrove.git@2c895af7a95010a96fa53e2dc77cc0ce92799e3f' \
    pyarrow tokenizers huggingface_hub
原始 tokenizer 仓库 meta-llama/Llama-3.2-1B 需要审批访问权限。如果你的账户有权限,请运行 hf auth login 并在下载命令中使用该仓库。否则,unsloth/Llama-3.2-1B 提供了一个无需授权的副本:我们的对比发现其词表和 token ID 一致。tokenize 和训练都将读取同一份已下载的 tokenizer 文件。12
TOKENIZER_REPO=unsloth/Llama-3.2-1B
hf download "$TOKENIZER_REPO" \
    --include 'tokenizer*' --include 'special_tokens_map.json' --include 'config.json' \
    --local-dir "$TOKENIZER_DIR"
Datatrove 从该目录读取 tokenizer.json,并在每篇文档后追加 <|end_of_text|>。Megatron 随后通过 --tokenizer-model 接收该目录,这也让它得到 tokenizer 的配置。
检查一个小分片
在提交完整数组之前,先在 CPU 计算节点上对一个小样本做 tokenize。该命令最多读取 1,000 篇文档并全部保留,结果写入单独的目录,避免把样本误当作训练语料。
python "$PROJECT_DIR/scripts/tokenize_first_run.py" \
    --tokenizer "$TOKENIZER_DIR/tokenizer.json" \
    --output "$SHARED_ROOT/data-smoke" --limit 1000
输出前缀是 fineweb-edu_00000_tokens。请在 2.2 的训练镜像内,用 Megatron 自带的 reader 检查它,需使用 Pyxis 能够启动容器的分配。请先停用 tokenize 环境,免得它的 Python 覆盖镜像自带的解释器。在 EFA 配置下把 TRAIN_IMAGE 设为 EFA_IMAGE,否则设为你集群上准备好的训练镜像。
deactivate
export TRAIN_IMAGE="$EFA_IMAGE"
export MEGATRON_PATH="$SHARED_ROOT/Megatron-LM"
srun --nodes=1 --ntasks=1 \
    --container-image="$TRAIN_IMAGE" \
    --container-mounts="$SHARED_ROOT:$SHARED_ROOT" \
    --container-workdir="$MEGATRON_PATH" --no-container-mount-home \
    env PYTHONPATH="$MEGATRON_PATH" python -c '
import sys
from megatron.core.datasets.indexed_dataset import IndexedDataset
data = IndexedDataset(sys.argv[1])
assert len(data) > 0
print("sequences", len(data))
for i in range(min(3, len(data))):
    tokens = data[i]
    assert len(tokens) and tokens[-1] == 128001
    print("length", len(tokens), "last token", int(tokens[-1]))
' "$SHARED_ROOT/data-smoke/fineweb-edu_00000_tokens"
你应该会看到非零的序列数,且每条被检查的序列都显示 last token 128001。这个最后的 token 就是我们要求 tokenizer 追加的文档边界。通过 Megatron 读取该分片,也能在 GPU 训练开始之前,验证 Megatron 可以解析索引并从 token 文件中读取最前面的序列。
提交 tokenize 作业
样本检查的是文件格式;更大的作业则准备一份语料,供训练规模增长时复用。请在登录节点上、激活同一个虚拟环境后提交。把 CPU_PARTITION 设为你集群的 CPU 分区;如果调度器要求,再加上 --qos。脚本为每个任务申请 12 个 CPU 和 24 GB 内存,且这些工作节点上必须能通过相同路径访问该虚拟环境。
source "$SHARED_ROOT/tokenize-venv/bin/activate"
export OUT_DIR="$SHARED_ROOT/data/fineweb-edu"
CPU_PARTITION=your_cpu_partition
python "$PROJECT_DIR/scripts/tokenize_first_run.py" \
    --tokenizer "$TOKENIZER_DIR/tokenizer.json" --output "$OUT_DIR" \
    --tasks 100 --limit -1 --sample-rate 0.074 --partition "$CPU_PARTITION"
Datatrove 会打印提交的作业 ID。请用该 ID 配合 squeue -j <job-id> 跟踪数组进度,并在重新启动同一命令之前,检查 $OUT_DIR/logs 下失败的任务。
每个任务读取一部分输入文件,并在 tokenize 之前随机保留 7.4% 的文档。由于文档长度不同,这个比例并不能固定输出的 token 数量。重启被中断的作业时,请保持任务数、采样率和输出目录不变。Datatrove 使用日志目录下的完成标记来跳过已完成的任务。13
把分片交给 Megatron
请等数组跑完再构建训练清单。下面的检查要求全部 100 个任务完成标记及预期的分片对都存在,并把分片前缀逐行写入 data-args.txt。每个前缀同时指代两个文件,所以清单里不应出现 .bin 或 .idx。
export DATA_ARGS="$OUT_DIR/data-args.txt"
python - <<'PY'
import os
from pathlib import Path
root = Path(os.environ["OUT_DIR"])
prefixes = [root / f"fineweb-edu_{rank:05d}_tokens" for rank in range(100)]
for rank, prefix in enumerate(prefixes):
    assert (root / "logs/completions" / f"{rank:05d}").is_file(), rank
    for suffix in (".bin", ".idx"):
        path = Path(str(prefix) + suffix)
        assert path.is_file() and path.stat().st_size > 0, path
Path(os.environ["DATA_ARGS"]).write_text("\n".join(map(str, prefixes)) + "\n")
print(f"wrote {len(prefixes)} prefixes")
PY
deactivate
训练将通过 --data-args-path 读取这个文件。该选项提供的列表与 --data-path 相同,但可以避免把一长串分片塞进启动命令。启动器还把 --data-cache-path 设置为一个持久目录,用于存放 Megatron 的样本索引,这样之后使用相同数据集配置的运行就可以复用它们。
前几次运行我们使用 --split 100,0,0,把数据全部划给训练。在用该运行比较模型质量之前,请先留出一个保留的验证划分。
有了可读取的数据集和指向其分片的清单,你就可以启动稠密基线了。在引入专家之前,它的 loss、梯度范数和单步耗时将作为参照。
2.4 稠密基线
当 MoE 表现异常时,稠密训练能给你一个具体的比较对象。两个模型使用相同的数据、batch size 和优化器,因此出现 loss 尖峰或某一步变慢时,可以先对照更简单的模型来检查。这个基线也能在路由介入之前,一并检验训练镜像和数据加载器。
该模型有 16 个 Transformer 层,隐藏维度为 2,048,前馈网络宽度为 8,192。词表有 128,256 项,总参数约为 12.2 亿。该配方面向一个带八块显存约 80 GB GPU 的节点。我们将在 MoE 中复用这个启动脚本。
在单个节点上启动
我们将使用 Trackio 来记录训练指标。Trackio 是 Hugging Face 推出的轻量级开源实验跟踪工具。它的 API 与 wandb 相仿,因此现有代码通常只需把 import trackio as wandb 作为唯一改动。训练记录写入你自己拥有的本地数据库,你可以在本地仪表盘中浏览,也可以同步到 Hugging Face Space,与团队实时分享曲线,无需账号或付费方案。14
首先,在训练镜像内部、共享存储上创建一个 Python 环境。它继承镜像的 GPU 库,并添加固定版本的跟踪包:
srun --nodes=1 --ntasks=1 \
    --container-image="$TRAIN_IMAGE" \
    --container-mounts="$SHARED_ROOT:$SHARED_ROOT" --no-container-mount-home \
    bash -c 'python -m venv --system-site-packages "$1/train-venv" &&
        "$1/train-venv/bin/python" -m pip install "trackio==0.42.0"' _ "$SHARED_ROOT"
export TRACKIO_PROJECT=moe-first-run
启动器使用 Trackio 入口,把 Megatron 的标量指标发送到每个作业对应的一次运行。两次运行共享上面的项目,数据存放在 $SHARED_ROOT/trackio 下。该适配器使用 Megatron 现有的标量日志钩子,因此 --log-memory-to-tensorboard 等参数控制哪些指标会进入 Trackio。
首次运行脚本把训练参数归入 Bash 数组。它使用前面几节准备好的训练镜像、固定版本的 Megatron 检出、tokenizer 目录和数据清单。请保持挂载路径位于 SHARED_ROOT 之下,并把 TRAIN_IMAGE 设为准备好的 SquashFS 镜像。
在共享的博客检出目录中,把稠密作业提交到你的 GPU 分区。提交作业时请保持 2.3 中的变量已导出。脚本会把镜像路径、Megatron 提交和数据清单与输出一起记录下来。
cd "$PROJECT_DIR"
GPU_PARTITION=your_gpu_partition
sbatch --partition="$GPU_PARTITION" scripts/first_run.sbatch dense
Slurm 保留一个八卡节点。在节点内,单个 srun 任务启动 torchrun,由它为每块 GPU 启动一个训练进程。运行输出在 $SHARED_ROOT/runs/dense-<job-id> 下,训练日志在提交目录中的 first-run-<job-id>.out。
首次运行在 120 次迭代后停止。此配置检查中,检查点保存和验证均被禁用。转到 MoE 时请保留日志和 Trackio 数据;它们是下一节的参照。
要查看曲线,请在能读取保存目录的机器上运行仪表盘,并先在那里安装 trackio==0.42.0。在项目中选择稠密和 MoE 两次运行进行比较。
TRACKIO_DIR="$SHARED_ROOT/trackio" trackio show --project "$TRACKIO_PROJECT"理解配置
张量并行和流水线并行都设为 1 时,每块 GPU 持有一份完整的稠密模型。数据并行把 batch 分摊到八块 GPU 上,分布式优化器和通信重叠在两次运行中都已启用。
--tensor-model-parallel-size 1 --pipeline-model-parallel-size 1
--expert-model-parallel-size 1 --context-parallel-size 1
--use-distributed-optimizer --overlap-grad-reduce --overlap-param-gather
--micro-batch-size 8 --global-batch-size 512
一个 micro-batch 在每块 GPU 上包含八条序列。八块 GPU 合计,每个 micro-batch 处理 64 条序列;八步梯度累积得到 512 的全局 batch。序列长度为 4,096 时,每个优化器步消耗 2,097,152 个 token。保持这些量不变,可以让稠密和 MoE 的单步耗时直接可比。
学习率遵循“预热—稳定—衰减”(warmup, stable, decay)的调度,由 --lr-decay-style WSD 选择。它先预热到 5e-4,保持该学习率,然后在设定的 token 预算接近尾声时衰减。120 次迭代的运行结束于稳定阶段;它的停止条件并不会缩短学习率调度。
完整的激活重计算使起始配置保持在我们基线所用的显存预算之内。在 micro-batch 大小为 8 并使用原生 cross-entropy 实现时,不做重计算的对应运行在 loss 计算中耗尽了显存。我们在两个模型中都保留重计算,这样第一次比较就不会把模型变化与省显存的变化混在一起。
--recompute-granularity full --recompute-method uniform --recompute-num-layers 1
--cross-entropy-loss-fusion --cross-entropy-fusion-impl native
请把稠密训练的 loss、梯度范数和单步耗时保存在 Trackio 中作为参照。当你把前馈层替换成专家时,这些测量能帮你看清这一改动对训练有何影响。
2.5 你的第一个 MoE
稠密模型对每个 token 应用同一个前馈网络。在 MoE 中,路由器为每个 token 从 64 个更小的专家中挑选八个,使模型能容纳比单个 token 实际使用的更多的参数。我们选择专家的宽度,使被选中的八个专家包含的前馈参数量,与它们所替换的稠密层相同。
这给我们带来一个总参数量为 68.6 亿、每个 token 约 12.2 亿激活参数的模型。额外的容量伴随着新的代价:token 必须到达所选的专家,专家的输出也必须返回需要它们的进程。

替换前馈层
传入 moe 时,启动器会选用 MoE 配置。请使用与稠密训练相同的已导出路径和 GPU 分区提交,镜像、检出目录、tokenizer 和数据清单保持不变:
sbatch --partition="$GPU_PARTITION" scripts/first_run.sbatch moe专家并行从 1 增加到 8,把 64 个专家分布到节点的八块 GPU 上。每块 GPU 持有八个专家,而路由器仍从全部专家中为每个 token 选出八个。
--expert-model-parallel-size 8 --expert-tensor-parallel-size 1
--num-experts 64 --moe-ffn-hidden-size 1024 --moe-router-topk 8
--moe-token-dispatcher-type alltoall --moe-grouped-gemm
--moe-router-load-balancing-type aux_loss --moe-aux-loss-coeff 1e-3
--moe-router-dtype fp32 --moe-per-layer-logging
alltoall 在 GPU 之间搬运被路由的 token,grouped GEMM 执行本地专家的矩阵乘法。辅助损失(auxiliary loss)鼓励路由器把工作分散到各专家上,系数为 1e-3。我们还以 fp32 计算路由器 logits,并启用逐层日志,这给出了第 3 章将要考察的初始设置和测量。
其余一切保留在公共配置中,包括完整的激活重计算。特别是,稠密的 --ffn-hidden-size 8192 设置仍保留在脚本里,而 --moe-ffn-hidden-size 1024 提供每个专家的宽度。
统计激活参数和总参数
一个不带 bias 的 SwiGLU 专家有三个权重矩阵。隐藏维度为 2,048、专家宽度为 1,024 时,它们合计 3 × 2048 × 1024 = 6,291,456 个参数。因此选择八个专家每个 token 使用 50,331,648 个前馈参数,与稠密层的 3 × 2048 × 8192 个参数一致。
全部 64 个专家合计包含八倍的前馈参数。整个模型增长的倍数较小,因为注意力、embedding 和其他非专家参数大小不变,而每一层只多出一个很小的路由器矩阵。把这些部分在 16 层上求和,得到总参数 68.6 亿、激活参数 12.21 亿,而稠密模型为 12.19 亿。
结果是总参数量约为稠密的 5.6 倍,激活参数量却几乎相同。激活参数量相同并不保证单步耗时相同:在专家之间分发 token 会改变 GPU 工作的组织方式,并引入通信。
保留一个稠密参照
只有一个专家、top-1 路由的 MoE 与它所源自的稠密模型计算的是同一个函数,所以它应该像稠密模型那样训练。在我们的实验中,一个由稠密检查点 upcycle 而来的 1 专家 MoE,与稠密训练并行继续训练,在 15 个对齐的步中与稠密训练相差不超过 0.00087。如果让 MoE 从它自己的初始化开始,这个比较就说明不了什么了,因为两次运行在第 4 次迭代时相差 2.72。MoE 一侧还会记录到恰好为 1 的负载均衡 loss,以及梯度中约 32,770 个零,而稠密训练最多只有 17 个:这是路由器权重,在只有一个专家时得不到梯度。这个对齐实验对稠密检查点做 upcycle,3.6 会回到这条路径。

在固定的提交上,这条 upcycling 路径只有对 training.py 做了两处本地修复才能跑通。第一处是把稠密模型以关键字 model 传给检查点加载器(training.py#L3074-L3078),而 load_checkpoint 把该参数命名为 ddp_model。第二处涉及为加载而构建的稠密模型:upcycling 代码在 args 中打开稠密形状(training.py#L3056-L3062),但模型构建器读取的是启动时保存的模型配置(training.py#L2917-L2926),因此该模型仍保持 MoE 层布局,加载会在缺失 pre_mlp_layernorm 键时停下。
确定性模式让一次运行可重复,这样两次运行之间的差距才有意义。在固定的提交上,--deterministic-mode 要求关闭 cross-entropy loss 融合、TP 通信重叠和融合的 aux-loss kernel(determinism.py#L28-L37、determinism.py#L195-L210),并且只接受 NVTE_ALLOW_NONDETERMINISTIC_ALGO 取 0(determinism.py#L85-L90);当 NCCL_ALGO=Ring、NCCL_EP_HT_EM_AG_SCAN_MODE=1、NVTE_ALLOW_NONDETERMINISTIC_ALGO=0 和 CUBLAS_WORKSPACE_CONFIG=:4096:8 未设置时,它会自行设置它们(determinism.py#L40-L50)。2.4 的启动器传入了 --cross-entropy-loss-fusion 并导出了 NVTE_ALLOW_NONDETERMINISTIC_ALGO=1,所以在加这个参数之前请先去掉这两项。使用这些设置,把该 MoE 缩小到 micro-batch 2、全局 batch 64 和 12 次迭代后,两次运行在每次迭代都输出了相同的 lm loss、负载均衡 loss、梯度范数和梯度零的个数;不用这些设置时,lm loss 从第一次迭代起就不同,差距最高达 0.00063。
在比较两次运行或排查 NaN 之前,请先打开确定性模式。
开发 MoE 时,请把稠密训练及其配置作为参照保留。每当某项改动使训练变慢或 loss 不再下降时,就回到 Trackio 中的稠密训练,在相同 batch size 和序列长度下比较单步耗时、loss 和梯度范数。两次运行中都出现的问题,指向它们共享的设置;只在 MoE 中出现的问题,则让你有理由去排查路由和专家执行。
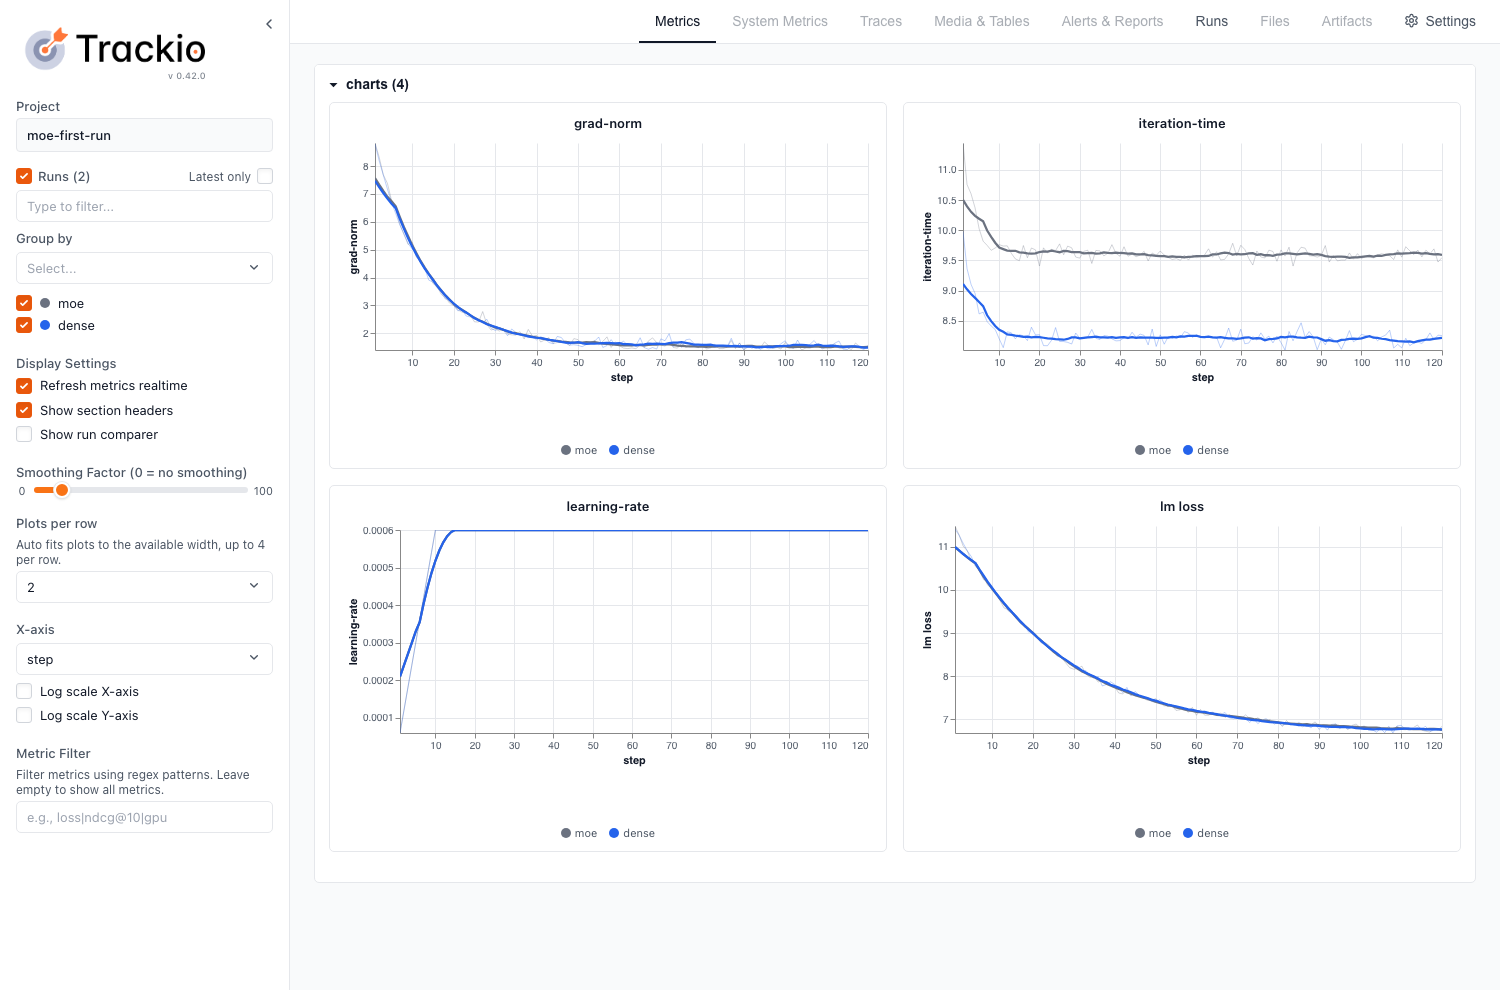
稠密参照帮助你决定从哪里开始排查。第 3 章会一块一块地打开 MoE 层,介绍理解其行为所需的各项测量。
3. MoE 训练剖析
2.5 中的 MoE 增加了稠密训练从未有过的部分:为每个 token 挑选八个专家的路由器、工作量可能相差悬殊的专家,以及在 GPU 之间搬运 token 的 all-to-all。它们每一个都可能拖慢训练或损害 loss,而与稠密参照之间的差距,本身并不能告诉你是哪个部分造成的。
下图以比我们的模型更小的规模绘制一个 MoE 层:16 个专家、top-4,而不是 64 个和 top-8,外加我们的模型没有的一个共享专家。图中画出了一个 batch 的 token、路由器、专家,以及汇总各专家输出的求和。之后每一节都会打开同一幅图的自己的视图,并放大到该节所涉及的部分,这样你可以直接跳到需要的部分。少数视图还带有该节的一项结果,比如 Step 3.5 Flash 的训练 loss 没能暴露出来的“流氓专家”(3.6)15。

在 3.0 的监控配置之后,我们从路由器内部开始:它的分数如何变成被选专家的权重,以及是 token 选专家还是专家选 token。接着是专家之间负载不均、用多少个专家以及每个多大、哪些层完全有专家,以及如何启动一次训练并保持其稳定。最后讲训练一步的时间在 GPU 上花在了哪里。
3.0 监控:一次打开,长期受益
在改动任何设置之前,先打开能告诉你改动是否奏效的监控。你现在不必明白每个数字的含义:每一节在第一次需要某个指标时会介绍它(3.1 中的 z-loss、3.2 中的 MaxVio、3.7 中的耗时和显存)。附录 A.1 给出了每项测量的采集命令、计算方式和局限。
要打开什么
2.5 的运行已经按层记录路由器的各项 loss(--moe-per-layer-logging),所以你可以看出哪一层表现异常(3.1、3.3、A.1)。请保留 2.4 中的 Trackio 启动器,并把这些参数加到 2.5 的参数之上:
--save <dir> --save-interval <m>
--save-tokens-per-expert-interval <n>
--log-throughput --log-params-norm
--log-num-zeros-in-grad --log-max-attention-logit
Megatron 把 token 计数和下面的激活转储写在 --save 之下(training.py#L3398-L3401),并要求在旁边设置 --save-interval(arguments.py#L1321-L1323),所以这次运行也会在那里保存检查点。下一个参数记录每个专家收到了多少 token(3.3、A.1)。其余四个跟踪运行的健康状况:吞吐、参数范数、梯度中的零,以及最大的注意力 logit(3.6、A.1)。标量指标出现在与你的基线相同的 Trackio 项目中,而路由抓取数据保存在各自的文件里。NaN 检查已默认开启(arguments.py#L2825-L2827)。
需要时再抓取什么
另有两项测量属于有限抓取:在有问题需要时再运行它们。
路由 trace 记录每个 token 选了哪些专家(3.1、3.3、A.1)。它挂在路由器上的 hook 在 CUDA graph replay 下不会触发(router_trace.py#L23),并且默认会对每次迭代都做 trace(training_config.py#L363-L367),所以请关掉 graph 并限定范围:
--moe-routing-trace-path <dir> --moe-routing-trace-max-training-iters <n>
--cuda-graph-impl none
激活转储把专家的激活保存在同一个 --save 目录下,这样你可以离线计算每个专家的激活范数(3.4、A.1):
--save-activations-interval <n>监控打开之后,让我们从每个 token 的起点——路由器——开始。它挑选专家,但每个专家在该 token 的输出中占多大分量?
3.1 路由器打分:logits 如何变成权重
路由器把每个 token 变成每个专家一个 logit,而在普通的 top-k 路由中,logit 最高的 k 个决定 token 去往哪些专家。在这些 logits 与混合专家输出的权重之间,有四项选择。门控函数、输出缩放(乘在被选专家输出加权和上的一个常数)和锐度(路由器分数有多尖锐,也就是排名第一的专家占多大主导)改变每个被选专家在 token 输出中占的分量,以及该输出有多大。在普通的 top-k 路由中,对于给定 token 的 logits,它们都不会改变哪些专家胜出:要么保持专家的顺序不变,要么在 top-k 之后才生效。
精度是个例外。bf16 路由器可能把两个相近的 logit 舍入成同一个值,从而改变胜出者,这使 fp32 路由器成为此处总是应当采用的一项设置。
下表给出十个当前开放 MoE 对这四项各自的选择,每个模型一行。
| 模型 | 门控函数 | 输出缩放 | 锐度 | 路由器精度:训练时;推理代码中 |
|---|---|---|---|---|
| DeepSeek-V4.1-Flash | sqrt(softplus) | 重新归一化,k = 6 时为 1.5(√k = 2.45) | 温度设置,保持为 1.016 | 未说明;fp3216 |
| Gemma 4 26B-A4B | softmax | 重新归一化,然后乘以每个专家各自学习到的缩放,k = 8(共 128 个专家)(√k = 2.83)17 | 归一化的路由器输入:RMSNorm、一个学习到的缩放以及 1/√d17 | 未说明;bf16,softmax 使用 fp3217 |
| GLM-5.3 | sigmoid | 重新归一化,k = 8 时为 2.5(√k = 2.83) | 无 | 未说明;fp3218 |
| Inkling | sigmoid,在 top-6 及其 2 个共享专家上联合归一化19 | 8.0 乘以一个学习到的全局缩放,作用于 6 个路由专家加 2 个共享专家(√8 = 2.83)19 | 无 | 未说明;bf1619 |
| Kimi K3 | sigmoid | 重新归一化,k = 16(共 896 个专家)时为 1.0(√k = 4)20 | 无 | 在后训练 QAT 中高于 MXFP421;fp3220 |
| MiMo-V2.6-Pro-RL | sigmoid | 重新归一化,无缩放因子,k = 8(√k = 2.83) | 无 | 未说明;fp3222 |
| North-Mini-Code | sigmoid | 未重新归一化:权重即原始分数,k = 8(共 128 个专家)23 | 无 | 未说明;bf1623 |
| Qwen3.8-Flash-Next | softmax24 | 重新归一化,无缩放因子,k = 10(√k = 3.16)24 | 无 | 未说明;bf16,softmax 使用 fp3224 |
| Step-5-Preview | sigmoid25 | 重新归一化,k = 8(共 352 个专家)时为 3.0(√k = 2.83)25 | 无 | 未说明;fp3225 |
| ZAYA1-8B | 对 MLP 路由器的 logits 做 softmax26 | 未重新归一化,从 16 个专家中取 top-1,外加一个跳过专家26 | 无 | RL 期间 softmax 使用 fp32;bf1626 |
先从门控函数说起。如果它从不改变胜出者,那它改变的是什么?
门控函数
Softmax、sigmoid 和 sqrt(softplus) 对专家的排序方式相同,所以不同的是每个被选专家得到的权重。下图把一个 token 的 logits 从不确定的路由器提高到自信的路由器:softmax 使排名第一的专家占比越来越大,而 sigmoid 在大 logits 处饱和,所以自信的专家最终得到相等的权重。当选择只使用门控分数本身时,门控函数保持排序不变。3.3 的专家偏置(expert bias)是在选择之前加到门控后分数上的(moe_utils.py#L936-L938),所以它能把一个专家挪动多远取决于分数的大小,不同的门控函数可能改变 top-k。分组限制路由(3.7)同样可能,因为它通过对各组最高分求和来选组(moe_utils.py#L712-L715)。

图中,sqrt(softplus) 落在 softmax 与 sigmoid 之间:对于正的 logits,随着尺度增大,两个权重之比趋向于它们 logits 之比的平方根。DeepSeek-V4 从 sigmoid 换成了 sqrt(softplus)27。在 Megatron 中,3.3 的专家偏置需要 sigmoid 或 sqrt(softplus):启动时它会拒绝 softmax 与偏置的组合(transformer_config.py#L3139-L3147),而它的 softmax 路径从不加偏置。提出该偏置的 Wang 等人28解释了它为什么与 softmax 不太匹配:softmax 的归一化使两个专家之间的差距取决于其他每个专家的分数,因此偏置更难调。他们仍然用它平衡了一个 softmax 路由器28。辅助损失对这三种都适用(moe_utils.py#L998-L1014)。
Megatron 源码
moe_utils.py#L913-L927(softmax,在 top-k 之前或之后)
913if score_function == "softmax":914if use_pre_softmax:915scores = torch.softmax(logits, dim=-1, dtype=torch.float32)916if precomputed_indices is not None:917top_indices = precomputed_indices918probs = torch.gather(scores, dim=1, index=top_indices)919else:920probs, top_indices = compute_topk(scores, topk, num_groups, group_topk)921else:922if precomputed_indices is not None:923top_indices = precomputed_indices924scores = torch.gather(logits, dim=1, index=top_indices)925else:926scores, top_indices = compute_topk(logits, topk, num_groups, group_topk)927probs = torch.softmax(scores, dim=-1, dtype=torch.float32)
moe_utils.py#L928-L941
928elif score_function in ("sigmoid", "sqrtsoftplus"):929if score_function == "sigmoid":930scores = torch.sigmoid(logits.float())931else:932scores = torch.nn.functional.softplus(logits.float()).sqrt()933if precomputed_indices is not None:934top_indices = precomputed_indices935scores = torch.gather(scores, dim=1, index=top_indices)936elif expert_bias is not None:937scores_for_routing = scores + expert_bias.float()938_, top_indices = compute_topk(scores_for_routing, topk, num_groups, group_topk)939scores = torch.gather(scores, dim=1, index=top_indices)940else:941scores, top_indices = compute_topk(scores, topk, num_groups, group_topk)
(sigmoid、sqrt(softplus),偏置仅用于选择),
transformer_config.py#L3139-L3147(softmax 下拒绝使用偏置)
3139if self.moe_router_enable_expert_bias and self.moe_router_score_function not in (3140"sigmoid",3141"sqrtsoftplus",3142):3143raise ValueError(3144"Expert bias for aux-loss-free routing only supports 'sigmoid' and 'sqrtsoftplus' "3145"score functions. Please set --moe-router-score-function to 'sigmoid' or "3146"'sqrtsoftplus', or unset --moe-router-enable-expert-bias."3147)
一旦所有 logits 都很大且为正,sigmoid 就会给被选专家相等的权重,这正是模拟中放大后的 token 的终点:一个自信的路由器配上“锐度”一节所说的平坦门控。要判断一次运行的路由器是否到了这一步,请在打开 logits 的情况下记录路由 trace(A.1),并逐层跟踪两个数字:排名第一的专家的权重,以及路由熵——当一个专家占据大部分权重时熵低,权重分散时熵高。
当你用专家偏置做均衡时(3.3),请使用 sigmoid(或 sqrt(softplus)),因为 Megatron 不接受 softmax 搭配偏置。否则请使用 softmax,这是 Megatron 的默认值。
路由器的权重承担两项工作。它们挑选专家,同时也是混合各专家输出的数字:该层返回每个被选专家的输出乘以其权重后的总和。门控函数决定每个被选专家相对于其他专家占多少分量,却不决定它们合起来占多少:使用 softmax 时,top-k 权重之和小于 1,而且每个 token 的差额不同,因此该层输出的大小也随之变动。那么,这个合并后的输出应该多大?
输出缩放
有两项设置决定专家合并输出的大小。第一项是重新归一化:把 k 个被选权重重新缩放到总和为 1,输出的大小就不再随它们的总和变化。在 Krajewski 等人的实验中,重新归一化使粒度 8 下的验证 loss 从 2.219 降到 2.183粒度 8:专家缩小为 1/8、数量变为 8 倍,每个 token 选中的数量也变为 8 倍,因此参数量和计算量保持不变;3.4 比较了不同的粒度。29。Megatron 默认进行重新归一化(moe_utils.py#L913-L942),--moe-router-pre-softmax 会关闭重新归一化。top-1 的 softmax 需要该参数:只选一个专家时,对它唯一的 logit 做 softmax 结果恒为 1,于是路由器得不到梯度(transformer_config.py#L3213-L3221)。

该模拟让玩具 token 从不确定的路由器扫到自信的路由器,各专家互不相关且 RMS 相等:不做重新归一化时,路由输出的大小随 top-k 概率质量变化,而重新归一化使其保持在单个专家 RMS 的 1/√k 到 1 倍之间。
第二项设置是路由缩放因子(routed scaling factor),即乘在结果上的常数。之所以需要它,是因为即使重新归一化之后,路由输出的大小仍取决于每个专家占多少分量。当全部权重都在一个专家上时,输出具有该专家的均方根(RMS)。当 k 个互不相关、RMS 相等的专家权重相等时,它降为该值的 1/√k,而接近 √k 的路由缩放因子可以将其恢复。DeepSeek-V3 在 k = 8 时使用 2.530,Kimi K2 使用 2.827 ≈ √8。已发布的模型在其取值上并不一致:上表中只有 GLM-5.3 和 Step-5-Preview 保持在 √k 附近,而 Kimi 从 K2 的 √8 变成了 K3 中 k = 16 时的 1.020。缩放路由输出也会改变它相对于共享专家输出的权重(3.4)。
图中最后一行缩放的是专家的输入而不是输出:Llama 4 把每个 token 送到一个专家,并在专家运行之前把 token 乘以该专家的 sigmoid 分数31。它的 SwiGLU 专家没有 bias,所以输出大致按分数的平方缩小,而分数也会使 SiLU 门变得平缓。
Megatron 源码
moe_utils.py#L942-L947(先重新归一化,再缩放)
942probs = scores / (scores.sum(dim=-1, keepdim=True) + 1e-20) if topk > 1 else scores943else:944raise ValueError(f"Invalid score_function: {score_function}")945946if scaling_factor:947probs = probs * scaling_factor
transformer_config.py#L3213-L3221(top-1 需要 pre-softmax:对单个 logit 做 softmax 会得到零梯度)
3213if (3214self.moe_router_topk == 13215and self.moe_router_score_function == "softmax"3216and not self.moe_router_pre_softmax3217and self.moe_router_load_balancing_type != "sinkhorn"3218):3219# Requires applying softmax before selecting the top-k when k is 1,3220# since softmax on a [num_tokens, 1] would yield a zero gradient.3221raise ValueError("Please use --moe-router-pre-softmax when topk is 1.")
不做重新归一化时,路由输出的大小会逐个 token 地跟随 top-k 概率质量——也就是上面得到更高 loss 的那种设置——所以要关注的数字是每个 token 的路由输出有多大,即其平方权重之和的平方根。请根据路由 trace 离线计算(A.1)。
top-k > 1 时请保持重新归一化开启,对 top-1 的 softmax 请使用 --moe-router-pre-softmax,否则路由器得不到梯度。路由缩放因子没有定论:√k 只在互不相关的专家权重相等时才能恢复路由输出的 RMS,而已发布的模型对其取值并不一致。
权重和输出的大小都取决于 logits 有多尖锐。路由器可能变得太尖锐——一个专家独占全部权重,也可能太平坦——把它的 top-k 平均化。是什么决定了它有多尖锐?
锐度
使用 softmax 时,线性路由器会随着 token 的范数或路由器权重增大而变得更尖锐:logits 被拉开,排名第一的专家占据更多权重。下图将三种控制方式与线性路由器作比较。Logit soft-capping 主要压缩接近其上限的 logits。对路由器输入做归一化,去掉了来自 token 范数的那部分影响。Gating logit normalization 对各专家的 logits 做标准化32,使它们的离散程度被设定在选定的尺度上。

图中普通的线性路由器会随着 token 的范数或路由器矩阵增大而变尖,而 soft-capping(Grok 2 以 30 为上限且不做重新归一化33)只有在 logits 接近上限时,才会把大范数 token 的最大权重拉回来。像 Gemma 4 那样对输入做归一化17,会让两个 token 的路由相同,但随着矩阵增大仍然会变尖;而 gating logit normalization 则不受二者影响。Skywork-MoE 使用 gating logit normalization 来对付门控过于平坦、导致该层对其 top-k 专家取平均的问题34。使用它后,训练 loss 略有降低35。对路由器输入做归一化只是与专家 embedding 一起做过消融36。
Megatron 源码
router.py#L1150-L1152(jitter,然后是普通线性门控)
1150# Apply input jitter1151input = self.apply_input_jitter(input)1152logits = self.gating(input)
router.py#L824-L831(乘性输入 jitter)
824if self.config.moe_input_jitter_eps is not None:825eps = self.config.moe_input_jitter_eps826if self.input_jitter is None:827self.input_jitter = torch.distributions.uniform.Uniform(828torch.tensor(1.0 - eps, dtype=input.dtype, device=input.device),829torch.tensor(1.0 + eps, dtype=input.dtype, device=input.device),830).rsample831return input * self.input_jitter(input.shape)
平坦的门控——即把 top-k 专家取平均、使模型学得更差——表现为 Max1/Max2(排名第一的专家权重与第二的权重之比)向 1 下降,就像 Skywork-MoE 中未做归一化时那样35。请连同排名第一的专家权重一起,从路由 trace(A.1)中逐层跟踪它。
如果门控变平,gating logit normalization 在 Skywork-MoE 中解决了这个问题。对于路由器输入,Megatron 提供 Switch 风格的乘性输入 jitter,即 --moe-input-jitter-eps。
锐度存在于 logits 之间的差距里,而 softmax 会忽略它们共同的平移。bf16 则不会:如果所有 logits 一起向上漂移,bf16 能表示的数值彼此间隔变大,相近的专家就可能打平。这些平局会改变哪些专家胜出吗?
精度
Top-k 对并列专家的排序方式,PyTorch 并未规定37。下图模拟了用 bf16 路由器对同样的 token 做 64 个专家、top-8 的路由,分别带与不带 z-loss(对 logits 的 logsumexp 的惩罚项)。它模拟的 logits 以一个共同的偏移量向上漂移,并统计专家与 fp32 路由器所选不同的 token 数。

随着模拟偏移量升高,bf16 路由器的 logits 落在越来越粗的网格上,有更多 token 得到与 fp32 不同的专家。Z-loss 通过把 logits 推向负值来降低 logsumexp。在 64 选 8 时,第 8 个 logit 大约比 logsumexp 低 3.5,所以在模拟中,它在有 z-loss 时落在约 −2.2,没有时则落在 +3.6,这是 bf16 以相同步长取整的两个大小,换专家的 token 数也大致相同;只有 fp32 路由器没有翻转,因为 fp32 的取整比 bf16 精细 65,536 倍38。DeepSeek-V3.2、GLM-4.5 和 Kimi K2.5 在其推理代码中以 fp32 计算路由器39。使用 fp32 的理由建立在训练证据之上,这关乎稳定性。在 Switch Transformers 中,bf16 路由器发散了,而 fp32 路由器以 bf16 的速度完成了训练40。在 ST-MoE 中,路由器 z-loss 使每次运行都保持稳定41。各实验室很少说明路由器是以什么精度训练的:上表中,10 份报告里只有 2 份提到了它,而 10 个模型里有 5 个在推理代码中以 bf16 执行路由器的矩阵乘法。在路由器保持精度的前提下,该层其余部分能降到比 bf16 低多少,是 3.7 精度要回过头来讨论的问题。
Megatron 源码
router.py#L124-L130(路由器 dtype)
124# Convert to specified datatype for routing computation if enabled125router_dtype = input.dtype126if self.config.moe_router_dtype == 'fp32':127router_dtype = torch.float32128elif self.config.moe_router_dtype == 'fp64':129router_dtype = torch.float64130logits = router_gating_linear(input, self.weight, self.bias, router_dtype)
moe_utils.py#L1424-L1435(bf16 操作数,fp32 logits)
1424if te_general_gemm is not None and router_dtype != torch.float64:1425# cuBLASLt's non-FP8 bias epilogue expects bias and output to have the same1426# dtype. Router parameters may be BF16 while router logits are FP32, so cast the1427# small bias vector before passing it to TE.1428gemm_bias = bias.to(router_dtype) if bias is not None else None1429output = te_general_gemm(weight, inp, router_dtype, layout="TN", bias=gemm_bias)[0]1430elif bias is None:1431output = torch.mm(inp.to(router_dtype), weight.to(router_dtype).t())1432else:1433output = torch.addmm(1434bias.to(router_dtype), inp.to(router_dtype), weight.to(router_dtype).t()1435)
moe_utils.py#L171-L184(z-loss)
171logsum = torch.logsumexp(logits, dim=-1)172z_loss_values = torch.square(logsum)173174if padding_mask is not None:175# Invert padding_mask: True (padding) -> 0, False (valid) -> 1176valid_mask = ~padding_mask177# Only compute z_loss for valid (non-padding) tokens178z_loss_values = z_loss_values * valid_mask179# Compute mean over valid tokens only180num_valid_tokens = valid_mask.sum()181z_loss = z_loss_values.sum() / torch.clamp(num_valid_tokens, min=1.0) * z_loss_coeff182else:183z_loss = torch.mean(z_loss_values) * z_loss_coeff184return z_loss
router.py#L761-L764(作用于 TP×CP 的 z-loss 系数)
761if self.config.moe_z_loss_coeff is not None and self.training and torch.is_grad_enabled():762# Skip Z loss calculations when using torch.no_grad() or checkpointing.763moe_z_loss_coeff = self.config.moe_z_loss_coeff / self.tp_cp_group.size()764z_loss = z_loss_func(logits, moe_z_loss_coeff, padding_mask=padding_mask)
bf16 路由器可能使训练发散,就像在 Switch Transformers 中那样,所以有两个信号值得跟踪:z-loss,它反映 logits 向上漂移了多远;以及翻转率,即把路由器用 fp32 重新计算时专家发生变化的 token 占比。设置 --moe-z-loss-coeff 时,Megatron 会记录 z-loss,且已除以该系数(router.py#L805-L807),所以它的平方根就是 RMS logsumexp:我们的运行记录到 20.9,对应的 RMS logsumexp 约为 4.6。翻转率需要对相同输入和当前路由器状态做匹配的抓取;A.1 提供了一个有限范围的在线 hook,因为 trace 的初始权重快照不会跟随之后的训练更新。
请始终设置 --moe-router-dtype fp32。对 logits 向上漂移的 softmax 路由器,再加上 --moe-z-loss-coeff 1e-3,这是 ST-MoE 的取值。DeepSeek-V3 的报告对其 sigmoid 路由器从未提及 z-loss42。
该看什么
| 部分 | 症状 | 需要关注的信号 |
|---|---|---|
| 门控函数 | 排名第一的专家权重与路由熵,逐层获取,来自打开 logits 的路由 trace(A.1)。 | |
| 输出缩放 | learns badly:不做重新归一化时,路由输出会随 top-k 概率质量缩放。重新归一化降低了 loss29。 | 每个 token 的路由输出有多大,即 √(Σ w²),来自路由 trace(A.1)。 |
| 锐度 | learns badly:门控变平时,该层会对其 top-k 专家取平均35。 | 排名第一的专家权重与 Max1/Max2(它的权重与第二名专家权重之比)35,逐层获取,来自路由 trace(A.1)。 |
| 精度 | blows up:bf16 路由器在 Switch Transformers 中发散了40。 | 记录的 z-loss 已除以其系数,所以它的平方根就是 RMS logsumexp:20.9 对应约 4.6。请使用 A.1 的匹配在线 hook,以相同的输入和当前路由器状态来测量 fp32 路由翻转;trace 的初始权重快照无法精确重放之后的训练前向。 |
至此,我们已经塑造了 token 的 logits 变成权重的方式。门控函数决定每个被选专家占多少分量,重新归一化与缩放因子决定它们合并后的输出有多大,锐度与精度决定分数有多尖锐、有多精确。这一切都假设了同一种配置:一个学习得到的路由器,由 token 挑选它的 top k。这两点都可以改变:专家可以反过来挑选 token,固定的表也可以取代学习得到的选择。该由谁来做选择——token 还是专家?这个选择又是否需要学习?
3.2 路由策略:谁来选,以及怎么选
Token-choice top-k 是默认做法:每个 token 给所有专家打分,并保留最高的 k 个。本节考察改变这一做法的两种方式:让专家来挑选它的 token,而不是 token 挑选专家;或者由一个固定的哈希来选,完全没有学习得到的路由器。
| 模型 | 谁来选 | 按 token id 查表 |
|---|---|---|
| DeepSeek-V4-Pro | token choice | 前 3 个 MoE 层使用哈希路由44 |
| DeepSeek-V4.1-Flash | token choice | 第 1 层和第 14 层使用 Engram n-gram 记忆(2 到 4 元组);无哈希路由45 |
| EC-CF2 8B/64E (Zhou et al.)43 | expert choice | 无 |
| GLM-5.3 | token choice | 无 |
| Kimi K3 | token choice | 无 |
| Llama 4 Maverick | token choice | 无46 |
| MiMo-V2.6-Pro-RL | token choice | 无 |
| Qwen3.8-Flash-Next | token choice | 第 1 层使用 n-gram embedding(2 元组和 3 元组)47 |
| Step-5-Preview | token choice | 无48 |
在问选择是否需要学习得到的路由器之前,我们得先确定由谁来做选择,因为在 token choice 下,很多 token 可能都想要同样的专家,负载就会倾斜。应该继续让每个 token 挑选它的专家,还是改让每个专家挑选它的 token?
谁来选
在 token choice 下,很多 token 可能想要同样的专家,所以负载会倾斜。Expert choice 把角色对调:每个专家取走它最匹配的 token,所以每个专家得到相同的负载43。代价是未来 token 泄漏49:一个 token 能否得到某个专家,取决于它之后的那些 token。推理时这些 token 还不存在,所以路由与训练时不同50。
Expert threshold(下图中的第三条规则)在不看未来 token 的前提下,让各专家的负载保持接近均匀50。作为交换,每个 token 得到的专家数量是可变的。在一个 5.75 亿参数的模型中,无论是否做均衡,它都达到了比 token choice 更低的 loss(2.844 对比约 2.89)51。

图中,序列偏向专家 1,而未使用均衡器的 token choice 使它过载。Expert choice 平衡了负载,但后面的 token 会挤掉前面的选择;expert threshold 的阈值来自同样偏向的前几个 batch,它让负载保持在目标附近而无需修改任何选择,代价是每个 token 的专家数量不固定。
Megatron 源码
moe_utils.py#L891-L897(逐 token top-k,仅限 token choice)
891# Sorting top-k turned off during inference892return torch.topk(893scores,894k=topk,895dim=1,896sorted=torch.is_grad_enabled() or is_batch_invariant_mode_enabled(),897)
token choice 留下的倾斜使训练步变慢。它体现在 token 计数——每层每个专家的 token 数——上,由 --save-tokens-per-expert-interval 记录(A.1),用 MaxVio 来读最直观,即最忙的专家的负载比平均值高出多少MaxVio 是 maximal violation(最大违背)的缩写:(最忙专家的负载减去平均负载)除以平均负载。0 表示完全均匀;1 表示最忙的专家得到的是平均值的两倍。提出 3.3 专家偏置的 Wang 等人定义了它。52。
请使用 token choice,即 Megatron 所训练的路由方式,用 --moe-router-topk 设置 k。
无论是 token 还是专家来挑选,到目前为止的选择始终来自一个学习得到的路由器,所以路由本身必须经过训练。路由真的需要学习吗?还是可以用一条更简单的规则来挑选专家?
哈希层
在 DeepSeek-V4 的前 3 个 MoE 层中,一张固定的表把每个 token id 映射到它的专家53,路由器只保留用于计算权重54。该表是 token id 的固定哈希27,在我们的探测中,它对高频 token 的分散效果并不比随机表更好。选择本身没有什么可学的,哈希层在最大 4.5B 的模型中与 Switch 和 BASE 层Lewis 等人的平衡专家分配方法,通过求解线性指派来路由,使每个专家获得相同数量的 token。表现相当55。下图把学习得到的路由与哈希路由并排放置,上方再加上第三种按 token id 的查找:Engram,它把每个 token 的最后 2 到 4 个 token 哈希到 embedding 表中,并把读到的行加到隐藏状态上56。DeepSeek-V4.1-Flash 在两个层保留了 Engram,但每一层的专家都由它学习得到的路由器来挑选57,58。

图中的两个路由器对“the”这个词的处理不同:学习得到的路由器依据上下文为每一个“the”做选择,而哈希层把每一个“the”都送往其表行所指定的六个专家,哪怕绕过了得分更高的专家。两行都对各自的六个专家加权,使其总和等于 V4-Flash 的路由缩放因子 1.559,图中通过平均 Jaccard 相似度来衡量四个“the”的专家集合有多相似。哈希层放弃的是上下文:同一个 token id 总是选中相同的专家,不管它周围是什么。它的扩展性也比学习得到的路由差。Clark 等人改变了模型中有多少层是 MoE 层。只有一个 MoE 层时,哈希路由在他们比较的各种路由方法中达到了最低的 loss,但随着更多层成为 MoE 层,它不再继续改进,而他们学习得到的路由器则不断变好60。而且没有任何偏置能为它重新均衡54:高频 token 可能使它们被分配的专家过载,却没有什么能把它们挪开。V4.1-Flash 去掉了哈希层,只保留不挑选任何专家的 Engram45。
在 Megatron 中,--moe-num-hash-layers 使前几个 MoE 层成为哈希层(router.py#L304-L308)。它们从一张 token 到专家的表(tid2eid)中读取每个 token 的专家,词表的每一项对应一行;如果你没有加载,Megatron 会用一个 round-robin 占位表来填充(router.py#L313-L329)。由于这些层中专家偏置是关闭的,训练期间没有任何东西会纠正一张糟糕的表,所以这张表很重要。Roller 等人比较了构建它的方法:随机表,以及把最高频的 token 贪心地分散到最空闲专家上的表,达到了差不多的困惑度,后者的均衡性更好;而通过聚类 embedding 把相似 token 分组的方法则明显更差61。
Megatron 源码
router.py#L304-L308(前 N 层使用哈希)
304self.is_hash_layer = (305not self.is_mtp_layer306and hash_moe_layer_threshold > 0307and layer_number <= hash_moe_layer_threshold308)
router.py#L322-L326(占位的 round-robin 表)
322token_ids = torch.arange(self.config.hash_moe_vocab_size, device=self.weight.device)323expert_offsets = torch.arange(self.topk, device=token_ids.device)324self.tid2eid = ((token_ids[:, None] + expert_offsets) % self.num_experts).to(325torch.int32326)
router.py#L898-L905(按 token id 查找专家)
898flat_ids = input_ids.T.reshape(-1)899assert flat_ids.numel() == logits.shape[0], (900f"input_ids contains {flat_ids.numel()} tokens, but router logits contain "901f"{logits.shape[0]}."902)903# Token IDs address the real tokenizer vocabulary; reject out-of-range IDs,904# including negative IDs, without clamping them to another token's experts.905default_top_indices = self.tid2eid.index_select(0, flat_ids).long()
router.py#L914-L916(权重仍来自门控)
914def _compute_hash_topk(scores, topk, num_groups=None, group_topk=None):915del topk, num_groups, group_topk916return scores.gather(1, default_top_indices), default_top_indices
外加几行代码,从 Hub 加载 V4-Flash 的 layers.0.ffn.gate.tid2eid 并统计每个专家的 token 数
一张使部分专家过载的表会让训练步变慢,而且训练期间没有什么机制会重新均衡它,所以请在训练早期检查它:把哈希层中每个专家的 token 数与学习层中的相比较,数据来自 --save-tokens-per-expert-interval 写出的 token 计数(A.1)。
仅在复现 DeepSeek-V4 的前几层时使用它。请像 V4 那样加载固定的哈希表27,或者加载频率均衡的表,而不要使用 Megatron 的 round-robin 占位表。
该看什么
| 部分 | 症状 | 需要关注的信号 |
|---|---|---|
| 谁来选 | slow:在 token choice 下,一些专家得到的 token 比另一些多。learns badly:在 expert choice 下,推理时的路由与训练时的路由不同。 | 逐层的 MaxVio52,即最忙专家的负载比平均值高出多少,来自 token 计数(A.1)。 |
| 哈希层 | slow:高频 token 可能使其哈希所分配的专家过载,且没有任何偏置能把它们挪开。 | 哈希层中每个专家的 token 数,与学习层相比较,来自 token 计数(A.1)。 |
Expert choice 和 expert threshold 使负载保持均匀或接近均匀,而且没有偏置能改变哈希表的负载。Megatron 训练的是学习得到的 token choice,到目前为止,没有任何机制阻止许多 token 挤到同样那几个专家上。拥挤的专家是 MoE 的第一个真正的失败模式,那么,在路由器持续学习的同时,我们如何让 token 均匀地分布在各专家上?
3.3 负载均衡
当许多 token 选择同样的专家时,会出两个问题。持有最忙专家的 GPU 工作最多,其他 GPU 都要等它,因此它决定了单步耗时;而且如果路由器持续把 token 送给同样那几个专家,其他专家得到的 token 很少,它们的参数大多闲置。第一项代价更容易测量:在强制路由均匀的情况下,同一个模型在初始化时快了 1.5 倍。
强制路由均匀只能告诉你应当追求的速度,因为它抛弃了路由器学到的东西。要在路由器持续学习的同时接近这个速度,有两类修复方法——辅助损失和无损失偏置——它们以不同方式平衡负载。辅助损失(aux loss)加入一项奖励均匀负载的项,使路由器的梯度推动其概率朝着分散 token 的方向变化,代价是该梯度会与 LM loss 竞争。偏置则只改变选择哪些专家。无论选哪一种,它所平衡的范围(一条序列、一个 micro-batch 还是全局 batch)决定了“均衡”的含义。
| 模型 | 辅助损失 | 范围 | 选择偏置 | 分位数均衡 |
|---|---|---|---|---|
| DeepSeek-V362 | 小的序列级损失,系数 0.0001 | batch 范围的偏置加序列级损失 | 固定步长的专家偏置 | 否,固定步长更新 |
| DeepSeek-V4.1-Flash63 | 小的序列级损失,系数 0.0001 | 文本和图像的负载分别均衡,外加序列级损失 | 按模态分别设置偏置,更新速度 0.001 | 使用无辅助损失的偏置策略 |
| Kimi K364 | 被描述为无辅助损失 | 全局 batch | 偏置由分数间隔推导,下一步生效 | 是,全局 batch 直方图估计 |
| LongCat-Flash65 | 设备级均衡损失 | 全局 batch 的 FFN 目标,加序列内的设备级均衡 | PID 控制的专家偏置;恒等专家(identity experts)不参与偏置更新 | 否,PID 更新 |
| MiMo-V2.6-Pro-RL66 | RL 期间冻结路由器 | 保留 RL 之前的路由器 | 报告评估的是冻结,而不是新的偏置更新规则 | RL 中未报告新的均衡更新 |
| Qwen3 MoE67 | 全局 batch 均衡损失 | 全局 batch | 已发布的路由器中没有选择偏置68 | 否,辅助损失方法 |
在比较各种均衡器之前,我们需要知道负载不均衡要耗费多少速度,因为下面每个均衡器都应该拿来与强制均匀路由的吞吐相比较。那个 1.5 倍从何而来,我们又如何在自己的环境中测量它?
不均衡的代价
为了看看不均衡的代价,我们用三种方式对同一个模型进行路由。强制均匀路由,即 Megatron 的 --moe-router-force-load-balancing,把路由器的 logits 换成随机值,使每个专家得到差不多相同的负载,这是最佳情形,吞吐为 149.4 TFLOP/s。
强制偏置路由,即 --moe-router-force-biased,向这些随机 logits 加上一个大小不断增长的共享随机偏置,使少数专家得到越来越多的 token:这是一个调节负载不均程度的旋钮。旋钮拧到尽头时,吞吐降到 100.5 TFLOP/s;对该路由的重放(其辅助损失与记录的相符)显示,最忙的专家接收了每一个 token,MaxVio 为 7,这是 64 选 8 的路由所能达到的最不均匀的程度。情况还可能更糟:在重放中最忙的专家分散在多块 GPU 上,所以最忙的 GPU 只持有大约两倍于平均的负载;如果它们全都在同一块 GPU 上,那块 GPU 就要承担大部分专家工作。
学习得到的路由器——也就是你实际训练时使用的那个——起点离这个最佳情形很远:刚初始化的路由器前 40 次迭代的运行速度,与最差的强制情形一样慢。下图比较了这三者。训练必须在不强制路由器选择的前提下缩小这个差距,而本节其余部分将按各均衡方法使学习得到的路由器接近强制均匀吞吐的程度来比较它们。

图中,随着强制偏置越来越大,少数专家占去更多 token,吞吐随之下降,而学习得到的路由器起点处在最不均匀的强制运行的水平。最忙的专家决定了单步耗时,因为 all-to-all 会把每个路由到该 GPU 本地专家的 token 都交给这块 GPU(我们的运行中是 64 个专家里的 8 个),而下一次 all-to-all 要等最慢的 GPU。一块 GPU 的负载是其本地专家负载之和,所以它可以比逐专家的负载更均衡。这就是为什么均衡损失也可以按 GPU 而不是按专家来作用:DeepSeekMoE 的设备级均衡损失把每块 GPU 上的专家合并成一项69,下一幅图把它与专家级损失做了比较。

在一个玩具 batch 上训练,每块 GPU 上有两个专家,其中一个属于 LM 偏爱的四个专家,两种损失都能平衡各 GPU,而设备级损失把路由器从 LM 想要的结果上拉开的幅度更小,因为它只看到每块 GPU 的总量,而这种放置方式使该总量更接近均匀。问题在于每块 GPU 内部的专家仍然不均匀,所以某个专家仍然可能占去其所在 GPU 的大部分 token。DeepSeekMoE 对这两项损失采用不对等的权重,理由相同:严格的专家级均衡会损害模型质量,所以它设置较大的设备级系数,并保留一个较小的专家级系数以防路由塌缩69。DeepSeek-V2 以 0.05 对 0.003 来运行它们70。DeepSeek-V3 的报告中不再提及设备级损失:它用一个偏置和一个小的序列级损失来平衡每个专家,二者都在本节稍后介绍42。
同样的不均衡在推理服务中同样耗费时间,所以生产环境中的前沿 MoE 会把它控制得很小:DeepSeek 在服务 DeepSeek-V4.1-Flash 时,其最慢的 GPU 至多是平均值的 1.09 倍71。
Megatron 源码
router.py#L1185-L1193(前向中的强制开关)
1185if self.config.moe_router_force_load_balancing:1186# Apply force load balancing with random logits for benchmark1187logits = apply_random_logits(logits)11881189if self.config.moe_router_force_biased is not None:1190# Apply biased logits with shared random bias across all ranks1191logits = apply_biased_logits(1192logits, self.config.moe_router_force_biased, self.layer_number1193)
moe_utils.py#L1301-L1314(每个 rank 的随机 logits)
1301@staticmethod1302def forward(ctx, logits: torch.Tensor) -> torch.Tensor:1303"""1304Forward pass returns random logits with rank-specific seed.13051306Args:1307logits (torch.Tensor): The logits.13081309Returns:1310torch.Tensor: The random logits.1311"""1312with get_cuda_rng_tracker().fork(get_expert_parallel_rng_tracker_name()):1313random_logits = logits.clone().normal_()1314return random_logits
moe_utils.py#L1353-L1370(共享的逐层偏置)
1353@staticmethod1354def forward(ctx, logits, std, layer_number):1355"""Forward pass: apply random bias to logits."""1356# Check cache if reuse mode (negative std)1357if std < 0 and layer_number in RandomSTEShared._cache:1358return logits + RandomSTEShared._cache[layer_number]13591360# Generate random bias with shared seed across all ranks1361with get_cuda_rng_tracker().fork(get_data_parallel_rng_tracker_name()):1362bias = torch.empty(logits.shape[-1], device=logits.device, dtype=logits.dtype).normal_(1363std=abs(std)1364)13651366# Cache if reuse mode1367if std < 0 and layer_number is not None:1368RandomSTEShared._cache[layer_number] = bias13691370return logits + bias
不均衡表现为训练步变慢,所以要关注的数字是相对于强制均匀对照运行的 TFLOP/s。要了解损失的时间去了哪里,请看 3.7 中被 profile 的那一步:它运行在一个不均衡的路由器上,3.7 展示了如何判断拖慢其 all-to-all 的是否正是不均衡。
每个配置使用一次,作为对照运行:--moe-router-force-load-balancing 给出均衡的吞吐,用以与每个均衡器做比较。切勿用它来训练。
强制路由展示了均匀负载能跑多快,但它把路由器的 logits 换成了随机值,所以它只能作为对照运行,绝不能用来训练。我们该如何在训练过程中把学习得到的路由器引向均匀负载呢?先从最古老的修复方法——一个 loss 项——开始。
辅助损失
最古老的修复方法是加一个 loss 项,即辅助损失:系数乘以专家数,再乘以对各专家求和,其中每个专家占该 micro-batch 中 token 的比例乘以它的平均路由概率(moe_utils.py#L148-L152)。它的梯度把路由器的概率从 LM 想要的结果拉开,推向均匀负载。下面,四种设置对同一个 batch 做路由:不做均衡、系数小和系数大的辅助损失,以及无损失偏置。

图中两种均衡器都把负载分散开了,但方式不同:辅助损失把路由器的概率从 LM loss 想要的结果上拉开,系数越大拉得越远;而无损失偏置只改变选择哪些专家,均衡效果最好,不过它改动的选择也最多。辅助损失的这种拉力使它的系数成为一种权衡:系数太大会损失 LM loss,太小则使负载仍然不均匀。Yuan3.0 在一个 10B 模型上对 DeepSeek-V3 的序列级辅助损失做的消融(绘于下一幅图)显示了两个方面:测试 loss 随系数从 1e-3 到 0.1 的增大而上升,而最小的系数 1e-4 比完全不用辅助损失略好,但某一层里最忙专家的 token 数仍约是最闲专家的 13.6 倍72,73。

图中最小的系数使负载仍然不均匀,而能使负载均衡的 1e-2 则提高了测试 loss。Megatron 用 --moe-aux-loss-coeff 搭配 --moe-router-load-balancing-type aux_loss 来设置系数,每种 loss 类型一个系数,作用于每一层。Motif 3 发现它的前几个 MoE 层更容易受不均衡影响,并给这些层设置了更强的辅助损失权重74。我们在本章稍后会回到前几层。
Megatron 源码
moe_utils.py#L148-L152(Σ f·P 乘以系数)
148aggregated_probs_per_expert = probs.sum(dim=0)149aux_loss = torch.sum(aggregated_probs_per_expert * tokens_per_expert) * (150num_experts * moe_aux_loss_coeff / (topk * total_num_tokens * total_num_tokens)151)152return aux_loss
router.py#L515-L536(对一个 micro-batch 计数)
515aux_loss_coeff = self.get_aux_loss_coeff("aux_loss")516if aux_loss_coeff == 0:517return probs518519global_tokens_per_expert, local_num_tokens, total_num_tokens = (520get_tokens_per_expert_and_token_count(521routing_map=routing_map,522reduce_group=self.tp_cp_group,523topk=self.topk,524with_padding_mask=with_padding_mask,525)526)527528aux_loss = switch_load_balancing_loss_func(529probs=scores_for_aux_loss,530tokens_per_expert=global_tokens_per_expert,531total_num_tokens=total_num_tokens,532topk=self.topk,533num_experts=self.config.num_moe_experts,534moe_aux_loss_coeff=aux_loss_coeff,535fused=self.config.moe_router_aux_loss_fusion,536)
router.py#L459-L472(每种 loss 类型一个系数)
459def get_aux_loss_coeff(self, aux_loss_type: str) -> float:460"""Return the aux loss coeff for the given auxiliary loss type.461If the auxiliary loss type is not found, return 0.0.462"""463if isinstance(self.routing_type, str):464if self.routing_type == aux_loss_type:465return self.config.moe_aux_loss_coeff466if isinstance(self.routing_type, list):467try:468idx = self.routing_type.index(aux_loss_type)469return self.config.moe_aux_loss_coeff[idx]470except ValueError:471return 0.0472return 0.0
上面四列图下方的实测一行来自 Wang 等人,他们提出了无损失偏置,并在一个 1B、64 个路由专家、top-6 的 MoE 上,将其与逐序列的辅助损失进行比较。在他们 1e-3 的基线系数下,验证集上的 MaxVio 为 0.72,困惑度为 9.56;使用偏置时则分别为 0.04 和 9.5075;不用辅助损失时 MaxVio 升到约 5.1,而在 1e-2 时它降到约 0.1,困惑度则升到约 9.6976。
这个系数为 1e-3 的辅助损失,就是“不均衡的代价”中那个学习得到的路由器,到它 120 次迭代结束时,吞吐已升到 125 TFLOP/s。
系数设得太高会使模型学得更差,设得太低则使负载不均匀,所以请同时关注 LM loss 和均衡情况。均衡情况最好用 MaxVio 来读,而不是看辅助损失本身。该损失把每个专家的 token 占比乘以它的平均路由概率,所以当路由器的概率很平坦时,无论 token 占比如何,该损失读数都与均匀负载相同,一个完美均衡的读数可能掩盖了倾斜的负载。Sigma-MoE-Tiny 就遇到了这种情况:在它较低的层中,损失通过把概率压平而降到最小,而负载仍然不均匀77。--moe-per-layer-logging 按层记录该值,名为 load_balancing_loss,并已除以系数。
当最简单的均衡器就够用时就用它:系数约为 1e-3 的 aux_loss,就像 2.5 中我们的第一次 MoE 运行那样。如果负载仍不均匀就调大,如果 LM loss 受损就调小72。
到目前为止我们用的辅助损失统计的是每个专家在一个 micro-batch 内的负载,这留下了一个我们还没问过的问题:应该在哪些 token 上让负载均匀?你可以在每条序列上、每个 micro-batch 上,或者整个全局 batch 上做均衡,下一部分会比较这三者。
范围
想想一个 micro-batch 里装了什么。预训练流水线常常用单一领域(比如全是代码)来打包每个 micro-batch,所以一个要求该 micro-batch 内部负载均匀的损失,会把代码 token 分散到每个专家上,没有专家能够专门化于代码78。改为在整个全局 batch(混合了许多领域)上做均衡,只要其他领域的 token 能填满其余专家,代码 token 就可能挤向少数几个专家。Qiu 等人只在第二种设置下看到专家按领域专门化,而且它还降低了他们的困惑度79。GPU 为此付出了代价:在每个 micro-batch 内部,负载不再均匀,他们 43B 模型的单步慢了约 6%,其中约 1% 来自通信开销,其余主要来自不均匀的负载80,81。
单条序列是所有范围中最紧的。对每条序列单独均衡,会把每条序列分散到所有专家上,即使一个 micro-batch 混合了多个领域;DeepSeek-V2-Lite 就是以这种方式统计它唯一的均衡损失(一个专家级损失)的82,而 DeepSeek-V3 保留一个小的序列级损失,防止在整个 batch 看起来均衡的情况下,某一条序列堆到少数几个专家上42。在下图中,三种范围并排运行,每块 GPU 持有来自两个领域的两条序列:范围越紧,专家越不能集中在某一个领域上;范围越松,每块 GPU 承担的负载就越不均匀。

在该模拟中,序列级损失把代码序列分散到所有专家上,micro-batch 级损失让每块 GPU 的两个领域把它的专家在二者之间分掉,而全局 batch 级损失让代码 token 大多留在它们偏爱的两个专家上,代价是每块 GPU 的负载最不均匀。Megatron 通过 load-balancing type 选择范围:aux_loss 按 micro-batch 均衡,seq_aux_loss 按序列均衡,global_aux_loss 在全局 batch 上均衡。要组合多种范围,请传入多个类型,并按同样的顺序各传一个系数,例如 --moe-router-load-balancing-type aux_loss seq_aux_loss --moe-aux-loss-coeff 1e-3 1e-4。
Megatron 源码
router.py#L567-L589(逐序列计数,÷ bsz)
567scores_for_aux_loss = scores_for_aux_loss.reshape(seq_length, -1)568routing_map = routing_map.reshape(seq_length, -1)569570global_tokens_per_expert, local_num_tokens, total_num_tokens = (571get_tokens_per_expert_and_token_count(572routing_map=routing_map,573reduce_group=self.tp_cp_group,574with_padding_mask=with_padding_mask,575topk=self.topk * bsz,576)577)578579aux_loss = (580switch_load_balancing_loss_func(581probs=scores_for_aux_loss,582tokens_per_expert=global_tokens_per_expert,583total_num_tokens=total_num_tokens,584topk=self.topk,585num_experts=self.config.num_moe_experts,586moe_aux_loss_coeff=seq_aux_loss_coeff,587fused=self.config.moe_router_aux_loss_fusion,588)589/ bsz
router.py#L617-L628(全局计数,滑动平均)
617global_tokens_per_expert, local_num_tokens, total_num_tokens = (618get_tokens_per_expert_and_token_count(619routing_map=routing_map,620reduce_group=self.tp_dp_cp_group,621with_padding_mask=with_padding_mask,622topk=self.topk,623)624)625626self.global_tokens_per_expert += global_tokens_per_expert627self.ga_steps += 1628averated_tokens_per_expert = self.global_tokens_per_expert / self.ga_steps
router.py#L233-L248(全局计数缓冲区)
233# Initialize global tokens per expert for global aux loss234if self.get_aux_loss_coeff("global_aux_loss") > 0:235self.register_buffer(236'global_tokens_per_expert',237torch.zeros(238self.config.num_moe_experts,239dtype=torch.float32,240device=torch.cuda.current_device(),241),242persistent=False,243)244self.register_buffer(245'ga_steps',246torch.tensor(0, dtype=torch.float32, device=torch.cuda.current_device()),247persistent=False,248)
router.py#L1121-L1125(每个全局 batch 重置)
1121def reset_global_aux_loss_tracker(self):1122"""Reset the global aux loss tracker."""1123if self.global_tokens_per_expert is not None:1124self.global_tokens_per_expert.zero_()1125self.ga_steps.zero_()
每种范围都有各自的失败方式。按序列或按 micro-batch 均衡,可能使领域专家无法形成,因此模型学得更差;而在全局 batch 上均衡,会使每块 GPU 上的负载不均匀,因此训练步变慢。无论选哪种范围,都要在该范围上通过 MaxVio 来读均衡情况:按 micro-batch 用 --save-tokens-per-expert-interval 保存的负载计算,按全局 batch 用这些负载之和计算,按序列则根据路由 trace 离线计算(A.1)。
默认使用 micro-batch(aux_loss)。仅为获得领域专门化的专家时才使用 global_aux_loss,在 Qiu 等人的实验中单步耗时增加 5.8%81。
无论选哪种范围,均衡损失仍然通过梯度来牵引路由器,而这个梯度与来自 LM loss 的梯度相互竞争。能不能完全不碰梯度,就把负载均衡好?
无损失偏置
辅助损失通过把路由器的概率从 LM 想要的结果上拉开,来修正过载的专家。无损失偏置(loss-free bias)则不动这些概率,而是不用任何梯度就挪动负载。每个专家有一个偏置,在 top-k 之前加到它的分数上,仅用于挑选专家,权重仍然来自分数;每一步 Megatron 都把每个偏置移动一个固定量(更新速率):负载不足的专家上调,过载的专家下调。下图运行了这个循环。在 DeepSeek-V3 的消融中,它在 1B 和 3B 规模下的验证 loss 与 batch 级辅助损失持平83。与辅助损失一样,它会把一部分选择从 LM 自身的 top-k 改走别处,在“辅助损失”部分的四列玩具示例中,它改动得最多。

图中运行了 16 个玩具专家,步长远大于 Megatron 的默认值,因此几轮就相当于许多轮:过载的专家降低偏置,负载不足的专家提高偏置,直到负载接近均匀;大步长留下的来回震荡,在玩具模型把步长缩小十倍后被抑制。在真实训练中,问题出在固定步长上,它必须与专家数量相匹配。Li 等人扫描了小型 MoE 的专家数量,在 1e-3 的更新速率下,最忙专家的负载随专家数增长,在 1,024 个专家时达到平均值的约 50 倍,而单独使用 1e-2 的辅助损失则始终低于约 7 倍84。超过 128 个专家后,偏置还会损害 LM 质量,作者怀疑是步长对这么多专家来说太粗了85。
上图过载轨迹上的参考线来自同样的 1B 实验,是在每个训练 batch 上测得的,而不是在验证集上:MaxVio 在辅助损失为 1e-3 时稳定在约 0.72,使用偏置时稳定在约 0.186。
Megatron 的规则是你能写出的最简单的一条:每一步,每个偏置都上调或下调相同的固定量,无论其专家距离平均负载有多远。这就是符号更新(sign update),而它并不是运行这个循环的唯一方式。线性更新按各专家与平均负载的距离成比例地移动偏置,因此严重过载的专家得到大的修正,接近均衡的专家得到小的修正;AdamW 更新则为每个专家自适应地调整步长。LongCat-Flash 运行线性更新,目标是其计算预算所要求的专家负载65,而 ZAYA1-8B 把每个专家的负载误差喂给 AdamW87。
这些规则还在更微妙的地方有所不同:当某个更新的各步之和不为零时,所有偏置的均值会漂移。这种漂移不会改变任何选择,因为给每个专家的分数加上同一个数不会改变 top-k,但在偏置以 bf16 存储的地方它会损失精度;Megatron 以 fp32 保存它。Moonlight 和 Trinity Mini 通过减去各步的均值来避免漂移88,89。已发布的权重也有类似差别:DeepSeek-V3 的偏置逐层均值在 2.2 到 8.0 之间,而 Moonlight 和 ZAYA1-8B 的平均为 0,LongCat-Flash 的则略低于 090。下面,符号更新、中心化符号更新、线性更新和 AdamW 更新在同一个 batch 上运行。

图中玩具 batch 里有少数热门专家和许多刚好低于平均负载的专家,所以大多数符号步都指向上方:符号更新和 AdamW 更新会抬高偏置的均值,而中心化符号更新和线性更新使均值保持为零;然而符号更新在每一步的均衡效果都和中心化版本一样好,因为 top-k 忽略所有专家共同的平移。无论用什么规则来调整,偏置都只能均衡它所统计到的 token。batch 范围的偏置在一个 batch 上拟合,并应用到下一个 batch,所以它能让整个 batch 看起来均匀,却不能保证每条序列都均匀:单条序列仍然可能堆到少数几个专家上。显而易见的修复办法——再在每条完整序列上计算第二个偏置——会用到该序列中靠后的 token,从而把未来泄漏到前面 token 的路由里。
Chang 的因果偏置(causal bias)避免了这种泄漏,它只用该序列已经路由过的内容来构建第二个偏置。它在每条序列开头重置,每处理完一个 token,就降低刚被选中的专家的偏置、升高其他专家的偏置,这样每个专家的偏置追踪的是它到目前为止的选择比其份额(每个 token k/N)高出或低出多少,被这条序列用得过多的专家,会在随后的 token 上被向下压。与 batch 偏置一样,它只改变选择哪些专家,从不通过梯度训练91。下一幅图对同一条序列分别只用全局 batch 偏置、以及在其上叠加该序列过往所得的因果偏置来做路由。

图中的序列到一半时切换成代码。只有全局 batch 偏置时,它的代码 token 堆到了一个专家上,尽管整个 batch 保持均衡;加上因果偏置后,这些代码 token 分散到更多专家上,序列的负载保持得更接近均匀。另一方面,模拟显示因果偏置把更多的选择送到了路由器自身 top-k 之外的专家上,偏离了路由器本身的偏好,而且它的证据规模较小,来自 Chang 在 nanochat 和 TinyStories 上的实验91。
已发布的模型对单条序列的处理各不相同。DeepSeek-V3 把它的偏置与我们之前看到的序列级辅助损失搭配使用,系数极小,为 1e-462:偏置使 batch 保持均匀,而这个小损失则防范单条序列内的极端不均衡。下图在一条普通序列和一条极端序列上,比较了没有这种损失、小的损失和大的损失。

在这个玩具示例中(两个系数只是示意,并非 DeepSeek-V3 的取值),小系数能让普通序列更接近均匀,同时只轻微移动路由器,但对极端序列仍然使其堆在一个专家上;要把它分散开,需要大系数,而这会把路由器从 LM loss 偏好的路由上拉得远得多。序列是 batch 范围的计数可能掩盖不均衡的一种情形,模态则是另一种。
当一个 batch 混合了多种模态时,对所有 token 统计的偏置可以平衡它们的总和,而单独来看,某一种模态的 token 仍然可能挤到少数几个专家上。DeepSeek-VL2 和 Kimi-VL 为所有 token 保留一个偏置92,93,DeepSeek-V4.1-Flash 则为每种模态保留一个63。下图比较了一个共享偏置与每种模态一个偏置的情形,后者只统计各自模态的 token。

该玩具示例设定文本偏向八个专家中的四个,图像偏向另外四个,所以共享偏置平衡了总量,而每种模态的盈余互相抵消;每种模态一个偏置,则使每种模态各自均衡。拆分的代价是,偏置随后推动每个专家分担各模态中属于它的份额,使其不再专门处理图像。
要在 Megatron 中运行它,请用 --moe-router-enable-expert-bias 打开偏置,用 --moe-router-bias-update-rate 设置其固定步长,并使用 sigmoid 分数(--moe-router-score-function sigmoid),因为 Megatron 只在 sigmoid 或 sqrt(softplus) 分数下接受偏置(transformer_config.py#L3139-L3147)。
Megatron 源码
moe_utils.py#L936-L939(偏置仅用于选择)
936elif expert_bias is not None:937scores_for_routing = scores + expert_bias.float()938_, top_indices = compute_topk(scores_for_routing, topk, num_groups, group_topk)939scores = torch.gather(scores, dim=1, index=top_indices)
router.py#L209-L228(int64 计数,fp32 偏置)
209if self.enable_expert_bias:210self.register_buffer(211'local_tokens_per_expert',212torch.zeros(213self.config.num_moe_experts,214# Keep token counts exact through accumulation and cross-rank reduction.215# Float16Module leaves integer buffers in their original dtype.216dtype=torch.int64,217device=torch.cuda.current_device(),218),219persistent=False,220)221self.register_buffer(222'expert_bias',223torch.zeros(224self.config.num_moe_experts,225dtype=torch.float32,226device=torch.cuda.current_device(),227),228)
moe_utils.py#L1253-L1263(符号更新,精确比较)
1253# All Reduce Across TPxCPxDP group1254torch.distributed.all_reduce(tokens_per_expert, group=tp_dp_cp_group)1255num_experts = tokens_per_expert.shape[-1]1256total_tokens = tokens_per_expert.sum(dim=-1, keepdim=True)1257# Compare each tokens_per_expert value with the row average without converting the integer1258# counts to floating point: tokens_per_expert < total / num_experts iff1259# tokens_per_expert * num_experts < total.1260update_direction = torch.sign(total_tokens - tokens_per_expert * num_experts)1261updated_expert_bias = (1262expert_bias + update_direction.to(dtype=expert_bias.dtype) * expert_bias_update_rate1263)
finalize_model_grads.py#L726-L731(每步更新一次)
726if config.moe_router_enable_expert_bias:727if pg_collection is None:728tp_dp_cp_group = parallel_state.get_tensor_and_data_parallel_group(729with_context_parallel=True730)731_update_router_expert_bias(model, config, tp_dp_cp_group=tp_dp_cp_group)
当更新速率对你的专家数量来说太粗时,负载会保持不均匀,正如“不均衡的代价”所示,这会拖慢训练步,而且超过 128 个专家时,Li 等人的扫描还观察到 LM 质量受损。你可以在两处发现它。每个检查点都保存 expert_bias,所以你可以跟踪每一层的偏置在相邻检查点之间扩散了多远;而 --save-tokens-per-expert-interval 写出的 token 计数则给出每个全局 batch 的 MaxVio(A.1)。
当均衡器必须几乎不与 LM loss 相抗衡时使用它:偏置完全不增加梯度,DeepSeek-V3 在 α = 1e-4 的序列级损失62所增加的也很少。请搭配 sigmoid 分数运行,并根据你的专家数量调节更新速率,因为超过 128 个专家时 1e-3 可能太粗85。
无论负载看起来如何,偏置都按同样的小步长移动,所以要追上一个不断变化的路由器可能需要很多步。与其一步步朝正确的偏置靠近,能不能直接从当前 batch 的分数里把它算出来?
分位数
分位数均衡(Quantile balancing)保留偏置,但直接求解它。对每个专家,它按该专家的分数对 micro-batch 中的 token 排序,并读出一个分位数:只有该专家目标份额的 token 能超过的那个分数。偏置由这个分位数设定,而不是按固定步长移动。Jin 等人在一个 19B 参数、768 个专家的 MoE 上比较了各均衡器,在 LM loss 大致相同的情况下,分位数均衡比符号更新更早达到均衡,平均 MaxVio 减半,不过在最后 1k 步,其 MaxVio 最终略高94。这种精确是有代价的:在每个 micro-batch 中,每个专家都得按自己的分数对该 micro-batch 的全部 token 排序,才能找到它的分位数,也就是在通常的逐 token top-k 之外再做一次逐专家的 top-k。下面并排运行符号更新和分位数均衡,使用同一个 batch。

该玩具示例每一步都路由同一个 batch,所以每个求解出的偏置恰好路由求解它所依据的那些 token:最后一步之后,符号更新仍然使负载不均匀,而分位数均衡在几步之内就把负载拉到接近均匀。在 Megatron 中,每个 micro-batch 求解各自的分位数,解在全局 batch 上取平均后用于路由下一个 batch,还可以选择用指数滑动平均(EMA,--moe-router-quantile-balancing-ema)进行平滑。EMA 保留上一次偏置的大部分,只混入每次新解的一部分,因此偏置在步与步之间变化缓慢。
Megatron 源码
moe_utils.py#L233-L247(top-k 与逐专家分位数)
233topk_result = (scores - beta).topk(k + 1, dim=1)234indices = topk_result.indices[:, :-1]235236if not update_beta:237return indices, beta238239assert (num_tokens * k) % num_experts == 0, (240"Quantile balancing requires the number of routed assignments "241f"({num_tokens} tokens * top-{k}) to be divisible by "242f"{num_experts} experts."243)244col_target = num_tokens * k // num_experts245alpha = topk_result.values[:, -1:]246beta_local = (scores - alpha).topk(col_target + 1, dim=0).values[-1].contiguous()247return indices, beta_local
finalize_model_grads.py#L441-L457(平均、EMA、重新居中)
441stacked_beta = torch.stack(qb_beta_list, dim=0)442local_avg_list = [443accum / count.clamp(min=1).to(accum.dtype)444for accum, count in zip(qb_beta_accum_list, qb_beta_count_list)445]446stacked_local_avg = torch.stack(local_avg_list, dim=0)447448torch.distributed.all_reduce(449stacked_local_avg, op=torch.distributed.ReduceOp.AVG, group=dp_cp_group450)451452ema = config.moe_router_quantile_balancing_ema453stacked_new_beta = ema * stacked_beta + (1.0 - ema) * stacked_local_avg454stacked_new_beta = stacked_new_beta - stacked_new_beta.mean(dim=-1, keepdim=True)455456for qb_beta, new_beta in zip(qb_beta_list, stacked_new_beta):457qb_beta.copy_(new_beta)
router.py#L256-L259(辅助损失必须为 0)
256if self.routing_type == "quantile_balancing":257assert not self.is_aux_loss_enabled(), (258"Quantile balancing handles load balance via the bias update; "259"aux losses must be disabled (set moe_aux_loss_coeff to 0)."
router.py#L398-L403(无融合,无分组限制)
398assert (399not self.config.moe_router_fusion400), "Quantile balancing routing does not support moe_router_fusion."401assert (402self.config.moe_router_num_groups is None and self.config.moe_router_group_topk is None403), "Quantile balancing routing does not support group-limited routing."
Kimi K3 在其整个全局 batch 上运行分位数均衡,从跨 GPU 求和的直方图中读取每个专家的分位数64。它之所以放弃固定步长规则,是因为当其路由池达到每层 896 个专家时,均衡变得更难64;提出分位数均衡的苏剑林95写道,Kimi K2 当时使用的是符号更新96。
平均是有代价的:由整个全局 batch 共享的偏置可以使该 batch 均衡,而每块 GPU 的 micro-batch 仍然不均匀。Neitemeier 等人在一次 7.5B 的运行(一个随机种子)中测量了这个差距有多大。Megatron 使用的按 rank 平均的分位数把全局 batch 均衡到 MaxVio 为 0.92,而在最差的一层,专家并行 micro-batch 中最忙的专家仍然拿到了约 7 倍于其公平份额的量,局部 MaxVio 为 5.96。求解精确的全局 batch 分位数则使两者都降低了97。他们把局部 MaxVio 当作 dispatch 开销的代理指标,而不是实测的吞吐98。
各均衡器在吞吐上表现如何?我们在同一个模型上从初始化开始运行了五种路由器配置,每种一个随机种子,并比较它们在 120 次迭代中最后 20 次的中位吞吐。分位数均衡达到了 139 TFLOP/s,辅助损失为 125,而测试的仅偏置配置为 99。仅偏置的运行使用 sigmoid 分数和 1e-3 的更新速率,另外四个使用 softmax。这些运行使用较旧的 Megatron 提交,它以 bf16 累加偏置的 token 计数,因此计数可能被舍入并翻转偏置更新的方向;在 d6316eb45 处,计数是精确的。使用 0.9 的 EMA 时,分位数均衡达到 121 TFLOP/s。该设置在偏置更新中给每个新解 10% 的权重(transformer_config.py#L910-L913)。
Jin 等人给分位数均衡加了 EMA:更强的平滑使偏置在检查点之间更稳定,但在训练早期更慢地修正负载99。五次运行都绘制在下面。

图中五次运行里,仅偏置的那条保持平坦,其余四条都在上升,分位数均衡在最后 20 次迭代中最快。吞吐在结束时仍在上升,所以这个排名描述的只是这最初的 120 次迭代。分位数均衡最终的训练 LM loss 也是五者中最高的,所以仅凭它的吞吐领先,并不能证明它在达到相同质量的前提下训练更快。
要尝试分位数均衡,请设置 --moe-router-load-balancing-type quantile_balancing。同一个参数也接受 sinkhorn:Sinkhorn 使用一种平衡分配的过程,在训练期间为每个 token 选择专家。
风险在于:全局 batch 看起来均衡,而每块 GPU 的 micro-batch 却不均衡,Neitemeier 等人把这解读为更高的 dispatch 开销。要看到这个差距,请根据 --save-tokens-per-expert-interval 写出的 token 计数计算两次 MaxVio,一次按 micro-batch,一次按全局 batch,然后比较二者(A.1)。
当符号更新偏置均衡得太慢时使用它:在 768 个专家的设置下,直接求解偏置比一步步靠近它达到了更低的平均 MaxVio,LM loss 大致相同94,并且在我们五种配置的对比中(一个随机种子),它在 120 次迭代中最后 20 次的中位吞吐最高。请围绕它的限制来规划,因为 Megatron 目前拒绝将它与任何辅助损失、--moe-router-fusion 或分组限制路由一起使用。
该看什么
| 部分 | 症状 | 需要关注的信号 |
|---|---|---|
| 不均衡的代价 | slow:持有最忙专家的 GPU 决定了单步耗时。 | 相对于强制均匀对照运行的 TFLOP/s。 |
| 辅助损失 | learns badly:系数设得太高会使模型学得更差,设得太低则使负载不均匀。 | LM loss 与 MaxVio 一起看:路由器概率平坦时,辅助损失可能看起来很均衡,而负载仍然不均匀77。 |
| 范围 | learns badly:按序列或按 micro-batch 均衡会使领域专家无法形成。slow:按全局 batch 均衡会使每块 GPU 上的负载不均匀;单步多花了 5.8% 的时间,主要来自这种不均衡,其中约 1% 来自通信81。 | 在你所均衡的范围上的 MaxVio:按 micro-batch 或全局 batch 用 token 计数,按序列则用路由 trace(A.1)。 |
| 无损失偏置 | slow:在固定步长 1e-3 下,128 个专家时最忙的专家仍然得到约 20 倍于平均的负载84。learns badly:超过 128 个专家后,该步长太粗85。 | expert_bias 在每一层、跨检查点扩散了多远,以及根据 token 计数得出的每个全局 batch 的 MaxVio(A.1)。 |
| 分位数 | slow:用滑动平均平滑偏置会使它滞后于路由器的分数。偏置由全局 batch 共享,所以每块 GPU 的负载可能仍然不均匀,如“范围”一节所述。 | 每个 micro-batch 的 MaxVio,与每个全局 batch 的 MaxVio 并列,来自保存的 token 计数(A.1),用以发现被全局均衡所掩盖的局部不均衡97。 |
本节中的每个均衡器,都是把 token 分散到一个在训练开始前就固定下来的专家集合上,而我们还没有问过这个集合应该是什么样子。一个层应该有多少个专家,每个专家应该多宽,是否应该有一些专家看到每一个 token?
3.4 专家:多少个、多大、共享与否
一旦路由器选定了一个 token 的专家,这些专家是什么样子,就同时决定了该层能学到什么以及运行它要花多少。你需要选择一个层有多少个专家、每个多宽,如何控制许多小专家带来的网络流量,是否应该有一个专家看到每一个 token,以及每个专家内部运行哪种激活函数。
| 模型 | 数量与大小 | Latent MoE | 共享专家 | 可变计算量 | 激活函数 |
|---|---|---|---|---|---|
| DeepSeek-V4.1-Flash100 | 384 选 6,宽度 2,304 | 全宽专家 | 1 个,宽度 2,304 | 固定 top-k,宽度相等 | SwiGLU,上限 10 |
| GLM-5.3101 | 256 选 8,宽度 2,048 | 全宽专家 | 1 个,宽度 2,048 | 固定 top-k,宽度相等 | SiLU 门;未指定上限 |
| Kimi K3102 | 896 选 16,宽度 3,072 | 7,168 降到 3,584;上投影前先做 norm | 2 个,每个宽度 3,072 | 固定 top-k,宽度相等 | SiTU-GLU,上限 4 和 25 |
| LongCat-Flash103 | 768 选 12,宽度 2,048 | 全宽专家 | 无 | 768 个中有 256 个是恒等专家:每个 token 的激活参数为 18.6B 到 31.3B,平均 27B | SiLU 门;未指定上限 |
| MiMo-V2.6-Pro-RL104 | 384 选 8,宽度 2,048 | 全宽专家 | 无 | 固定 top-k,宽度相等 | SiLU 门;未指定上限 |
| Nemotron 3 Ultra105 | 512 选 22,宽度 5,120 | 8,192 to 2,048 | 1 个,宽度 10,240 | 固定 top-k,宽度相等 | ReLU² |
| Qwen3.8 2.4T-A95B106 | 512 选 10,宽度 2,048 | 全宽专家 | 1 个,宽度 2,048 | 固定 top-k,宽度相等 | SiLU 门;未指定上限 |
| Step 5 Preview107 | 352 选 8,宽度 1,536 | 全宽专家 | 1 个,宽度 1,536 | 固定 top-k,宽度相等 | SwiGLU,上限 7 |
参数预算固定时,增加专家数量就意味着让每个专家变窄。在相同计算量下,哪种划分能得到更好的模型?
数量与大小
设想一个参数量和计算量都固定的 MoE 层,把它的专家切得更细:专家数量翻倍、宽度减半、top-k 翻倍,两种预算保持不变。图 3.4.1 画出了这个阶梯:粗粒度;然后是 16 个宽度为 d/2 的专家、top-4;再是 32 个宽度为 d/4 的专家、top-8。Liew 等人在一个 18 层模型中做了这项消融,总参数和激活参数都固定,loss 随着每次切得更细而下降,一直到 128 个宽度为 d/4 的专家、top-8,从 2.334 降到 2.297,而再更细的切分没有带来进一步提升108。因此在该实验中,切分到超过 128 个专家后就不再划算,而每进一步更细的切分,仍然要运行更小的 GEMM,并分发每个 token 的更多副本。

已发布的模型位于这个阶梯的不同台阶上。gpt-oss-120b 和 Trinity Large 让每个专家与模型一样宽,分别是 128 选 4 和 256 选 4,Mistral Small 4 把这个宽度减半,为 128 选 4,Qwen3.5-35B-A3B 把它缩为四分之一,为 256 选 8109。
从图中可以看到,拆分专家会改变它们的数量和宽度,同时保持每个 token 的总参数量和计算量不变。整体方块面积代表参数,深色面积代表一个 token 的专家计算。你改变的是粒度。粒度描述的是你把专家容量划分得多细:粒度越细,意味着专家越多、越窄。为保持每个 token 的计算量不变,每个 token 要使用更多个较窄的专家。你也可以提高稀疏度:增加更多参数,同时保持每个 token 使用的数量不变。接下来比较花掉这些额外参数的两种方式:更多路由专家,或者按 token id 查找的 n-gram embedding 表。

该图绘制了 LongCat 在 2.8 亿激活参数下的对比。其中,一旦专家已持有约 12 倍于激活参数的参数量,n-gram 表降低 loss 的幅度就超过把同样参数花在更多专家上的做法(在 17 倍激活参数处约低 0.01),而当专家停留在约 4 倍时加入的表,则从一开始就更差。这种增益有限度:在英文验证 loss 上,一旦表占到参数的略多于 40%,更多的专家就再次获胜,LongCat 据这个交叉点得出的规则是,表中的参数不要超过 50%110。在该对比中,先是扩大专家带来回报,等专家足够大之后,接下来的一部分参数放在查找表里作用更大。因此,把额外参数花在哪里,取决于你已经有多少专家容量。
这两种花法都已用于已发布的模型:Kimi K2 把它的池扩大到 384 个专家、top-8,LongCat-Flash-Lite 则把其 685 亿参数中的 314 亿放在 n-gram embedding 表里111。
无论你是增加更多专家,还是把现有容量划分成更窄的专家,由此得到的形状也会影响训练速度。更窄的专家运行更小的 GEMM,对 GPU 的利用效率更低。
对于稠密模型,compute-optimal 缩放律帮助你在模型大小和训练 token 数之间划分固定的 FLOP 预算:更大的模型留给更少的 token,更小的模型则可以训练更多 token112。MoE 增加了另一项选择。你可以在不增加每个 token 所用参数的前提下增加总参数,因此你还需要选择它的稀疏度。对任何一种模型,在时间限制下做选择,还意味着要考虑每种配置对硬件的利用效率113。
Sarkar 等人把拟合的 loss 缩放律与训练吞吐模型结合起来,比较了固定模型 FLOPs 下使 loss 最小的稀疏度,与固定集群时间下使 loss 最小的稀疏度。他们对一个集群和训练窗口的预测绘制在下方113。这里的稀疏度是指模型参数中 token 不使用的部分所占的比例。

在他们的预测中,仅按模型 FLOPs 选择,会把你引向网格中最稀疏的模型。一旦作者考虑了他们集群上的训练速度,预测 loss 最低的点就移到了稀疏度较低的配置上,比最稀疏的配置低 0.031 nats。就像稠密模型的缩放一样,你是在模型容量与可以训练的 token 数之间取得平衡。对于 MoE,提高稀疏度可能降低硬件利用率,而不增加每个 token 的模型 FLOPs,所以额外的容量仍然可能耗费训练时间113。
Megatron 用三个参数设定形状:--num-experts 设定数量,--moe-ffn-hidden-size 设定每个专家的宽度,--moe-router-topk 设定每个 token 选择多少个专家。
Megatron 源码
experts.py#L262-L293(grouped fc1、fc2 的形状)
262# Double the output width with gated linear unit, see https://arxiv.org/pdf/2002.05202.pdf263ffn_hidden_size = not_none(self.config.moe_ffn_hidden_size)264if self.config.gated_linear_unit:265ffn_hidden_size *= 2266267self.linear_fc1 = submodules.linear_fc1(268self.num_local_experts,269self.input_size if self.config.moe_latent_size is None else self.config.moe_latent_size,270ffn_hidden_size,271config=self.config,272init_method=not_none(self.config.init_method),273bias=self.config.add_bias_linear,274skip_bias_add=False,275is_expert=True,276tp_comm_buffer_name='fc1',277pg_collection=pg_collection,278name=(name + ".linear_fc1") if name is not None else None,279)280281if self.config.use_te_activation_func and not (submodules.activation_func is None):282self.activation_func = apply_module(submodules.activation_func(config=self.config))283else:284self.activation_func = self.config.activation_func285286self.linear_fc2 = submodules.linear_fc2(287self.num_local_experts,288not_none(self.config.moe_ffn_hidden_size),289(290self.config.hidden_size291if self.config.moe_latent_size is None292else self.config.moe_latent_size293),
router.py#L77-L81(路由器权重 N x d)
77# Initialize the gate weights.78# TODO: Add support for GPU initialization, which requires updating the golden values.79self.weight = torch.nn.Parameter(80torch.empty((self.config.num_moe_experts, self.config.hidden_size), dtype=torch.float32)81)
把专家切得太细,每个专家的 GEMM 会小到使每块 GPU 的 TFLOP/s 下降,粒度不当还会使模型学得更差。要看一种形状让你付出什么代价,请把 profiler 中每个 MoE 层的 grouped-GEMM 时间,与 --log-throughput 给出的每块 GPU 的 TFLOP/s 对照着读。--save-tokens-per-expert-interval 写出的 token 计数也能显示收不到任何 token 的死专家(A.1),但专家也可能在保留其 token 的同时“死掉”,这会体现在它的输出范数上(3.6)114。
在总参数和激活参数相等的前提下,使用更细的专家,但要适可而止:在一个 18 层模型中,loss 一直下降到 128 个宽度为 d/4 的专家、top-8,更细的拆分没有任何收益108。当小 GEMM 和 token 副本开始主导你的训练步时,就不要再更细了。
更细的专家只在一定限度内有助于 loss,而且每进一步更细,都会让每个 token 有更多副本经网络发送。能不能保留许多小专家,同时让每个副本发送的数据更少?
Latent MoE
一个 token 的每个副本都携带它完整的隐藏状态,即 d 个数,每选一个专家就发送一次。LatentMoE 缩小了这个副本。它在 dispatch 之前把每个 token 投影到更小的潜在维度 ℓ,在 ℓ 上运行专家,并在 combine 之后投影回去。每个副本从 d 缩小到 ℓ,节省下来的开销用来支撑更多的专家:在专家参数、专家计算和流量相同的情况下,该层可以负担 α = d/ℓ 倍的专家数量和 α 倍大的 top-k115。下面,标准层与它的潜在版本并排摆放,专家内部的参数量和计算量保持不变。

画成方块后,标准层从十六个专家中选四个,每个接收全宽的 token 向量。潜在层从三十二个中选八个,但每个只接收一半数量的值。两者每个 token 发送的数据量相同。它们的整体方块面积和深色面积也相等,表明专家参数和计算量没有变化;两次投影在这些面积之外增加了工作量115。
这种取舍在质量上划算吗?在 NVIDIA 的 73B-A8B 消融中,总参数与激活参数相同的情况下,LatentMoE 在 MMLU-Pro 上比标准 MoE 高 4.6 分116,一次小规模复现也降低了困惑度117。Nemotron 3 Super、Nemotron 3 Ultra 和 Kimi K3 都采用了它118。作为回报,每个 token 都要经过两次 d x ℓ 投影,推理服务吞吐在并发为 1 时最多低 12%,在某些并发下则略有提高119。在 Megatron 中,潜在维度大小由 --moe-latent-size 设置。
Megatron 源码
moe_layer.py#L304-L335(两次投影,可选 norm)
304self.fc1_latent_proj = linear_cls(305self.config.hidden_size,306self.config.moe_latent_size,307parallel_mode="duplicated",308config=self.config,309init_method=self.config.init_method,310bias=self.config.add_bias_linear,311skip_bias_add=False,312skip_weight_param_allocation=False,313is_expert=False,314name=(name + ".fc1_latent_proj") if name is not None else None,315**linear_gtp_kwargs,316)317if self.config.moe_use_norm_before_up_proj:318self.fc2_norm = TENorm(319config=self.config,320hidden_size=self.config.moe_latent_size,321eps=self.config.layernorm_epsilon,322)323self.fc2_latent_proj = linear_cls(324self.config.moe_latent_size,325self.config.hidden_size,326parallel_mode="duplicated",327config=self.config,328init_method=self.config.output_layer_init_method,329bias=self.config.add_bias_linear,330skip_bias_add=False,331skip_weight_param_allocation=False,332is_expert=False,333name=(name + ".fc2_latent_proj") if name is not None else None,334**linear_gtp_kwargs,335)
moe_layer.py#L554-L556(dispatch 之前向下投影)
554# Project the hidden_states from hidden dimension down to latent dimension.555if self.config.moe_latent_size:556hidden_states, _ = self.fc1_latent_proj(hidden_states)
moe_layer.py#L662-L666(combine 之后做 norm、向上投影)
662output = self.token_dispatcher.combine_postprocess(output)663if self.config.moe_latent_size:664if self.config.moe_use_norm_before_up_proj:665output = apply_module(self.fc2_norm)(output)666output, _ = self.fc2_latent_proj(output)
experts.py#L269-L269(专家读取 ℓ)
269self.input_size if self.config.moe_latent_size is None else self.config.moe_latent_size,潜在 MoE 可能在两方面出问题:运行变慢,或者激活爆炸。运行变慢时,除了流量之外(all-to-all 现在每个副本携带的是 ℓ 个数而不是 d 个),还要看那两次额外的投影和更小的专家 GEMM。LatentMoE 的 NVIDIA 作者建议用小 GEMM kernel 以及为共享专家单独开一个 stream 来解决120。当它爆炸时(正如 Kimi K3 在其 2.8 万亿参数规模下报告的路由分支激活爆炸那样102),可以看的一个地方是上投影的输出范数 fc2_latent_proj,你可以根据 --save-activations-interval 的转储,逐层离线计算它(A.1)。K3 的修复办法是在上投影之前加一个 RMSNorm,即 --moe-use-norm-before-up-proj,它与 1.0 的路由缩放因子一起发布121。
当你想要更多专家和更大的 top-k,又不想让每个 token 发送更多数据时,请使用 latent:把每个副本缩小到 ℓ = d/α,可以负担 α 倍多的两者115,并且在相同规模下得分更高116,代价是两次投影。
到目前为止,每个专家都位于路由器之后,只看到被送到它那里的 token。如果把一个专家放在路由器之外,让它看到每一个 token,你会得到什么?它的计算开销值得吗?
共享专家
共享专家(shared expert)位于路由器之外:它处理每一个 token,与该 token 选中的那些路由专家并行。DeepSeekMoE 引入共享专家来学习通用模式,减少路由专家之间重复的知识,并为它们留出专门化的空间122。在其等计算量的消融中,加入共享专家使大多数基准上的结果得到提升123。Qwen 的模型显示了这个问题有多开放:Qwen3 报告中的 Qwen3 MoE 模型去掉了它124,Qwen3-Next 又在 sigmoid 门之后把它请了回来125,Qwen3.5 则保留了它126。
就从零训练、计算量相等的模型的 loss 而言,收益很小且并不一致。共享专家在 Pangu Ultra MoE 和 Sun 等人的 expert-threshold 模型中使 loss 降低了约 0.01 到 0.02127,128,而在 OLMoE 以及 Li 等人对小型 MoE 的扫描中,它没有作用或略有变差129,130。
共享还会减少路由器的自由度。32 个专家、激活 4 个时,为共享专家预留一个名额,就只剩下 4,495 种方式来选其余 3 个,而从全部 32 个中选 4 个有 35,960 种方式。如果你改为在不减少路由 top-k 的情况下加入共享专家,它常开的 FFN 会增加每个 token 的计算量:Mellum2 在不减少路由 top-k 的情况下加入了共享专家,发现没有质量提升,反而推理更慢131。
如果你确实加入了共享专家,还得决定它的输出如何与路由专家的输出混合。下图在每个 token 计算量相等的条件下排列了五种设计:仅路由;固定权重的共享专家(DeepSeek-V3)30;带门控的(Qwen3-Next)125;与路由专家联合归一化的(Inkling)19;以及并行的稠密 FFN(Grok 2)132。

这样排列后可以看出,固定权重的共享专家在每个 token 的权重中占相同的份额;Qwen 的门控使该份额在 0 到 50% 之间变动;Inkling 的路由器通过把共享专家与路由专家一起打分,为每个 token 学习该份额;而不做重新归一化的并行稠密 FFN,无论路由器如何打分,都占据一半以上。
Megatron 的参数是 --moe-shared-expert-intermediate-size、--moe-shared-expert-gate(对其输出的 sigmoid 门)和 --use-grouped-gemm-for-shared-expert。没有门控时,Megatron 以权重 1 加上共享输出(moe_layer.py#L668-L669),而在对所选专家做归一化后,路由权重之和等于路由缩放因子(moe_utils.py#L942-L947、3.1)。Megatron 通过 sigmoid 路由,或者在选出 top-k 专家之后再应用 softmax 来做到这一点。对于后者,请保持 --moe-router-pre-softmax 处于禁用状态。因此共享专家占每个 token 输出权重的 1/(1 + factor),在因子为 2.5 时为 29%,因子越大,它的份额越小;GLM-4.5-Air 和 Mistral Large 3 把因子设为 1,使它占一半133,134。
Megatron 源码
shared_experts.py#L128-L128(宽度来自共享专家大小)
128config.ffn_hidden_size = config.moe_shared_expert_intermediate_sizeshared_experts.py#L201-L208(对输出的 sigmoid 门)
201def forward(self, hidden_states: torch.Tensor) -> torch.Tensor:202"""Forward function"""203output, _ = super().forward(hidden_states)204if self.use_shared_expert_gate:205logits = torch.nn.functional.linear(hidden_states, self.gate_weight)206gate_score = torch.nn.functional.sigmoid(logits)207output = output * gate_score208return output
moe_layer.py#L668-L669(以权重 1 加入)
668if shared_expert_output is not None:669output = output + shared_expert_output
要在训练期间跟踪共享专家对每个 token 输出的贡献,请使用 A.1 中的稀疏前向 hook,比较经过门控后的共享分支与经过 combine 以及任何潜在上投影之后的路由分支。
共享专家是主流 MoE 常见的起手选择,包括 GLM-5.3、Kimi K3 和 DeepSeek V4.1 Flash135,136,137。MiMo-V2.6 则不带共享专家138。要在等计算量下比较有无共享专家,请让它采用路由专家的宽度,并用它替换一个路由名额。
无论是否共享,到目前为止每个专家宽度都相同,每个 token 的 top-k 也相同,所以每个 token 的计算量都相同。路由器能不能在平均值保持不变的前提下,给一些 token 更少的计算,给另一些更多?
可变计算量
有两种设计让每个 token 的计算量可以变化,而均值保持不变。LongCat-Flash 加入了零计算专家,把输入原样传递出去。它的路由器从 512 个 FFN 专家和 256 条这样的恒等路径组成的池中,为每个 token 选择 12 个专家。一个偏置调节 FFN 专家被选中的频率,目标是平均每个 token 8 个,同时允许个别 token 使用更多或更少139;预训练期间该数量的标准差上升到约 2.5140。小米 AI 实验室在 MoDSE(Mixture of Diverse Size Experts)中采用了不同的做法:他们混合专家的宽度,让路由器为每个 token 选择更大或更小的专家141。下图模拟了同质专家(如 Mixtral142)以及这两种设计下每个 token 的激活宽度。

在模拟中,每种设计用一个偏置把平均激活宽度保持在同质专家的水平,一些 token 得到更多,另一些得到更少,而且每个 token 仍然填满它所有的 top-k 名额,因为变化的只是落进名额里的内容。在 LongCat-Flash 的消融中,零计算专家在相同计算量下达到了更低的 loss143。混合大小的专家可以提升质量,但可能损失吞吐。小米 AI 实验室和 Wang 等人各自在小模型中把一个路由器放在混合大小的专家之上,并报告了收益141,144。Li 等人没有发现收益,但在他们的设置中,专家分处两个池,每个池有固定的 top-k,所以每个 token 的计算量仍然相同145。在 GroveMoE 中,代价体现在推理上:其混合大小的专家比 Qwen3-30B-A3B 慢约 30%,作者将其归因于每层用不同的 MoE kernel 分别处理两种大小的专家146。
Megatron 源码
无:在 Megatron-LM main(megatron/ 目录树)中 grep,既找不到零计算专家,也找不到混合专家宽度;每个 grouped linear 只有一个 moe_ffn_hidden_size
逐层跟踪每个 token 计算量的均值和离散程度:零计算路由看被选中的 FFN 专家数,混合大小路由看被选中专家的宽度之和。把均值与目标预算比较,并把每个专家的 token 计数,与每个专家并行 rank 的计算量以及单步耗时一起记录。
从单一宽度的路由专家和固定 top-k 起步,MiMo-V2.6-Pro-RL、GLM-5.3 和 Kimi K3 都是这么做的138,135,136。这也适合 Megatron 的 grouped linear 层,它们使用单一的 moe_ffn_hidden_size。
专家的数量、宽度和计算量都确定之后,每个专家内部还剩一项选择:它两个投影之间的那个函数。这个选择对 MoE 有多重要?
激活函数
与稠密 Transformer 一样,每个专家在其输入和输出投影之间使用一个激活函数,如 SwiGLU(DeepSeek-V3、Qwen3 和 Kimi K2 都用它)147,或 ReLU²。在 MoE 中,你还需要关注激活在各专家之间的行为:Step 3.5 Flash 发现,一两个专家的输出范数可能迅速增长,而其他专家保持稳定,训练 loss 几乎没有变化15。激活函数以及施加在它上面的任何 clamp,有助于控制这种增长。下图展示了随着输入尺度上升,SwiGLU、ReLU² 和 Expert-Specific PolyNorm 的输出如何增长。

放大后,SwiGLU 和 ReLU² 的输出随输入尺度的平方增长,而 Expert-Specific PolyNorm 对其门做了归一化,所以它的输出只线性增长。clamp 可以限制这种增长。两项研究发现,在其测试的设置中,有无裁剪的质量相近。在蚂蚁集团 Ling 团队的一次 7.9B MoE 消融中,带裁剪的 SwiGLU 在 17 个基准上的平均值与普通 SwiGLU 持平148。Step 3.5 Flash 的激活裁剪把它的离群专家的范数压了下去,而 loss 没有可见差别,尽管该分支是从未裁剪的运行中途开始的15。裁剪并没有消除 Ling 团队 FP8 运行中的 loss 尖峰:被裁剪的 SwiGLU 推迟了 loss 尖峰,但在大约第 77,000 步仍然出现了一次149。下一幅图把输入尺度扫过普通 SwiGLU、硬 clamp,以及在同一上界处的 SiTU-GLU 平滑上限,这样你可以看到它们各自如何弯折。

在这次扫描中,普通 SwiGLU 的最大隐藏单元随门输入的平方持续增长,直到 6,862(这是 K-EXAONE 2.0 在最后一层、推理时禁用其 clamp 的情况下测得的峰值150);硬 clamp 跟着它上升到上界后就停住;而 SiTU-GLU 在到达上界很早之前就弯了下来。扫描把二者设置为使隐藏单元停在约 100,clamp 为 10,SiTU-GLU 的 gate 上限为 4、up 上限为 25,从大致相同的输入开始,二者都几乎不再向这些单元的 gate 权重传递梯度。完全替换激活函数的证据则薄弱一些。Zhuo 等人的 PolyNorm 在 OLMoE-1B-7B 中使平均验证 loss 比 SwiGLU 低了 0.02151,而 Motif 3 只在有效秩(effective rank)上比较了它的 Expert-Specific PolyNorm 与 SwiGLU152。Kimi K3 表示,SiTU-GLU 的平滑上限比硬 clamp 带来更好的训练行为153。
在 Megatron 中,--activation-func-clamp-value 设置 MoE 层中 SwiGLU 的硬裁剪限值;取值 10 与 DeepSeek V4.1 Flash 的限值一致154,GigaChat 3.5 和 Hy4-preview 也使用这个值155。Kimi K3 的平滑上限 SiTU-GLU 对应 --activation-func-tanh-clamp-scale 4 --activation-func-tanh-clamp-scale-linear 25,从 Megatron Core v0.20 起可用,Nemotron 3 的 ReLU² 对应 --squared-relu118。
Megatron 源码
experts.py#L1100-L1118(SiTU-GLU 或带 clamp 的 SwiGLU)
1100if tanh_clamp_scale is not None:1101intermediate_parallel = situ_glu(1102intermediate_parallel,1103tanh_clamp_scale,1104self.config.activation_func_tanh_clamp_scale_linear,1105self.config.glu_linear_offset,1106)1107else:11081109def glu(x):1110x_glu, x_linear = torch.chunk(x, 2, dim=-1)1111if (val := self.config.activation_func_clamp_value) is not None:1112x_glu = x_glu.clamp(min=None, max=val)1113x_linear = x_linear.clamp(min=-val, max=val)1114return self.config.activation_func(x_glu) * (1115x_linear + self.config.glu_linear_offset1116)11171118intermediate_parallel = glu(intermediate_parallel)
activations.py#L17-L39(软 clamp 与 SiTU-GLU)
17def tanh_soft_clamp(x: torch.Tensor, scale: float) -> torch.Tensor:18"""Tanh Soft Clamp to precondition activation inputs."""19return (scale * torch.tanh(x.float() / scale)).to(x.dtype)202122@jit_fuser23def situ(x: torch.Tensor, scale: float) -> torch.Tensor:24"""Sigmoid-Tanh Unit from Kimi K3: ``s * tanh(x / s) * sigmoid(x)``"""25return tanh_soft_clamp(x, scale) * torch.sigmoid(x)262728@jit_fuser29def situ_glu(30x: torch.Tensor,31gate_scale: float,32linear_scale: Optional[float] = None,33linear_offset: float = 0.0,34) -> torch.Tensor:35"""SiTU-GLU: ``situ(x_gate, gate_scale) * (x_linear + linear_offset)``."""36x_gate, x_linear = torch.chunk(x, 2, dim=-1)37if linear_scale is not None:38x_linear = tanh_soft_clamp(x_linear, linear_scale)39return situ(x_gate, gate_scale) * (x_linear + linear_offset)
transformer_config.py#L2993-L3013(clamp:仅限 MoE,偏移为 0)
2993if (2994self.activation_func_clamp_value is not None2995and self.activation_func == F.silu2996and self.gated_linear_unit2997):2998if (2999not math.isfinite(self.activation_func_clamp_value)3000or self.activation_func_clamp_value <= 03001):3002raise ValueError(3003"activation_func_clamp_value for SwiGLU must be finite and greater than zero."3004)3005if self.num_moe_experts is None:3006raise ValueError(3007"activation_func_clamp_value for SwiGLU is only supported with MoE."3008)3009if self.glu_linear_offset != 0.0:3010raise ValueError(3011"glu_linear_offset must be zero when activation_func_clamp_value "3012"is set for SwiGLU."3013)
专家中的离群激活可能使一次训练爆炸。要发现它们,请根据 --save-activations-interval 的转储(A.1)离线计算 Step 3.5 Flash 的信号,即每层专家输出范数的最大值与中位数之比156:某个专家与其他专家拉开距离时,会表现为该比值上升。每次转储只保留最后一个 micro-batch 并把它拷贝到 CPU,所以请稀疏地采样。
从你的参照模型的激活方案出发。主流 MoE 用不同的方式限制激活:Step 5 Preview 把 SwiGLU 裁剪在 7,DeepSeek V4.1 Flash 裁剪在 10,Kimi K3 使用 SiTU-GLU 的平滑上限107,154,153。对于新架构,SwiGLU 是个合理的基线。如果专家范数出现分化,请先测试裁剪,在选定限值之前,除了范数还要比较训练 loss。
该看什么
| 部分 | 症状 | 需要关注的信号 |
|---|---|---|
| 数量与大小 | slow:专家 GEMM 很小。有些专家也可能收不到 token。 | profiler 中每个 MoE 层的 grouped-GEMM 时间、每块 GPU 的 TFLOP/s(--log-throughput),以及每个专家的 token 数(--save-tokens-per-expert-interval,A.1)。 |
| Latent MoE | slow:两次额外的投影和更小的专家 GEMM 增加了耗时。blows up:Kimi K3 报告路由分支中的激活爆炸102。 | 对于速度,请把两次潜在投影和更小的专家 GEMM,与减少了的 all-to-all 一起做 profile。对于不稳定性,可以看的一个地方是激活转储中的上投影输出范数(fc2_latent_proj)(A.1);Kimi K3 报告了路由分支的激活增长102。 |
| 共享专家 | 推理时 slow,因为增加了计算量:Mellum2 发现推理更慢131。 | 经过门控后的共享输出,对比经过 combine 以及任何潜在上投影之后的路由输出,来自 A.1 中的稀疏前向 hook。 |
| 可变计算量 | slow:每种专家大小运行各自的 kernel,GroveMoE 报告推理比 Qwen3-30B-A3B 慢约 30%146。 | 逐层的、所选 FFN 数量或专家宽度之和的均值与离散程度,相对于目标计算预算。把每个专家的 token 计数,与每个 EP rank 的计算量及单步耗时一起记录。 |
| 激活函数 | blows up:离群激活。 | 每层专家输出范数的最大值与中位数之比,即 Step 3.5 Flash 的信号156,来自激活转储(A.1)。 |
本节的一切都发生在一个 MoE 层内部,而模型会堆叠许多个这样的层,这就引出了两个我们尚未提出的问题:是否每一层都应该是 MoE 层?围绕每个 MoE 层的 block 又该如何连接?
3.5 Block 布局
把模型想象成一摞 block,每个 block 是注意力后接稠密 MLP 或 MoE 层。每个 MoE 层都通过 all-to-all 把它的 token 发往各自的专家再送回来,所以 MoE 层放在哪里,决定了每一步要做多少次 all-to-all,也决定了哪些层最终均衡得最差。每个 block 如何连接,则决定了每次 all-to-all 中有多少可以藏在注意力计算后面。
| 模型 | 稠密层 | Block 连接方式 |
|---|---|---|
| DeepSeek-V3157 | 前 3 层稠密,其余 58 层为 MoE | 注意力之后接 FFN |
| DeepSeek-V4.1-Flash158 | 全部 40 个 block 都使用 MoE | Single-Pass mHC 残差连接 |
| GLM-5.3101 | 前 3 层稠密,其余 75 层为 MoE | 注意力之后接 FFN18 |
| Kimi K3159 | 第一层稠密,其余 92 层为 MoE | 注意力之后接 Stable LatentMoE;Attention Residuals |
| Llama 4 Maverick160 | 稠密与 MoE 交替,从稠密开始 | 每隔一层放一个 MoE |
| LongCat-Flash161 | 每个 macro-block 内稠密 FFN 与 MoE 共存 | Shortcut 连接的 MoE 与后续的注意力和 FFN 计算重叠 |
| MiMo-V2.6-Pro138 | 第一层稠密,其余 69 层为 MoE | 混合注意力 block 之后接 FFN |
第一个布局决策是哪些层有专家:你可以每层都放 MoE,也可以保留少数几层稠密,或者两者交替。该选哪一种?
稠密层
稠密层没有路由器也没有专家,所以不产生 all-to-all。图 3.5.1 并排统计了三种布局的 all-to-all 数量:每层都放 MoE(如 Qwen3、gpt-oss、MiniMax M2 和 Llama 4 Scout)162、开头若干稠密层,以及每隔一层放 MoE。开头的稠密层只替换最早的几个 MoE 层,如 DeepSeek-V3,它保留前三层稠密163。每隔一层放一个 MoE 则使 all-to-all 减半,如 Llama 4 Maverick,它交替使用稠密层和 MoE 层160。无论哪种方式,你都是舍弃一部分 MoE 容量,换取更少的 all-to-all 和更少的参数。

图中的玩具示例把路由设定为随深度增加而越来越不跟随 token id,所以它的第一层均衡得最慢:开头的稠密层去掉了它最慢的两层,却只削减了 16 次 all-to-all 中的 4 次,而每隔一层放 MoE 使 all-to-all 减半,但保留了第二慢的那一层。在 Ling 的 60 层模型中,开头的稠密层代价很小:在 FLOPs 相当时,把前 1 到 3 层改成稠密几乎没有改变效率,效率杠杆接近 1164。
支持它们的另一个理由是均衡,而这个理由所依据的证据较少。DeepSeekMoE 观察到第一层的均衡收敛得更慢165,Ling 说开头的稠密层缓解了早期层的不均衡166,不过它对这些层的消融只报告了 loss164。后来的报告则指向不同方向。有的让前几层远离学习得到的路由器:图像生成 MoE Nucleus-Image 在没有其开头三个稠密层时发散了167,DeepSeek-V4 则对其前 3 个 MoE 层做哈希53。
另一些仍在那里保留路由,转而处理不均衡。Solar Open 在每一层都使用 MoE,并用序列级辅助损失修正其早期层的不均衡168。Sigma-MoE-Tiny 把每个 token 只路由到 96 个专家中的 1 个,仅用辅助损失时它较低的层塌缩了:loss 走了捷径,使路由器的概率变得均匀,而一些专家仍然几乎得不到 token。它的修复办法是在训练初期让前 8 层为每个 token 激活更多专家,之后再回落到 1 个77。稠密层也不总能终结这个问题:Motif 3 前两层是稠密的,却在训练早期看到它最早的 MoE 层均衡得最差74,而 ERNIE 5.0 在文本上没有发现其第一层存在严重的不均衡169。
Megatron 在 --moe-layer-freq 中把布局作为一个列表,每层一项,0 表示稠密、1 表示 MoE:"([0]+[1]*15)" 表示开头一个稠密层,"([0,1]*8)" 表示像 Maverick 那样以稠密开头的交错。该参数也接受整数,而这种形式会在第 0 层放一个 MoE,所以 --moe-layer-freq 2 是以 MoE 而不是像 Maverick 那样以稠密层开头。稠密层的宽度来自 --ffn-hidden-size,与专家大小分别设置。
Megatron 源码
gpt_layer_specs.py#L635-L645(整数或列表模式)
635if isinstance(config.moe_layer_freq, int):636moe_layer_pattern = [6371 if (i % config.moe_layer_freq == 0) else 0 for i in range(config.num_layers)638]639elif isinstance(config.moe_layer_freq, list):640moe_layer_pattern = config.moe_layer_freq641assert len(moe_layer_pattern) == config.num_layers, (642f"Invalid length of moe_layer_pattern: {len(moe_layer_pattern)}, "643f"expected {config.num_layers}, "644f"current moe layer pattern: {config.moe_layer_freq}"645)
gpt_layer_specs.py#L652-L659(每层为稠密或 MoE)
652layer_specs = []653for layer_number in range(config.num_layers):654if moe_layer_pattern[layer_number] == 1:655layer_specs.append(moe_layer_spec)656elif moe_layer_pattern[layer_number] == 0:657layer_specs.append(dense_layer_spec)658else:659raise ValueError(f"Invalid layer pattern: {moe_layer_pattern}")
上述报告在早期层看到了不均衡,而即使在这些位置放了稠密层,它们之后的第一个 MoE 层仍可能均衡得最差,就像在 Motif 3 中那样。这些第一个 MoE 层是要重点盯住的。请用 --moe-per-layer-logging 跟踪它们的辅助损失,2.4 中的启动器会把其逐层数值发送给 Trackio,并从路由 trace(A.1)中跟踪它们的 MaxVio。稠密层没有路由器可看。z-loss 衡量的是路由器 logits 增长到多大,而不是 token 分布得多均匀。
当你希望以很小的代价减少 all-to-all 时,使用开头的稠密层:在 Ling 的 60 层模型中,一到三层在 FLOPs 相当时几乎没有改变效率164。不要指望它们能修复早期层的不均衡:DeepSeekMoE 和 Ling 都没有给出这方面的数据165,166,而 Motif 3 在两个稠密层之后的第一个 MoE 层中仍然看到了不均衡74。
你保留的每个 MoE 层仍然要把 token 发出去再收回来,而在 MoE 作用于注意力输出的 MoE block 中,GPU 有很大一部分时间都花在等待上。能否重新连接 block,让其中一些流量在注意力计算的同时就传输起来?
Block 连接方式
在 MoE block 中,每次 all-to-all 都与两侧的计算相互依赖。路由器读取注意力的输出,所以注意力完成之前 dispatch 无法开始;下一层读取 MoE 的输出,所以 combine 完成之前,MoE 之后的任何东西都无法开始。Ultra-Scale Playbook 讲解了一般情况下如何让通信与计算重叠。

重新连接 block 可以去掉这些依赖中的一个或两个,释放出来的通信随后就能与计算重叠。并行 block 把相同的输入同时喂给注意力和 MoE,如 Cohere 的 North Mini Code 和 Moondream 3170,因此 dispatch 在注意力计算的同时运行。Combine 更难隐藏,因为它只能与同一层中剩下的工作重叠,在 Megatron 的 shortcut block 里,这些工作是注意力的输出投影和共享专家;两者都没有时,它就暴露在外。Shortcut 连接的 MoE 还能把 combine 也藏在与它并行运行的稠密计算后面,如 LongCat-Flash171 以及 Pos-2(Cai 等人的 shortcut 连接 MoE,即 ScMoE 的首选变体)172。图 3.5.2 在一个 micro-batch 内比较了这三种连接方式,在其示意性的时长下,该层中暴露的 all-to-all 占比从 MoE block 的 33% 降到使用 shortcut 后的 7%。
Megatron 源码
shortcut_block.py#L102-L127(注意力与下一个 MoE 配对)
102compute_layer = layers[physical_index]103paired_type = layer_type_list[physical_index]104if paired_type not in SUPPORTED_SHORTCUT_PREDECESSORS:105raise ValueError(106"Shortcut MoE must be preceded by a Mamba, GDN, or supported attention layer"107)108109supports_two_stage = (110isinstance(compute_layer, TwoStageAttentionLayer)111and compute_layer.supports_two_stage_attention()112)113if not supports_two_stage:114raise ValueError(115f"Shortcut attention layer {paired_type!r} does not support two-stage attention"116)117moe_layer = layers[physical_index + 1]118grouped_layers.append(119ShortcutMoEBlock(120compute_layer,121moe_layer,122overlap_a2a=config.moe_shortcut_parallel,123attn_local_idx=physical_index,124moe_local_idx=physical_index + 1,125)126)127physical_index += 2
shortcut_block.py#L490-L502(路由器读取这一对的输入)
490# Launch the moe_router491with quant_context_factory(moe_config, self.moe_layer_idx):492moe_hidden_states = self._read_shortcut_hidden(493moe_hidden_states, recompute_context=attn_recompute_context494)495route_input, route_probs = self._moe_router_preprocess(496shortcut_hidden=moe_hidden_states,497padding_mask=padding_mask,498packed_seq_params=moe_packed_seq_params,499recompute_context=attn_recompute_context,500)501if overlap:502self.route_ready_event.record(torch.cuda.current_stream())
shortcut_block.py#L362-L368(dispatch 在侧 stream 上进行)
362dispatch_stream = self._get_a2a_overlap_stream()363dispatch_stream.wait_event(self.route_ready_event)364hidden_states.record_stream(dispatch_stream)365probs.record_stream(dispatch_stream)366367with torch.cuda.stream(dispatch_stream):368return self.moe_layer.mlp.dispatch(hidden_states, probs)
shortcut_block.py#L534-L547(dispatch、专家、combine 在注意力结束之前完成)
534# Launch the dispatch, experts, and combine535with quant_context_factory(moe_config, self.moe_layer_idx):536dispatched_input, dispatched_probs = self._launch_dispatch(537route_input, route_probs, async_op=overlap538)539if overlap:540dispatched_input, dispatched_probs = self._wait_dispatch(541dispatched_input, dispatched_probs542)543544output, _ = self.moe_layer.mlp.routed_experts_compute(545dispatched_input, dispatched_probs546)547combined_output = self._launch_combine(output, async_op=overlap)
图中的并行 block 把 dispatch 与注意力重叠,而 combine 仍然暴露;shortcut 连接的 MoE 则用周围的层覆盖了大部分 dispatch 和 combine。代价落在路由器身上,它现在读取的是被重叠的那部分计算之前的 stream,永远看不到那部分计算的输出。
模型会因此学得更差吗?Cai 等人和 LongCat-Flash 团队发现它学得差不多一样好。Cai 等人在一个 LLaMA2 风格的模型的每个 block 中放了一个 MoE,按 Megatron 实现的 ScMoE 变体 Pos-1 连接,它在 zero-shot 基准上的平均分略高于标准的 top-2 MoE173。在 LongCat-Flash 中,有无 shortcut 的 loss 曲线几乎无法区分174。AMD 的 FarSkip-Collective 重新连接 block,使计算在一个尚未包含最新通信输出的残差上继续进行。在 Instella-MoE 中投入使用后,它在 200B 训练 token 之后与 MoE block 的基准平均分持平175,176,尽管 AMD 两份报告的表格都显示它在 MMLU 和 HumanEval+ 上落后。
换来的是速度。以论文中的标准 top-2 MoE 为基线,ScMoE 在单个 NVLink 互联的 8 GPU 节点上训练快了 1.12 倍到 1.14 倍173,Instella-MoE 的预训练吞吐提高了 12.7%177。LongCat-Flash 直接测量了暴露的通信:使用 shortcut 连接的 MoE 后,花在 dispatch 和 combine 上、未被重叠的时间占比从 25.3% 降到 8.4%178,这是在 32 个加速器的专家并行组中,使用流水线式的 all-gather 和 reduce-scatter 取代 all-to-all 得到的。
在 Megatron 中,图中的并行一行(ScMoE 的 Pos-1)是 --moe-shortcut-connection,它让每个 MoE 读取其紧邻之前的注意力层的输入,因此它的路由器不再等待该注意力。共享专家仍然读取注意力的输出,这是图中该行没有画出的细节,而路由专家在主 stream 上于注意力核心之后、其输出投影之前运行,就像该行中的专家跟在它的注意力之后一样。单靠重新连接并不会重叠任何东西:只有当 --moe-shortcut-parallel 把 all-to-all 放到一个侧 CUDA stream 上时,它们才会重叠。合并输出上可选的额外 norm 通过 --moe-shortcut-post-norm 提供。这三个参数都只在上游 main 上有,而且只在混合栈(hybrid stack)中有效,不能与 FSDP、CUDA graph、完整重计算或 --moe-shared-expert-overlap 同时使用。不改变 block 的话,Megatron 也可以把 all-to-all 藏在另一个 micro-batch 后面(3.7 重叠)。
暴露的 all-to-all 会让训练步变慢,而 trace 能显示它有多少暴露在外。请抓取一份 nsys 时间线(--profile 加上 --profile-step-start 和 --profile-step-end,参见 3.7 Profiling),把侧 stream 上的 all-to-all kernel 与主 stream 上的计算作比较:all-to-all 独自运行的那些时段,就是暴露的部分。
当 dispatch 暴露在外、而你又能迁移到 Megatron 的混合栈时,使用 Megatron 的 shortcut block(图中的并行一行):ScMoE 的 Pos-1 设计在一个 8 GPU NVLink 节点上的训练速度是标准 top-2 MoE 的 1.14 倍173。请同时设置 --moe-shortcut-connection 和 --moe-shortcut-parallel,因为只有后者才会使 all-to-all 重叠,并且不要同时使用 FSDP、CUDA graph、完整重计算和 --moe-shared-expert-overlap,它们无法与之一起运行。
该看什么
| 部分 | 症状 | 需要关注的信号 |
|---|---|---|
| 稠密层 | learns badly:第一个 MoE 层均衡很差,或者其路由塌缩。blows up:一个图像生成 MoE 在没有开头稠密层的情况下发散了167。slow:每层都放 MoE 意味着更多的 all-to-all。 | 稠密 block 之后第一个 MoE 层的辅助损失(--moe-per-layer-logging)和 MaxVio(路由 trace,A.1)。 |
| Block 连接方式 | slow:all-to-all 没有被隐藏在计算后面。 | 有多少 all-to-all 暴露在外:在 nsys 时间线中(3.7 Profiling),把侧 stream 上的 all-to-all kernel 与主 stream 上的计算作比较。 |
路由器、均衡器、专家和 block 布局都选定之后,架构就完整了,剩下的是训练它。训练应当从哪里开始?该用哪种优化器?又怎么知道出了问题?
3.6 训练:起点、优化器、稳定性
训练 MoE 会引入稠密模型所没有的失败模式,大型 MoE 背后的团队已经遇到了其中好几种。Switch Transformer 在 bfloat16 下发散了40,ST-MoE 的六次基线运行中有两次变得不稳定41。路由也可能塌缩到少数几个专家上,这种不均衡会自我强化179。是什么使这些训练失败?又如何及早发现你的训练快要出问题了?
| 模型 | 初始化 | 优化器 | MTP | 稳定性选择 |
|---|---|---|---|---|
| DeepSeek-V3163 | 随机初始化 | AdamW | 1 个 MTP 层 | 梯度裁剪范数为 1.0;FP8 训练期间,embedding、输出头、MoE 门控、归一化和注意力保持 BF16 或 FP32 |
| DeepSeek-V4.1-Flash180 | 从零开始 | 线性权重使用 Muon,归一化及非矩阵参数使用 AdamW | 预训练期间无主干 MTP;之后单独训练 DSpark | SwiGLU 裁剪为 10;按模态分别均衡 |
| Kimi K3181 | 从零开始,语言与视觉自始至终联合训练 | 矩阵参数使用 Muon,注意力投影按 head 更新 | 1 个 MTP 层 | 权重裁剪、注意力输出使用 FP32、归一化的 LatentMoE、SiTU-GLU 和分位数均衡 |
| LongCat-Flash182 | 先训练一个 14 层的模型,再堆叠成 28 层 | Adam 系列,超参数按 Adam 的缩放规则迁移 | MTP 用作辅助目标 | 隐藏状态 z-loss、路由器梯度监控、Adam epsilon 取 1e-16,以及确定性计算 |
| Step 3.5 Flash183 | 未报告 | Muon,其 Polar Express 迭代使用 FP16 | 3 个 MTP head | 梯度裁剪为 1.0;专家激活裁剪;在 loss 之外监控专家范数 |
第一个决定是训练从哪里开始:从随机权重,还是从我们在 2.4 中已经训练好的稠密模型。从稠密检查点开始能带给你什么,又要付出什么代价?
Upcycling
Upcycling 从一个训练好的稠密检查点出发,把它的 MLP 复制到各专家中。与稠密 MLP 一样宽的专家得到完整的副本,更窄的专家得到其中一个切片:在我们的实验中,稠密 MLP 宽 8192、专家宽 1024,Megatron 把稠密 MLP 切成 8 片,并把每一片复制到 64 个专家中的 8 个里。无论哪种方式,MoE 都是从稠密训练停下的地方开始。
复制权重之后还剩第二个选择:优化器状态和学习率调度是否也一并沿用。Komatsuzaki 等人让稠密训练的调度从中断处接着继续184,但只在视觉模型上复用了优化器状态,因为在语言模型上它没有带来改进185。Megatron 的 upcycling 步骤在第 1 次迭代时保存不带优化器状态的 MoE(training.py#L3069-L3083),所以 MoE 训练以全新的优化器和新的调度开始。
这个领先优势不是免费的:它就是已经花在稠密训练上的计算量,而从零开始的训练最终会追上 upcycle 的训练。追上所需的时间差别很大。在 OLMoE 中,从零开始的训练在 500B token 之后追上,这是稠密模型已训练的 2T token 的 25%186;而在 Komatsuzaki 等人的 sparse upcycling 实验中,则花了稠密检查点计算量的 120%187。下图根据 OLMoE 公开的训练日志重绘了它的对比:在稠密的 OLMo-1B 训练 2T token 之后 upcycle 得到的 MoE,与从零训练的同一个 MoE,各训练 610B token。

图中,upcycle 的训练在四项指标上都起步领先,而从零开始的训练只是逐渐缩小差距。它的 HellaSwag 和 MMLU 准确率在约 500B token 时与 upcycle 的训练持平,作者把追平点定在这里,而它的训练和验证 loss 直到约 600B token 之前都略高。
训练好的 MoE 也可以用同样的方式扩展:复制自己的专家,而不是稠密 MLP。下图把一个 8 专家的 MoE 变成 16 专家的 MoE,并展示这些副本对路由产生了什么影响。

在 top-2 路由下,每个副本继承其原件的路由器行时,图中完全相同的副本会打平:每个 token 以相等的权重选中一个专家及其副本,所以它实际只运行一个不同的专家而不是两个。扰动副本会给路由器带来这一对之间的梯度,随机的新专家则避免了打平,但会把路由权重放在未经训练的专家上。这三种做法都被用来扩展 MoE:Expert Upcycling 把每个专家连同其路由器行一起复制,从 32 个专家扩到 64 个188;K-EXAONE 2.0 对每个副本加一个随机旋转,从 128 个扩到 256 个189;Expert Upcycling 还测试了 Drop-Upcycling,它重新初始化每个副本的一部分权重,在其作者发现的最佳设置中是一半190,191;EMO 则从高斯分布中抽取新的专家和路由器行192。在 Megatron 中,从稠密检查点 upcycle 是 --moe-use-upcycling 加上 --moe-upcycling-granularity,在固定的提交上它需要 2.5 中描述的两处本地修复。
Megatron 源码
training.py#L3043-L3083(构建稠密模型、upcycle、保存)
3043if args.moe_use_upcycling:3044torch.distributed.barrier()3045assert not checkpoint_exists(args.save), (3046"The upcycling destination directory already exists. "3047"Please check if --moe-use-upcycling is mistakenly enabled. "3048"Upcycling should only be set for the first run when converting the dense model. "3049"All subsequent runs should remove this flag. "3050)3051# before changing moe related global args, save them in local variables3052num_experts = args.num_experts3053expert_model_parallel_size = args.expert_model_parallel_size3054moe_ffn_hidden_size = args.ffn_hidden_size30553056# set dense model related args in to global args before getting dense model3057args.num_experts = None3058args.expert_model_parallel_size = 13059args.ffn_hidden_size = moe_ffn_hidden_size * args.moe_upcycling_granularity30603061# get dense model3062dense_model_for_upcycling = _build_model_wrapper(wrap_with_ddp=True)30633064# recover moe upcycling related args in global args before executing upcycling3065args.num_experts = num_experts3066args.expert_model_parallel_size = expert_model_parallel_size3067args.ffn_hidden_size = moe_ffn_hidden_size30683069# execute upcycling3070_, args.num_floating_point_operations_so_far = upcycling_utils.load_and_upcycle_model(3071load_checkpoint,3072unwrapped_model,3073dense_model_for_upcycling,3074load_kwargs={3075'model': dense_model_for_upcycling,3076'optimizer': None,3077'opt_param_scheduler': None,3078},3079)3080args.iteration = 13081save_checkpoint(3082args.iteration, model, None, None, args.num_floating_point_operations_so_far3083)
upcycling_utils.py#L145-L178(缩放、切分、逐专家复制)
145def _get_moe_activation_scale():146"""147Calc moe activation scale factor relative to dense activation.148For more detail please refer to https://arxiv.org/abs/2410.07524.149"""150if moe_router_pre_softmax:151moe_activation_scale = (expansion_rate * granularity * granularity) / moe_router_topk152else:153moe_activation_scale = granularity154return moe_activation_scale155156def _get_weight_scale():157moe_activation_scale = _get_moe_activation_scale()158if gated_linear_unit == True:159scale = moe_activation_scale ** (1 / 3)160elif activation_func_name == ActivationFuncName.squared_relu:161scale = moe_activation_scale ** (1 / 3)162else:163scale = moe_activation_scale ** (1 / 2)164return scale165166def _process_fc1_weight_param(param):167param = param.clone()168scale = _get_weight_scale()169param = param * scale170if activation_func_name == ActivationFuncName.silu and gated_linear_unit == True:171param_1, param_2 = torch.chunk(param, 2, dim=0)172params_1 = torch.tensor_split(param_1, granularity, dim=0)173params_2 = torch.tensor_split(param_2, granularity, dim=0)174params = [torch.cat([params_1[i], params_2[i]], dim=0) for i in range(granularity)]175else:176params = torch.tensor_split(param, granularity, dim=0)177params = params * expansion_rate178return params
在固定的提交(d6316eb45)上,这条路径只有做了两处本地修复才能为我们跑通(2.5)。请把模型以其参数名 ddp_model 传给 load_checkpoint:
checkpointing.py#L2632-L2635(ddp_model 参数)
2632def load_checkpoint(2633ddp_model,2634optimizer,2635opt_param_scheduler,
然后用 num_experts 未设置的参数来构建稠密模型,而不是用 pretrain_gpt.py 在启动时一次性生成的配置容器来构建,这样稠密检查点才能加载进一个稠密模型:
training.py#L2917-L2925(由配置容器构建的模型)
2917def _build_model_wrapper(wrap_with_ddp: bool):2918if cfg_container is not None and getattr(cfg_container, "model", None) is not None:2919from megatron.training.utils import start_memory_history_recording29202921start_memory_history_recording(cfg_container.profiling)29222923cfg = cfg_container2924model_config = cfg.model2925builder_cls = model_config.get_builder_cls()
出了问题的 upcycle 会丢掉它的领先优势,所以请把它的 loss 与继续训练相同 token 数的稠密训练做比较。由于专家起初是完全相同的副本,在它们逐渐分化的过程中,还要关注逐层的 MaxVio,可根据路由 trace 离线计算(A.1)。
当已有稠密检查点、而 MoE 训练又很短时使用它,因为从零开始的训练,在 OLMoE 中是在稠密模型训练 token 数的 25% 之后追上的,在 Komatsuzaki 等人的实验中则花了其 120% 的计算量186,187。Upcycling 是一种初始化,所以只应在第一次运行时设置,并且在固定的提交上要先应用 2.5 中的两处本地修复。
无论是 upcycle 还是从随机权重开始,决定的都只是权重从哪里起步;从第一步起,决定它们去向的是优化器。然而每个专家只看到被路由到它的 token,那么优化器是否应该让一个只收到寥寥几个 token 的专家,和一个很忙的专家移动同样远?
优化器
AdamW(DeepSeek-V3 所用的优化器)163按每个权重自己的梯度历史缩放其更新,所以一个专家移动多远,取决于它的 token 产生的梯度。Muon 是若干近期 MoE 采用的权重矩阵优化器,它以另一种方式确定步长:它对每次更新做正交化,把其非零奇异值推向 1,然后乘以一个仅由矩阵形状决定的缩放,因此步长大小不再取决于其背后的梯度有多大。
Megatron 对每个专家的矩阵单独做正交化(transformer_engine.py#L2665-L2668、transformer_config.py#L956、emerging_optimizers.py#L147-L149),DeepSeek-V4 也是如此193,所以路由器很少选中的专家可以移动得和最忙的专家差不多远,只是沿着它自己的方向,而且即使在某一步中它没有收到任何 token,也会沿着它的动量继续移动。下图展示了这在 49 个玩具专家上意味着什么,绘制了更新大小相对于每步 token 数的关系,分别针对 AdamW、对每个专家单独应用的 Muon,以及把所有专家当作一个矩阵的 Muon。

在这个玩具示例中,随着一个专家的 token 减少,它的更新在 AdamW 下会缩小(因为梯度变成了噪声),在把所有专家当作一个矩阵的 Muon 下则随其梯度的大小缩小,而逐专家的 Muon 则把最忙专家的步长保持到每步只有几个 token 时。再往下,逐专家的步长也会缩小:每个 token 只为梯度增加一个方向,token 少到那种程度时,连近期各步的动量也无法填满专家的矩阵。
图中展示了 Muon 如何移动每个专家;至于它是否训练出更好的 MoE,已经在完整模型上测量过。Moonlight 是一个激活参数 3B、总参数 16B 的 MoE,在相同设置下,用 Muon 训练的版本比用 AdamW 训练的孪生模型明显更好,二者在约 1.2T token 处做比较194。
一旦用上 Muon,还剩下一个采用者们做法不同的选择:由哪个优化器更新路由器。DeepSeek-V4 让它继续使用 Muon193,而 Qwen3.8-Next 在 Muon 使路由器在训练早期不稳定之后,把它改到了 AdamW195。Lau 和 Su 在两个小型 MoE 上比较了路由器的优化器,一个形状类似 OLMoE-1B-7B,另一个是缩小版的 gpt-oss:隐藏矩阵使用 Muon 时,路由器使用 AdamW 的最终结果略逊于按行归一化或 left-spectral 的路由器更新196。
在 Megatron 中,Muon 是 --optimizer muon;若想让路由器改用 Adam,请添加 --moe-router-skip-muon,从 Megatron Core v0.20 起可用。
Megatron 源码
emerging_optimizers.py#L147-L154(哪些参数交给 Adam)
147def _is_nonlinear_or_embedding(param):148"""True for parameters that should NOT use the emerging optimizer."""149return getattr(param, 'is_embedding_or_output_parameter', False) or len(param.shape) != 2150151152def _is_muon_excluded(param):153"""True for parameters that should use the scalar optimizer instead of Muon."""154return not getattr(param, 'use_muon', True) or _is_nonlinear_or_embedding(param)
router.py#L88-L91(路由器不使用 Muon)
88if self.config.moe_router_skip_muon:89setattr(self.weight, 'use_muon', False)90if self.bias is not None:91setattr(self.bias, 'use_muon', False)
emerging_optimizers.py#L303-L324(先正交化,再按形状缩放)
303if scale_shape is None:304size = [grad.size(-2), grad.size(-1)]305if partition_dim is not None:306size[partition_dim] *= get_pg_size(tp_group)307else:308# This overrides only the final Muon scalar; NS still uses grad's physical309# shape and partition metadata for its collectives.310size = scale_shape311# Only forward the kwarg when enabled; older emerging_optimizers do not312# accept it at all, and __init__ has already rejected use_syrk on those.313ns_kwargs = {"use_syrk": True} if use_syrk else {}314orth_grad = newton_schulz_tp(315grad,316steps=num_ns_steps,317coefficient_type=coefficient_type,318tp_group=tp_group,319partition_dim=partition_dim,320tp_mode="duplicated" if tp_mode_this_group == "blockwise" else tp_mode_this_group,321**ns_kwargs,322)323scale_factor = get_muon_scale_factor(size[0], size[1], mode=scale_mode)324return orth_grad * scale_factor * extra_scale_factor
arguments.py#L1792-L1798(堆叠的专家:未定义)
1792assert not (1793args.use_layer_wise_distributed_optimizer and args.moe_single_grouped_weight1794), (1795"The LayerWise distributed optimizer does not support --moe-single-grouped-weight: "1796"Muon semantics for a single grouped [E, N, K] expert weight are not defined. "1797"Disable --moe-single-grouped-weight or use Adam/DistributedOptimizer."1798)
在 Muon 下,专家可能塌缩197,更新缩放太大可能使训练发散198。请跟踪每个专家接收到什么、产生了什么:每步每个专家的 token 数,根据路由 trace 离线计算(A.1);以及逐层的最大和最小专家输出范数(各自除以该层的中位数),来自我们的一个前向 hook(A.1)。
Use Muon when you can afford to tune it. Start at --muon-extra-scale-factor 0.2, since Megatron's default of 1.0 diverged on a dense 7B in Mellum2's tests198, and choose the router's optimizer with --moe-router-skip-muon, a call adopters make both ways. It does not run with Megatron-FSDP or Torch-FSDP2.
无论优化器如何移动权重,每一步仍然只从预测下一个 token 中学习。能否通过预测得更远,从每一步中获得更多信号?这会让单步耗时付出什么代价?
MTP
多 token 预测(multi-token prediction)为每个额外要预测的 token 增加一个 Transformer 层。该层把主模型的隐藏状态与下一个 token 的 embedding 一起输入,并通过共享的输出头预测下下个 token。DeepSeek-V3 发现,在它测试的两个规模上,它在大多数基准上都更好,而且额外的层在推理时可以丢弃199。下图跟踪序列中的一个位置经过这套连接的过程。

输入进来时,两个输入各自经过自己的 RMSNorm,MTP 层把它们拼接起来,并在进入其 Transformer block 之前,把结果从两倍隐藏维度投影回原来的隐藏维度。两个预测都来自同一个输出头,MTP loss 加权后加到主 loss 上199。
额外的层会耗费单步时间,而在流水线并行下,这个代价集中落在一个地方:除非布局把它挪开,Megatron 会把 MTP 层放在最后一个 stage 上(multi_token_prediction.py#L886-L905),那里已经有 MTP 层所复用的输出头。在我们的 256 节点运行中,带一个 MTP 层的早期步骤比不带时慢约 37%,把模型分散到 8 个流水线 stage 上也没有弥补这个差距。Mellum2 报告一个 14B MoE 额外多花 7% 的训练时间200。
Megatron 源码
multi_token_prediction.py#L1709-L1714(隐藏状态加下一个 token 的 embedding)
1709hidden_states = apply_module(self.hnorm)(hidden_states)1710hidden_states = make_viewless_tensor(1711inp=hidden_states, requires_grad=True, keep_graph=True1712)1713hidden_states = torch.cat((decoder_input, hidden_states), -1)1714hidden_states, _ = self.eh_proj(hidden_states)
multi_token_prediction.py#L1276-L1276(loss 乘以随深度变化的因子)
1276mtp_loss_scale = config.mtp_loss_scaling_factor / config.mtp_num_layersmulti_token_prediction.py#L932-L937(无布局:最后一个 stage)
932# without custom PP layout, we only support put all of MTP layers on the last pipeline stage933if mtp_num_layers is not None:934if pp_size is None:935# Compatibility fallback for callers without explicit pipeline metadata.936pp_size = parallel_state.get_pipeline_model_parallel_world_size()937mtp_on_this_rank = pp_rank == pp_size - 1
multi_token_prediction.py#L2598-L2599(detach 切断主干梯度)
2598if self.config.mtp_detach_heads:2599hidden_states = hidden_states.detach()
这个差距的很大一部分可能来自该层所在的位置。流水线的一步要等它最慢的 stage,所以加在某个 stage 上的一层会按它占该 stage 工作量的比例拖慢这一步,而不是按它占整个模型小得多的比例。Ling 2.0 团队遇到过同样的失衡:他们测得一个 MTP 层的计算量约为标准 MoE 层的 1.7 倍,围绕它重新划分流水线,端到端提升了 40%201。
Megatron 用 --mtp-num-layers 打开 MTP,其值为要增加的额外深度数,--mtp-loss-scaling-factor 为 MTP loss 加权:DeepSeek-V3 在前 10T token 使用 0.3,之后使用 0.1163,Mellum2 使用 0.1200。要选择哪个 stage 持有 MTP 层(记作 m),请使用 --pipeline-model-parallel-layout。如果你只想把 MTP 层作为 speculative decoding 的 draft 模型,--mtp-detach-heads 会把它的输入 detach,这样 MTP loss 只训练 MTP 层而不影响主模型。
只要 MTP 打开,Megatron 就会在 lm loss 旁边记录一个 mtp_1 loss,而 MTP 层的代价则体现在别处:体现在单步耗时和持有它的 stage 的显存中。要找出慢的 stage,请用 --timing-log-level 2 --timing-log-option all(A.1)记录每个流水线 rank 的前向和反向计算时间;持有 MTP 层的 stage 应该表现为最慢的 rank。
当 DeepSeek-V3 所报告的更密集的训练信号199值得为之付出单步耗时时使用它。在流水线并行下,请用 --pipeline-model-parallel-layout 放置 MTP 层,否则由最后一个 stage 承担它。
到目前为止,每一部分都告诉了你该为它自己的选择留意什么。然而有些失败不属于任何单一选择,可能从模型中的任何地方开始,那么每次训练都应该配备什么来捕捉它们?
稳定性
MoE 训练可能大张旗鼓地失败,也可能悄无声息地失败。明显的失败体现在 loss 上,它飙升或变成 NaN;而悄无声息的失败,比如路由塌缩76或流氓专家(rogue expert)15,可能让 loss 保持平稳。
最响的失败也是最容易发现的,因为 Megatron 默认每一步都会检查 loss 和梯度是否有 NaN(3.0)。接下来你想知道的是该不该怪硬件,所以检查触发时,Megatron 会重新运行该步(--rerun-mode validate_results,也是默认开启的)。第一次重跑在同一块 GPU 上,用来区分瞬时错误与会重复出现的错误。如果 NaN 重复出现,Megatron 会以退出码 16 退出,使作业从检查点在另一块 GPU 上重启,在那里第二次重跑能区分是 GPU 故障,还是数据或模型真的产生了 NaN。
糟糕的硬件和糟糕的 batch 并不总是以 NaN 告终,因为它们也可能返回有限但指数大得离谱的 loss 或梯度。Megatron 用 --check-for-spiky-loss 和 --check-for-large-grads 捕捉这些:每一个都会标记比它已见过的前 100 个值中最大者大 10 倍的值,在同一块 GPU 上重跑该步一次,记录该值是否复现,并继续训练。
所有这些检查都是对已经出错的步骤做出反应。为了从一开始就防止 loss 崩坏,3.1 已经通过 fp32 运算和压低其 logits 的 z-loss 保护了路由器,近期的大型 MoE 还增加了各自的防护。有些在数值增长之前给它设上限:DeepSeek-V3 和 Step 3.5 Flash 对梯度范数做裁剪163,183,DeepSeek-V4.1-Flash 对专家的 SwiGLU 激活做 clamp180,Step 3.5 Flash 还对专家激活做裁剪183。另一些则让最敏感的运算保持更高精度:DeepSeek-V3 在 FP8 训练期间让 embedding、输出头、MoE 门控、归一化和注意力保持 BF16 或 FP32163,Kimi K3 让注意力输出保持 FP32181。LongCat-Flash 把 z-loss 的思路延伸到了隐藏状态上182。
悄无声息的失败可能根本不会显示在 loss 中,所以你得到别处去找。下图在一次健康的运行旁边模拟了其中三种:路由塌缩、死专家和流氓专家。

由于模拟让 loss 在这三种失败中都保持平稳,只有其他信号能把它们与健康的运行区分开。路由塌缩会使 MaxVio 上升。死专家会把最小的专家输出范数拉到远低于该层的中位数,而流氓专家则把最大的推到远高于中位数,如 Step 3.5 Flash 第 45 层那样,从约 14 倍涨到约 5,700 倍中位数15。loss 告警(比迄今最低 loss 高出 0.1)借用了 Qwen3.8-Next 的尖峰判据中的阈值202。
Megatron 源码
pretrain_gpt.py#L263-L292(NaN、Inf、loss 尖峰)
263# Check individual rank losses are not NaN prior to DP all-reduce.264rerun_state_machine = get_rerun_state_machine()265if args.check_for_nan_in_loss_and_grad:266rerun_state_machine.validate_result(267result=loss,268rejection_func=torch.isnan,269message="found NaN in local forward loss calculation",270tolerance=0.0, # forward pass calculations are deterministic271fatal=True,272)273rerun_state_machine.validate_result(274result=loss,275rejection_func=torch.isinf,276message="found Inf in local forward loss calculation",277tolerance=0.0, # forward pass calculations are deterministic278fatal=True,279)280# Check for spiky loss281if args.check_for_spiky_loss:282rerun_state_machine.validate_result(283result=loss,284rejection_func=partial(285rerun_state_machine.is_unexpectedly_large,286threshold=SPIKY_LOSS_FACTOR,287context="loss",288),289message="Spiky loss",290tolerance=0.0, # forward pass calculations are deterministic291fatal=False,292)
param_and_grad_buffer.py#L389-L425(逐 bucket 的梯度范数检查)
389def check_grads(self, check_for_nan_or_inf, check_for_large):390"""391Make sure norm of grads in bucket are not NaN prior to data-parallel392all-reduce / reduce-scatter.393"""394rerun_state_machine = get_rerun_state_machine()395for i in range(len(self.buckets)):396grad_norm = self.buckets[i].grad_data.norm(p=2)397# check for NaN, Inf and unexpectedly large grads398if check_for_nan_or_inf:399rerun_state_machine.validate_result(400result=grad_norm,401rejection_func=torch.isnan,402message=f"found NaN in local grad norm for bucket #{i} "403f"in backward pass before data-parallel communication collective",404tolerance=0.001, # 0.1% tolerance to account for non-deterministic FA backward405fatal=True,406)407rerun_state_machine.validate_result(408result=grad_norm,409rejection_func=torch.isinf,410message=f"found Inf in local grad norm for bucket #{i} "411f"in backward pass before data-parallel communication collective",412tolerance=0.001, # 0.1% tolerance to account for non-deterministic FA backward413fatal=True,414)415if check_for_large:416rerun_state_machine.validate_result(417result=grad_norm,418rejection_func=partial(419rerun_state_machine.is_unexpectedly_large, threshold=10, context="grads"420),421message=f"found unexpected large grads in bucket #{i} "422f"in backward pass before data-parallel communication collective",423tolerance=0.001, # 0.1% tolerance to account for non-deterministic FA backward424fatal=False,425)
rerun_state_machine.py#L752-L766(早期最大值的 10 倍)
752value: float = math.fabs(result.item())753# Ignore NaNs and Infs. They should be checked separately.754if math.isnan(value) or math.isinf(value):755return False756757if resample or context not in self.large_value_counts:758self.large_value_counts[context] = 0759if self.large_value_counts[context] < num_samples:760self.large_value_counts[context] += 1761self.max_values[context] = max(self.max_values.get(context, 0.0), value)762if self.large_value_counts[context] == num_samples:763logger.warning(f"Max value for {context}: {self.max_values[context]}")764return False765766return value >= self.max_values[context] * threshold
rerun_state_machine.py#L622-L694(先在这里重跑,再换别处)
622if self.state == RerunState.RERUNNING_IN_PLACE:623if comparison > tolerance:624if not fatal:625self.continue_requested = True626log_failure(627"First rerun: unexpected result is not reproducible within the tolerance "628f"({result} != {self.initial_result})",629fatal=fatal,630)631self._log_validation_error_to_file(632status=RerunValidationStatus.FIRST_RERUN_NOT_REPRODUCIBLE,633result=result,634message=message,635)636log_failure("Possible transient error!", fatal=fatal)637638else:639if fatal:640self.checkpoint_requested = True641else:642self.continue_requested = True643# Remember the node and device we're running on so that we can check we're not644# rerunning on the same GPU when we resume from the checkpoint.645self.suspicious_node = os.uname()[1]646self.suspicious_device = torch.cuda.current_device()647self._log_validation_error_to_file(648status=RerunValidationStatus.FIRST_RERUN_REPRODUCIBLE,649result=result,650message=message,651)652log_failure(653"First rerun: unexpected result is reproducible within the tolerance "654f"({result} = {self.initial_result}). "655"Need to rerun on a different GPU to verify correctness.",656fatal=fatal,657)658# This is the second re-run.659elif self.state == RerunState.RERUNNING_FROM_CHECKPOINT:660# Ensure we're not on the same GPU as the first rerun.661node = os.uname()[1]662device = torch.cuda.current_device()663if node == self.suspicious_node and device == self.suspicious_device:664logger.error(665f"Got rescheduled on the same GPU. Need to resume again from the same "666f"checkpoint (node: {self.suspicious_node}, gpu: {self.suspicious_device})"667)668self.restart_again_requested = True669elif comparison > tolerance:670self._log_validation_error_to_file(671status=RerunValidationStatus.SECOND_RERUN_NOT_REPRODUCIBLE,672result=result,673message=message,674)675logger.warning(676"Second rerun: unexpected result is not reproducible on a different GPU, "677f"therefore was likely incorrect ({result} != {self.initial_result})"678)679log_failure("Possible persistent error!")680if not fatal:681self.continue_requested = True... 13 more lines
对于尖峰,请通过 z-loss 观察路由器的 logits(3.1)。让 loss 保持平稳的失败需要它们自己的信号:对于路由塌缩,是逐层的 MaxVio(根据路由 trace 离线计算,A.1),并与负载均衡 loss 一起看;对于死专家和流氓专家,是每层最大和最小的专家输出范数除以该层中位数,来自我们的一个 hook(A.1)。
请始终使用:保留默认的 NaN 检查和 --rerun-mode validate_results。
该看什么
| 部分 | 症状 | 需要关注的信号 |
|---|---|---|
| Upcycling | learns badly:loss 起初下降缓慢。 | 与继续训练相同 token 数的稠密训练对比 loss。在复制出来的专家逐渐分化期间,同时关注逐层的 MaxVio(路由 trace,A.1)。 |
| 优化器 | learns badly:专家塌缩。blows up:正交化以 bf16 运行时,或更新缩放太大时。 | 每步每个专家的 token 数(路由 trace,A.1)。逐层的最大和最小专家输出范数,各自除以中位数(前向 hook,A.1)。 |
| MTP | slow:一个流水线 stage 比其他的耗时更长。OOM:53 层、4 个流水线 stage 加 MTP 时显存溢出。 | mtp_1 loss 与 LM loss 一起看;单步耗时和峰值显存;每个流水线 rank 的前向和反向计算时间(--timing-log-level 2 --timing-log-option all,A.1),尤其是持有 MTP 的 stage201。 |
| 稳定性 | blows up:NaN 和 loss 尖峰。learns badly:路由塌缩、死专家或流氓专家。 | 路由器 z-loss(3.1),对应 ST-MoE 把其不稳定性追溯到的路由器 logits38。逐层的 MaxVio(路由 trace),以及最大和最小专家输出范数除以中位数(A.1)。 |
一次训练即使顺利,每一步仍可能有很大一部分时间花在等待通信而不是计算上。MoE 的一步,时间都去了哪里?又能拿回多少?
3.7 系统:时间花在哪里,又如何拿回来
每个 MoE 层都把它的 token 送到各自的专家再带回来,在真实的训练中,这些流量可能占去一步的大部分时间。在我们于一个节点上 trace 的那一步中,一半的时间是暴露的 all-to-all,当时路由器仍然不均衡。下图放大了这两次传输,即发往专家的 dispatch 和返回的 combine,它们在节点内通过 NVLink 运行,跨节点则通过网络结构(fabric)运行。
你可以通过放置专家,让更少的流量经过节点之间较慢的网络,并把剩下的流量藏在其他计算后面。你可以控制这些做法所需的显存,限制每个 token 到达的节点数,并拿丢弃 token 或降低精度来换取速度。每一部分来自各自的配置,所以不要把它们的收益相加;请把它们当作可选项,一次测试一个。
| 模型 | 互联与重叠 | 显存与精度 | 路由约束 |
|---|---|---|---|
| DeepSeek-V3203 | 跨 8 个节点的 EP64;DualPipe 使计算与通信重叠 | FP8 混合精度训练;重计算 RMSNorm、MLA 上投影和 SwiGLU 输出 | 每个 token 最多 4 个目标节点;不丢弃 token |
| DeepSeek-V4204 | 融合的 MoE 流水线按波次调度各专家组,使 dispatch、GEMM 和 combine 重叠 | 张量级检查点与选择性重计算 | 取消了 V3 的目标节点数限制 |
| Kimi K3205,21 | 优化器只获取本地持有的参数分片;通信与计算流水线化 | 避免全参数 gather 缓冲区;SFT/RL 使用 MXFP4 专家权重和 MXFP8 激活 | 发布的配置中只有一个专家组206 |
| LongCat-Flash178,207 | 32 个加速器的 EP 组;流水线式 all-gather/reduce-scatter 以及 shortcut 连接的 MoE | 使用确定性 kernel 的 BF16 训练 | 恒等专家无需专家通信 |
在动用这些手段之前,你需要先看看自己的训练步把时间花在了哪里,因为每一种浪费需要不同的修复办法。在单个节点上 profile 一步,会显示什么?
Profiling
Megatron 可以为你记录任意一步的 trace。仅使用 --profile 时记录 nsys trace,--use-pytorch-profiler 则切换成 torch profiler trace(argument_utils.py#L706-L709)。无论哪种情况,--profile-step-start、--profile-step-end 和 --profile-ranks 都用来选择要 trace 哪些步和 rank。我们 trace 的那一步来自一个 7B-A1B 的 MoE,总参数 7B,每个 token 激活 1B。它的 16 层各有 64 个专家、top-8 路由,在一个 8 块 H100 的节点上训练。trace 它只花了一次很短的作业,抓取了第 4 次迭代,并在启动后大约六分钟内就已越过了它。下面的图把那一步拆解开来,并标注了它的 trace。


all-to-all 占了那一步的一半,但这一半里有多少真的是网络在搬运数据?当某块 GPU 的专家比其他的得到更多 token 时,那块 GPU 会较晚完成它的专家计算,NVIDIA 的 Megatron Core 团队报告说,其他 rank 随后会在同步点等待它208。在 MoE 层中,all-to-all 可能就是这样的同步点之一,所以它在 trace 中的一部分时间可能是在等待,而不是在搬运数据。我们这一步的负载均衡 loss 为 3.2(1 表示均衡),所以它的路由器仍然不均衡。同一配置的另一次运行,在强制路由均匀的情况下,同一次迭代快了 40%。
Megatron 源码
training.py#L4955-L4982(每个 rank 的 torch profiler 窗口)
4955if (4956cfg.profiling.use_pytorch_profiler4957and (len(cfg.profiling.profile_ranks) == 0 or4958torch.distributed.get_rank() in cfg.profiling.profile_ranks)4959):4960if cfg.profiling.pytorch_profiler_collect_chakra:4961et_dir = Path(f"{cfg.logger.tensorboard_dir}/../chakra")4962et_dir.mkdir(parents=True, exist_ok=True)4963et = torch.profiler.ExecutionTraceObserver().register_callback(f"{et_dir}/rank-{torch.distributed.get_rank()}.json.gz")4964else:4965et = None4966def trace_handler(p):4967profile_dir = Path(f"{cfg.logger.tensorboard_dir}/../torch_profile")4968profile_dir.mkdir(parents=True, exist_ok=True)4969p.export_chrome_trace(f"{profile_dir}/rank-{torch.distributed.get_rank()}.json.gz")4970prof = torch.profiler.profile(4971schedule=torch.profiler.schedule(4972wait=max(cfg.profiling.profile_step_start - 1, 0),4973warmup=1 if cfg.profiling.profile_step_start > 0 else 0,4974active=cfg.profiling.profile_step_end - cfg.profiling.profile_step_start,4975repeat=1,4976),4977on_trace_ready=trace_handler,4978record_shapes=cfg.profiling.pytorch_profiler_collect_shapes,4979with_stack=cfg.profiling.pytorch_profiler_collect_callstack,4980execution_trace_observer=et,4981)4982prof.start()
training.py#L5041-L5053(在指定步启动 nsys)
5041if ((cfg.profiling.use_nsys_profiler or cfg.profiling.use_pytorch_profiler)5042and (len(cfg.profiling.profile_ranks) == 0 or5043torch.distributed.get_rank() in cfg.profiling.profile_ranks)):5044# Enable NVTX range when profiling starts and nvtx_ranges is set.5045if iteration == cfg.profiling.profile_step_start and cfg.profiling.nvtx_ranges:5046configure_nvtx_profiling(True)5047if cfg.profiling.use_pytorch_profiler:5048prof.step()5049elif iteration == cfg.profiling.profile_step_start:5050torch.cuda.check_error(torch.cuda.cudart().cudaProfilerStart())5051if cfg.profiling.record_shapes:5052nsys_nvtx_context = torch.autograd.profiler.emit_nvtx(record_shapes=cfg.profiling.record_shapes)5053nsys_nvtx_context.__enter__()
在你自己的训练上,请从 3.2 的均衡信号入手。根据 --save-tokens-per-expert-interval 写出的 token 计数计算 MaxVio,可以看出专家之间的负载有多不均匀。把这些计数按每块 GPU 的专家求和,可以看出哪个 rank 接收的 token 最多,也就是其他 rank 最可能在等待哪一个。要了解这种不均衡使 all-to-all 多花了多少,请用 --moe-router-force-load-balancing 重新 trace,它把路由器的 logits 换成随机值,使每个专家得到大致相同的负载(router.py#L1185-L1187)。如果在强制均衡下 all-to-all 缩短了,说明不均衡正在耗费你的时间,而更好的均衡(3.3)可以把它赢回来;剩下的主要就是传输本身,本节其余部分将处理它。
Trace 还能显示哪些 MoE kernel 值得融合。dispatch 之前,Megatron 会重新排序 token,使每个专家的 token 聚在一起(token_dispatcher.py#L668-L682),combine 之后再把它们按顺序放回去(#L893-L900)。使用 --moe-permute-fusion 后,完成这件事的 permute 和 copy kernel 占该步的比例从 11.45% 降到 7.14%,单步耗时下降 3.3%。
请用单步耗时或 TFLOP/s 来评判每一项改动。trace 随后会告诉你数字为什么变了:读一读 all-to-all 暴露在外的那部分占该步的比例。
每个新配置都用一次:以你将要运行的节点数 trace 一步。如果 all-to-all 占了其中很大比例,请检查 MaxVio,并用 --moe-router-force-load-balancing 重新 trace:如果 all-to-all 缩短了,先修复均衡(3.3);如果没有,则处理下面的“互联与重叠”。如果 permute 和 copy kernel 占比很大,请试试 --moe-permute-fusion。
我们 trace 的那一步把 all-to-all 保持在单个节点内、走 NVLink,而更大规模的训练并不总能做到这一点。当专家并行组跨越两个节点、all-to-all 必须穿过它们之间的网络时,这一步会发生什么?
互联
在节点之间,all-to-all 离开 NVLink,转而走集群的网络结构(例如 InfiniBand 或 AWS 的 EFA),所以首先要检查的是 NCCL 究竟有没有使用这个网络结构。即使请求了该网络结构,它也可能回退到普通的 TCP socket:我们有两次运行设置了 FI_PROVIDER=efa 并指定了 OFI 插件,NCCL 仍然记录了“Using network Socket”,它们比我们在 EFA 上的 EP16 运行慢了约 25 倍。下一幅图按顺序展示了我们尝试过的设置。

图中,只有当主机的 RDMA 库排在库路径最前面时,NCCL 才用上了 EFA;无论按路径还是按名称指定插件,都仍停留在 socket 上。网络结构正常工作后,剩下要选的是专家并行大小 --expert-model-parallel-size,它决定 all-to-all 要传输多远。在专家张量并行为 1 且采用默认 rank 顺序时,Megatron 用连续的 rank 组成每个 EP 组(parallel_state.py#L921-L929)。能整除节点内 GPU 数量的 EP 大小,会让 all-to-all 保持在该节点内、走 NVLink,更大的则把它分散到多个节点上。我们的每个节点有八块 H100,所以下图比较了一个节点内的 EP8 与跨两个节点的 EP16。

分散到两个节点上时,即使 EFA 正常工作,EP16 的速度也比单节点内的 EP8 低 59%,尽管这两次运行在节点以及每步累积的 micro-batch 数量上也有所不同。
Megatron 源码
parallel_state.py#L920-L930(专家网格,EP 位于 TP 之后)
920expert_order = _inject_gtp_remat_axis(order, after="ep")921expert_decoder_rank_generator = RankGenerator(922tp=expert_tensor_parallel_size,923ep=expert_model_parallel_size,924dp=expert_data_parallel_size,925pp=pipeline_model_parallel_size,926cp=1,927order=expert_order,928rank_offset=rank_offset,929gtp_remat=expert_gtp_remat_size,930)
parallel_state.py#L1419-L1428(连续的 rank 组成 EP)
1419for ranks in expert_decoder_rank_generator.get_ranks('ep'):1420group = create_group(1421ranks,1422timeout=timeout,1423pg_options=get_nccl_options("ep", nccl_comm_cfgs),1424group_desc="EXPERT_MODEL_PARALLEL_GROUP",1425)1426if rank in ranks:1427_EXPERT_MODEL_PARALLEL_GROUP = group1428_EXPERT_MODEL_PARALLEL_RANKS = ranks
回退到 socket 使我们的两节点运行慢了上述倍数,所以请先检查启动日志。使用 NCCL_DEBUG=INFO 时,NCCL 会打印“Using network”以及它选择的传输方式。你希望在那里看到的是你的网络结构的传输,例如 EFA 上的 OFI 插件对应的 Libfabric,而“Using network Socket”则意味着发生了回退。确认网络结构之后,请根据 nccl-tests(2.1)比较节点内和跨节点的 alltoall bus 带宽。然后分别在能放进一个节点的 EP 大小和跨两个节点的 EP 大小下,测量每块 GPU 的 TFLOP/s。
模型适合时,请在节点内使用专家并行:从那里开始,把增加的节点作为数据并行副本加入,并在确定之前,用你的节点数对两种放置方式都计时。
即使互联工作正常,穿过它的 token 在 GPU 等待期间仍然位于关键路径上。在 token 传输途中,GPU 能不能做些别的工作?
重叠
我们在 3.5 Block 连接中已经看到,改变架构如何在一个 micro-batch 内部隐藏 all-to-all。并行 block 可以在注意力计算的同时运行 dispatch,shortcut 连接的 MoE 还可以把 combine 藏在与它并行的稠密计算后面。然而,重新连接会改变路由器所看到的内容,而且你可能不想去动一个已经定下来的架构。不重新连接的话,暴露的 all-to-all 很难在一个 micro-batch 内部隐藏。不过,一个训练步会运行许多个 micro-batch,其中一个的工作在它们的梯度求和之前不必等待另一个。
Megatron 借用了这部分工作:--overlap-moe-expert-parallel-comm 让一个 micro-batch 的前向与另一个的反向并排运行,这样其中一个的 all-to-all 就藏在另一个的计算后面(model_parallel_config.py#L349-L352)。流水线调度也会把一个 micro-batch 的前向与另一个的反向配对,如 Ultra-Scale Playbook 所述,DeepSeek-V3 的 DualPipe 就利用这种配对来隐藏它的 all-to-all209。下图画出了一个 MoE 层在有和没有这种交错时的情形。

按一个 micro-batch 接着另一个来画时,该层的四次 all-to-all 全部暴露在外。交错的画法还设置了 --delay-wgrad-compute,Megatron 的 MoE 指南把它与该重叠搭配使用(README.md#L434)。该参数把权重梯度推迟到之后计算,这样反向的 dispatch 只需等待专家的输入梯度,并在该 micro-batch 自己被推迟的专家权重梯度之下运行(model_chunk_schedule_plan.py#L266-L268),而另外三次 all-to-all 则在另一个 micro-batch 的计算之下运行。在我们只设置了重叠参数的运行中,该重叠在两个节点上使吞吐最高提升了 35%。它也要消耗显存:rank 0 多保留了 5 到 10 GB,而它的峰值已分配显存几乎没动。
Megatron 源码
combined_1f1b.py#L54-L67(一个前向与一个反向并排)
54"""Scheduler for 1f1b with no pipelining.5556This function schedules micro-batches in a way that the forward pass of Transformer layers57for one micro-batch runs in parallel with the backward pass of another.58Each layer's forward and backward operations are co-scheduled to maximize the overlap of59their computations and communications.60EP A2A in forward step is hidden by the attention/mlp computation in the backward step,61and vice versa.62Assuming we have 4 microbatches, the schedule is as follows:63Phases 0: 1st microbatch forward64Phases 1: 1st microbatch backward + 2nd microbatch forward65Phases 2: 2nd microbatch backward + 3rd microbatch forward66Phases 3: 3rd microbatch backward + 4th microbatch forward67Phases 4: 4th microbatch backward
model_chunk_schedule_plan.py#L226-L294(dispatch 藏在 MLP 反向之后)
226def run(f_layer, b_layer, f_input=None, b_grad=None, is_last_layer_in_bwd=False):227"""Schedule one-forward-one-backward operations for a single transformer layer.228229This function interleaves forward and backward operations, overlapping the communications230(dispatch or combine) of one with the computations (pre_dispatch or mlp) of the other231to maximize parallelism and efficiency.232233When f_layer and b_layer are not None, forward and backward pass are overlapped as follows:234comm_stream: combine_bwd | dispatch_fwd->dispatch_bwd | combine_fwd235comp_stream: pre_dispatch_fwd | mlp_bwd->mlp_bwd_dw->mlp_fwd| pre_dispatch_bwd236For MTP, mtp_post_process_fwd is executed after the combine_fwd in the comp_stream,237and mtp_post_process_bwd is executed before the combine_bwd in the comp_stream.238239Args:240f_layer (TransformerLayerSchedulePlan): Forward layer (for current microbatch)241b_layer (TransformerLayerSchedulePlan): Backward layer (for previous microbatch)242f_input (Tensor): Input for forward computation243b_grad (Tensor): Gradient for backward computation244is_last_layer_in_bwd (bool):245Whether the current layer is the last layer in the backward pass.246247Returns:248Functions or values for next iteration's computation249"""250251if b_layer is not None:252b_grad = b_layer.mtp_post_process.backward(b_grad)253b_grad = b_layer.moe_combine.backward(b_grad)254255if f_layer is not None:256with f_layer.get_low_precision_context():257f_input = f_layer.pre_dispatch_computation.forward(f_input)258259if b_layer is not None:260b_grad = b_layer.mlp.backward(b_grad)261262if f_layer is not None:263with f_layer.get_low_precision_context():264f_input = f_layer.moe_dispatch.forward(f_input)265266if b_layer is not None:267b_layer.mlp.backward_dw()268b_grad = b_layer.moe_dispatch.backward(b_grad)269270if b_layer is not None and b_layer.config.ep_overlap_early_attn_memory_release:271b_grad = b_layer.pre_dispatch_computation.backward(b_grad)272273if f_layer is not None:274with f_layer.get_low_precision_context():275f_input = f_layer.mlp.forward(f_input)276277if f_layer is not None:278with f_layer.get_low_precision_context():279f_input = f_layer.moe_combine.forward(f_input)280281if b_layer is not None and not b_layer.config.ep_overlap_early_attn_memory_release:282b_grad = b_layer.pre_dispatch_computation.backward(b_grad)283284if f_layer is not None:285with f_layer.get_low_precision_context():... 9 more lines
请在打开重叠前后记录每块 GPU 的 TFLOP/s(--log-throughput),仅当单步变快时才保留它。然后看一份 trace,了解哪些 all-to-all 与计算重叠了。
当 all-to-all 暴露在外且显存允许时使用它:添加 --overlap-moe-expert-parallel-comm --delay-wgrad-compute(Megatron 的 MoE 指南推荐的这一对参数,README.md#L434),以取代 --moe-shared-expert-overlap。--delay-wgrad-compute 只有在打开重叠并使用 Transformer Engine 层时才能运行(transformer_config.py#L3631-L3635、arguments.py#L1956-L1958)。使用流水线并行时,该重叠还需要虚拟流水线 stage(transformer_config.py#L3565-L3599)。
重叠赢回了时间,却花掉了显存。怎样既让显存保持在可控范围内,又不把这些时间再还回去?
显存
MoE 在两个方面改变显存使用:权重和激活。它的权重包含每一个专家,尽管每个 token 只使用其中 k 个,而专家并行把这些专家分散开,使每块 GPU 只保留属于自己的那些。它的激活,即一层为反向传播保留的中间结果,随 top-k 增长。dispatcher 为每个被选中的专家复制一份 token 的隐藏状态(token_dispatcher.py#L559),每个副本都保留自己的专家激活,所以专家收到更多 token 的 GPU 也持有更多这样的激活。
通常的办法是激活重计算,它在前向传播之后丢弃激活,并在反向传播需要时重新生成。Ultra-Scale Playbook 介绍了它的两种经典形式:对每一层的完整重计算,以及对注意力的选择性重计算。完整重计算会把每一层的前向运行两遍,在 micro-batch 为 2 时使我们损失了 24% 的吞吐,而且 3.7 重叠中的重叠需要把它关闭(transformer_config.py#L3579-L3581)。
更精细的办法是从一层的每个模块为反向保存了什么出发。其中一些张量重建的代价很低,比如归一化以及专家激活函数的输出,只需几次逐元素运算。另一些则又大又贵:进入注意力的 query、key 和 value,以及进入专家第一次矩阵乘法的、被 dispatch 过来的 token,即每个 token 的 k 个副本。Megatron 对这两类采用不同的处理210,下一幅图标出了它的各个选项分别作用于哪个被保存的张量。

蓝色标签是重计算选项。Megatron 的指南对归一化和专家激活做重计算(--recompute-granularity selective --recompute-modules layernorm moe_act):丢弃它们廉价的输出,并在读取它们的反向开始之前重新生成(random.py#L1042-L1064)。带轮廓的标签属于细粒度激活 offload,指南 offload 注意力的输入和输出以及专家的第一个输入(--fine-grained-activation-offloading --offload-modules core_attn attn_proj expert_fc1)。
Offload 把这些大模块的输入,在后面的模块进行计算的同时,通过一个单独的 CUDA stream 拷贝到锁页(pinned)CPU 内存中(fine_grained_activation_offload.py#L1262-L1269)。每当反向完成一个被 offload 的模块,它就开始在第二个 stream 上把下一个模块的张量拷回来,使它们在被需要之前已经回到 GPU 上(#L1332-L1342)。重计算付出的是计算,而 offload 付出的是主机与 GPU 之间的带宽,这些拷贝被藏在计算后面。下图让三层依次经过一次前向和一次反向,分别在保留所有保存的输入、完整重计算和这种拆分下运行,并追踪每种设置在 GPU 上持有的保存输入。

只有三层、一个 micro-batch 和示意性的时长时,完整重计算达到最低的峰值,但多出了第二次前向,而细粒度拆分持有的更多,只增加了少量小的重计算,因为它的拷贝在计算之下运行。最后一层把它的大输入留在 GPU 上,因为它的反向在前向结束后立即开始,重新加载会使它停顿(fine_grained_activation_offload.py#L630-L637)。在模拟中放慢主机链路,拷到 CPU 的操作就会完成得更晚,所以峰值上升;再放慢,反向就要等它的重新加载了。
Megatron 源码
experts.py#L319-L322(moe_act 需要 selective)
319self.activation_recompute = (320self.config.recompute_granularity == 'selective'321and "moe_act" in self.config.recompute_modules322)
experts.py#L1130-L1141(激活被重新计算,输出被丢弃)
1130if self.activation_recompute:1131self.activation_checkpoint = tensor_parallel.CheckpointWithoutOutput()1132with moe_act_manager as fc1_output:1133bias_act_output = self.activation_checkpoint.checkpoint(1134bias_act_func, fc1_output, bias_parallel, permuted_probs1135)1136else:1137with moe_act_manager as fc1_output:1138bias_act_output = bias_act_func(fc1_output, bias_parallel, permuted_probs)1139output, output_bias = apply_module(self.linear_fc2)(bias_act_output, tokens_per_expert)1140if self.activation_recompute:1141self.activation_checkpoint.discard_output_and_register_recompute(output)
fine_grained_activation_offload.py#L1262-L1269(在模块前向之后于 D2H stream 上 offload)
1262def on_group_commit_forward(self, name, forced_released_tensors):1263"""Called at the end of a layer group's forward pass to trigger offloading."""1264if not self.do_offload:1265return1266debug_rank(f"--on_group_commit_forward {name}")1267# Wait for compute to finish before starting offload1268self.d2h_stream.wait_stream(torch.cuda.current_stream())1269self.bulk_offload(name, forced_released_tensors)
fine_grained_activation_offload.py#L1332-L1341(在一组反向开始时发出重新加载)
1332def on_group_start_backward(self):1333"""1334Called at the start of a layer group's backward pass.1335Triggers reloading of tensors from CPU.1336"""1337if not self.do_offload:1338return1339debug_rank(f"--on_group_start_backward {self}")1340# Wait for compute to finish before starting reload1341self.h2d_stream.wait_stream(torch.cuda.current_stream())
fine_grained_activation_offload.py#L630-L639(每个名称的最后一组留在 GPU 上)
630# Mark the last group with the same name as not offloadable to make sure631# the reloading won't block the main stream.632for name, group in last_group_with_same_name.items():633if self._offload_margin > 0:634group.offload = False635self._offload_margin -= 1636debug_rank(f"setting offload to false for group {name} at chunk index {chunk_idx}")637else:638break639assert self._offload_margin == 0, "Offload margin is not 0"
transformer_config.py#L2601-L2660(offload 校验:attn_proj 需要 core_attn,被重计算的 moe 内部不能 offload,不能与 cpu_offloading 一起使用)
2601if self.fine_grained_activation_offloading:2602assert (2603not self.cpu_offloading2604), "fine_grained_activation_offloading cannot be enabled with cpu_offloading."2605assert self.offload_modules is not None and len(self.offload_modules) > 02606allowed_modules = {2607"core_attn",2608"attn_proj",2609"expert_fc1",2610"fused_group_mlp",2611"moe_act",2612"attn_norm",2613"mlp_norm",2614"qkv_linear",2615"gdp_qkv",2616"shortcut_post_norm",2617}2618invalid_modules = set(self.offload_modules) - allowed_modules2619assert not invalid_modules, (2620f'Invalid choices for offload_modules: {invalid_modules}. '2621f'Allowed modules are: {allowed_modules}'2622)2623if "attn_proj" in self.offload_modules and "core_attn" not in self.offload_modules:2624raise ValueError(2625"attn_proj cannot be set to offload_modules alone without core_attn "2626"because the input of attn_proj is the output of core_attn, "2627"which is needed in core_attn.backward()."2628)2629if (2630"gdp_qkv" in self.offload_modules2631and self.recompute_granularity == "selective"2632and "gdp_in_proj" in self.recompute_modules2633):2634raise ValueError(2635"gdp_qkv cannot be set in offload_modules together with gdp_in_proj in "2636"recompute_modules, because gdp_in_proj discards the input of the causal "2637"conv and rematerializes it at the start of the mixer backward, leaving "2638"nothing for the gdp_qkv offload group to keep on the host."2639)2640if self.recompute_granularity == "selective" and "moe" in self.recompute_modules:2641offload_inside_moe = {"moe_act", "expert_fc1", "fused_group_mlp"} & set(2642self.offload_modules2643)2644assert not offload_inside_moe, (2645f"Cannot offload {offload_inside_moe} while recomputing the entire MoE layer. "2646f"'moe' in recompute_modules wraps the full MoE forward in a checkpoint, "2647f"so offloading activations inside it is redundant and will cause errors. "2648f"Either remove 'moe' from --recompute-modules or remove "2649f"{offload_inside_moe} from --offload-modules."2650)2651assert (2652self.min_offloaded_tensor_size >= 02653), "min_offloaded_tensor_size must be non-negative."2654assert (2655self.activation_offload_fraction >= 0 and self.activation_offload_fraction <= 12656), "activation_offload_fraction must be in range [0, 1]."2657assert (2658self.delta_offload_bytes_across_pp_ranks >= 02659), "delta_offload_bytes_across_pp_ranks must be non-negative."2660
experts.py#L860-L876(分页暂存,仅限融合路径)
860if self.config.moe_paged_stash:861permuted_local_hidden_states = paged_stash_group_start(permuted_local_hidden_states)862max_num_tokens = permuted_local_hidden_states.shape[0]863# Average/expected tokens is a pre-padding estimate used by paged stashing heuristics.864# moe_expert_rank_capacity_factor is required when moe_paged_stash is enabled.865cap_factor = self.config.moe_expert_rank_capacity_factor866avg_num_tokens = (867int(max_num_tokens // cap_factor)868if cap_factor is not None and cap_factor > 0869else None870)871stash_context = get_paged_stash_context(872name="grouped_mlp",873max_num_tokens=max_num_tokens,874num_tokens_tensor=tokens_per_expert.sum(),875avg_num_tokens=avg_num_tokens,876)
NVIDIA 在加入这项功能时测量了这一取舍。在 H100 上,对一个采用 DeepSeek-V3 层形状的 14 层模型,offload 它的归一化输入和两个专家输入,峰值保留显存减少 18%,吞吐损失 2%211。
只有当拷贝保持被隐藏时,offload 才能节省显存,三项设置决定它搬运多少。--activation-offload-fraction 只按前向顺序 offload 符合条件的组中的前一部分,--min-offloaded-tensor-size 跳过小张量,默认是不足一百万个元素的张量。较后的流水线 stage 同时在途的 micro-batch 更少,需要的显存也更少,所以 --delta-offload-bytes-across-pp-ranks 让每个 stage 比前一个 offload 得更少。
重计算和 offload 缩小了每一层保留的激活。一层预留的显存也可能远多于其激活所需,而一旦你把这一步捕获进 CUDA graph 就会这样:CUDA graph 在没有 CPU 的情况下重放录制好的 kernel 序列,因此需要预先固定每个 buffer 的大小。在 dropless MoE 中,一个 rank 收到的 token 数每步都在变,所以每层必须按你允许的最大负载来预留专家 buffer:使用 --moe-expert-rank-capacity-factor 以及 HybridEP 或 NCCL EP 后端时,就是该因子乘以完美均衡负载。每一层在其反向运行之前都占着它的预留,然而 NVIDIA 的 Megatron Core MoE 报告指出,一层实际为反向保留的激活往往小十倍以上212。
Megatron 的实验性分页暂存(paged stash)--moe-paged-stash 把一层进行计算的空间与存储的空间分开。所有层在一个预留大小的共享 buffer 中计算,每层前向之后,一个单独的 stream 只把它的真实 token 拷贝到固定大小的小页中,很像 offload 把张量拷贝到 CPU。它需要 --use-transformer-engine-op-fuser 以及 FP8 或 NVFP4 专家,而且由于它已经保存了专家激活,Megatron 拒绝把它与 offload expert_fc1 或 moe_act 组合使用212。
请在每次改动前后比较峰值显存和单步耗时,因为显存不足的训练会在其最忙的 rank 上以显存溢出错误失败,而超过计算时间的 offload 拷贝会表现为更长的反向。因此要关注的峰值显存是最忙 rank 的。Megatron 打印数据并行 rank 0 的峰值(common_utils.py#L407-L427),并通过 2.4 中的启动器把最后一个 rank 的峰值发送到 Trackio。要找到最忙的 rank,请在每个日志间隔对各 rank 的 torch.cuda.max_memory_allocated() 取最大值,或者记录每个 rank 的 --record-memory-history 快照。
当重叠放不进显存时使用它:对廉价模块做重计算(--recompute-granularity selective --recompute-modules layernorm moe_act),并 offload 大的输入(--fine-grained-activation-offloading --offload-modules core_attn attn_proj expert_fc1),而不是对每一层都做重计算(那会阻止重叠)。如果单步耗时增加,请调低 --activation-offload-fraction。对 layernorm 或 moe_act 做重计算不能与 FP8 的 delayed recipe 一起运行(transformer_config.py#L2422-L2433),使用 ncclep 后端时,该重叠也不能与 expert_fc1 offload 一起运行(#L3606-L3618)。
到目前为止,你是围绕路由器的选择来调节系统,而没有去动它们。如果路由器把网络也考虑进去,并在训练中为此付出代价,会怎么样?
分组受限路由
一个 token 的 top-k 专家可能位于专家并行组中的任何位置。一旦该组跨越多个节点,一个 token 可能需要许多个节点上的专家,它的副本无论是在 token 被 dispatch 时,还是在输出被 combine 时,都要穿过节点之间较慢的网络。普通的 top-k 路由不关心专家位于何处,所以没有任何机制让一个 token 的专家集中在少数节点上。
DeepSeek-V3 用分组受限路由(group-limited routing)加上了缺失的约束,它限制 token 在挑选之前可以看哪些地方,目的是“limit communication costs during training”。它的专家分布在 8 个节点上,对每个 token,它把该节点上 token 的前 2 个专家得分求和作为该节点的分数(其中包括 3.3 的均衡偏置)。它保留最好的 4 个节点,然后在它们上面的专家中取 top-k,所以一个 token 至多到达 4 个节点42。下图在设备而不是节点的层面,把同样的规则与标准 top-k 和 MoGE 并排画出。MoGE(Mixture of Grouped Experts)是华为 Pangu Pro MoE 背后的路由方式,它把专家按每个设备一个等大的组来划分,并从每个组中取相同数量的专家213。在 8 块 GPU 上使用专家并行训练的 Intern-S1-Pro,以同样的方式从 8 个组中各取一个专家214。

逐设备比较,分组受限路由限制了每个 token 到达的设备数,而 MoGE 使每个设备的负载均匀,并把每个 token 送往所有设备。
Megatron 源码
moe_utils.py#L713-L718(对组排序,保留最好的几组)
713group_scores = (714scores.view(num_tokens, num_groups, -1).topk(topk // group_topk, dim=-1)[0].sum(dim=-1)715)716group_idx = torch.topk(group_scores, k=group_topk, dim=-1, sorted=False)[1]717group_mask = torch.zeros_like(group_scores)718group_mask.scatter_(1, group_idx, 1)
moe_utils.py#L721-L728(在保留的组内取 top-k)
721score_mask = (722group_mask.unsqueeze(-1)723.expand(num_tokens, num_groups, num_experts // num_groups)724.reshape(num_tokens, -1)725)726727masked_scores = scores.masked_fill(~score_mask.bool(), float('-inf'))728probs, top_indices = torch.topk(masked_scores, k=topk, dim=-1)
这个上限能节省多少流量,取决于 dispatcher。Megatron 的 alltoall dispatcher 为每个专家发送一份 token 副本,而带 DeepEP 的 flex dispatcher(其 kernel 遵循 DeepSeek-V3 的分组受限路由)为每个节点发送一份副本,并在节点内通过 NVLink 转发215,216。对于我们 7B-A1B 模型的一层(64 个专家、top-8,bf16 的 2,048 宽隐藏状态,分布在 2 到 8 个节点上),下面的图统计了在两种 dispatcher 下,有无该上限时穿过网络的数据量。

使用 alltoall 时,该上限只是把一个 token 的副本挪到更少的节点上,因为每个位于 token 自身节点之外的被选专家仍然得到各自的副本;图中的路由器对专家随机打分,不考虑 token 所在的节点,因此平均而言,穿过网络的字节数与没有上限时一样多。使用 DeepEP 时,一个 token 到达的每个节点只花一份副本,所以限制节点数就限制了字节数。到达更少的节点也让每个 token 可选的专家变少,这是一种用质量而不是时间来付的代价,但代价很小:Xue 等人用分组限制训练一个 13B 模型时,其 loss 只略高一点217。
近期的 MoE 倾向于去掉这个上限。DeepSeek 的 V3 用了它,DeepSeek-V4 却去掉了27,GLM、Kimi、Nemotron、MiMo 和 Hy4 也让每个 token 可以到达任意专家。InclusionAI 的 Ling 和 Ring 模型仍然以与 DeepSeek-V3 相同的形式保留它,分成 8 组,每个 token 保留其中 4 组,SK Telecom 的 A.X-K2 则保留了它的一个更宽松的版本。
当 token 向许多节点扇出时,训练步会变慢,所以请关注两个数字。第一个是每个 token 到达的节点数,根据路由 trace 以及哪个 rank 持有哪个专家的映射离线计算(A.1)。第二个是每个 EP rank 收到的 token 数,由 --save-tokens-per-expert-interval 写出的 token 计数求和得到(A.1)。
请先尝试上面的建议,因为它们不改变训练;只有当跨节点的 all-to-all 仍然占了单步的很大比例时,才求助于这个上限:该上限改变 token 能选哪些专家,也就改变了模型所学的内容。它只在专家并行跨越多个节点、且 dispatcher 对每个节点只发送一次 token 时才有帮助,比如带 DeepEP 的 flex dispatcher。然后把 --moe-router-num-groups 设为节点数,把 --moe-router-group-topk 设为一个 token 可以到达其中多少个,并搭配 quantile_balancing 以外的均衡器,因为它无法与该上限一起运行。否则请保持关闭:在单节点上它不节省任何流量,而使用 alltoall 时平均也节省不了。
节点上限限制的是 token 副本去哪里,但路由器偏爱的专家仍然会接收发给它的每一个 token,持有它的 rank 最后完成。你应该把该专家多出来的 token 拒之门外,还是把这个专家复制到更空闲的 rank 上?每种选择的代价又是什么?
容量与副本
持有热门专家的 rank 最后完成它那一份工作,其他 rank 在下一个同步点等待它208。默认情况下,Megatron 接受这种等待并保留每个 token:未设置 --moe-expert-capacity-factor 时,路由是 dropless 的(transformer_config.py#L1009-L1011),一个专家接收路由器发给它的任意多个 token。
容量因子(capacity factor)给这个数量设上限。每个专家保留概率最高的 token,直到其容量(transformer_config.py#L1024-L1028),超出的 token 跳过该专家。这换来一定的速度,因为没有专家能因 token 数超过其容量而拖住整个训练步218,它也限制了显存,因为没有专家会为超过其容量的 token 保存激活219。对于静态形状,请同时添加 --moe-pad-expert-input-to-capacity。
容量因子释放出的显存,也能换来更好的并行布局。NVIDIA 的 Vavre 等人把 Llama 3-8B upcycle 成一个 8 专家、top-2 路由的 MoE,在 128 块 GPU 上,容量因子为 1 的训练无需张量并行,每块 GPU 达到 463 TFLOP/s,而张量并行大小为 2 的 dropless 训练是 392。作者把这一增益归因于更小的显存占用,使他们能使用更少的模型并行220。
另一种回答是保留每个 token,转而复制热门专家。下图展示了处理热门专家的三种方式:dropless 路由、容量因子,以及按 ECHO 的放置方式放置的热门专家副本,ECHO 是 Megatron Core 团队报告中的一种方法,在训练期间复制热门专家208。

在一个偏斜的玩具 batch 上(8 个专家分布在 4 个 rank 上),容量因子丢弃了在某个专家上溢出的选择(主要是热门专家的),并且按到达顺序丢弃,而 Megatron 的默认做法是保留概率最高的那些。每个被丢弃的选择都跳过它的专家,所以图中的这一步变短了,模型的输出也随之改变。放在最空闲 rank 上的副本,在不丢弃任何东西的情况下,使玩具中最忙的 rank 更接近平均值。
Megatron 源码
router.py#L1029-L1038(在 top-k 之后丢弃)
1029# Apply token dropping to probs and routing_map.1030if self.config.moe_expert_capacity_factor is not None:1031probs, routing_map = apply_router_token_dropping(1032probs,1033routing_map,1034router_topk=self.topk,1035capacity_factor=self.config.moe_expert_capacity_factor,1036drop_policy=self.config.moe_token_drop_policy,1037pad_to_capacity=self.config.moe_pad_expert_input_to_capacity,1038)
moe_utils.py#L1079-L1112(每个专家的容量,保留概率最高的)
1079# Calculate expert capacity1080expert_capacity = get_capacity(1081num_tokens=num_tokens * router_topk,1082num_experts=num_experts,1083capacity_factor=capacity_factor,1084)10851086# Create capacity mask based on drop policy1087if expert_capacity > num_tokens:1088# No need to drop tokens if capacity exceeds the number of tokens1089capacity_mask = torch.ones_like(routing_probs).bool()1090else:1091if drop_policy == "probs":1092_, capacity_indices = torch.topk(routing_probs, k=expert_capacity, dim=0, sorted=False)1093capacity_mask = torch.zeros_like(routing_probs).scatter(0, capacity_indices, 1).bool()1094elif drop_policy == "position":1095_, capacity_indices = torch.topk(1096routing_map.int(), k=expert_capacity, dim=0, sorted=False1097)1098capacity_mask = torch.zeros_like(routing_probs).scatter(0, capacity_indices, 1).bool()1099else:1100raise ValueError(f"Invalid drop_policy: {drop_policy}")11011102# Apply capacity constraints1103if pad_to_capacity:1104final_map = capacity_mask1105final_probs = routing_probs * final_map1106else:1107# Get exceed mask and maskout exceeded probs and indices1108final_map = torch.logical_and(routing_map, capacity_mask)1109final_probs = routing_probs * final_map11101111return final_probs, final_map1112
真实训练丢弃得比玩具示例少:在 1.5 的容量因子下,华为 Pangu 团队在一个 20B MoE 中看到约 6% 的 token 被丢弃,在他们的 718B 模型中约为 8%218。副本几乎可以精确地均衡各 rank。Wei 等人的 UltraEP 为每个 micro-batch 和每一层重新规划副本,它把三次训练(DeepSeek-V3、Qwen3-235B 和 GLM-4.5-Air)中最忙的 rank,从普通 Megatron-LM 中平均负载的 1.30 到 2.86 倍,降到了 1.01 到 1.03 倍221。
副本在训练中比在推理服务中花费更多。每个副本都需要在前向传播中把专家的权重发送到它的 rank,并在反向传播中把它的梯度 reduce 回原件,所以 ECHO 的规划器尽可能少做副本:它统计每个专家超过每个 rank 平均负载的 token 数,找出较空闲的 rank 上的富余空间,把前者装进后者,并在副本计算完之后丢弃它们。均衡的 rank 回报是双重的:更少的等待和更小的 buffer,因为 CUDA graph 按最坏情况给静态 buffer 定大小,也就是 3.7 显存中分页暂存要绕开的那种最坏情况 buffer222。
推理服务面临同样的问题,只是没有梯度,所以它的副本保持在原处的时间远比 ECHO 的长,后者在每次前向传播中都要重新规划。DeepSeek-V3 根据其在线服务的负载,大约每 10 分钟重新选择一次冗余专家223。DeepInfer 是 DeepSeek 服务 V4.1-Flash 所用的引擎,它给每块 GPU 留出放置最忙专家副本的空闲槽位,统计每个专家在最近窗口内的负载,并在 prefill 中每 1,000 步、在 decode 中每 10,000 步重新放置副本,借此最慢的 GPU 保持在平均值的 1.09 倍之内,如 3.3 中所引用的那样71。
丢弃会损失质量吗?已发表的对比说,会损失一些 loss。华为 Pangu 团队用 1.5 的容量因子和 dropless 各训练了一个 20B MoE,dropless 的训练全程保持着更低的 loss,差距随专家数量增长而增大218。Gale 等人在构建 MegaBlocks 时发现了同样的结果:没有 token 被丢弃时 loss 最低224。
下游基准可能掩盖这一差距:Vavre 等人 upcycle 的 Llama 3 MoE,在他们尝试的每个容量因子下,以及在 dropless 路由下,MMLU 得分都相差在一分之内225。被丢弃的 token 落在哪里也很重要。Meta 的 MobileMoE 在预训练时使用容量因子,微调时则改用 dropless 路由,因为在微调中丢弃会把 token 从指令-回答对中切掉226。
用容量上限训练出来的模型,不必也用容量上限来服务。Zoph 等人在比训练时更高的容量因子下评估他们的 ST-MoE 模型时,对比中的每个模型得分都更好227。DeepSeek-V2 就是为这种切换而设计的:它在训练期间对每个设备丢弃 token,但约 10% 的训练序列从不丢弃,这样推理时它可以选择是否丢弃 token,而仍与训练方式相符228。
开启容量因子时,token 是被悄悄丢弃的,所以请在验证 loss 之外,同时关注丢弃的频率。--moe-routing-trace-path 写出的路由 trace 会跳过每条有 token 被丢弃的记录(router_trace.py#L353-L360)。要统计丢弃,请用路由器上的一个前向 hook 计算每层被丢弃的 token-专家分配所占的比例:1 - kept / (tokens * topk),其中 kept 统计路由映射中剩下的分配数。
默认保持 dropless。当某个热门专家拖住了整个训练步,而较空闲的 rank 有富余显存时,该专家的副本可以在不触及 loss 的情况下均衡各 rank,尽管 ECHO 的复制目前仍是一个未合并的 pull request208。显存紧张且你能接受 loss 略高时,使用容量因子;静态形状还需要 --moe-pad-expert-input-to-capacity。微调时请回到 dropless,因为被丢弃的 token 会落在指令-回答对里面。
无论丢弃 token 还是全部保留,专家保留的每个 token 都要经过它的 GEMM,而这些 GEMM 迄今都在 bf16 下运行。像 FP8 这样更低的精度,能否在不损害 loss 的前提下,让这些工作更便宜,并让它所保存的激活更小?
精度
MoE 层的大部分计算位于它的矩阵乘法中,而大部分激活显存位于这些乘法为反向传播所保存的输入中。相较 bf16,FP8 使这两者的字节数都减半,并且它的 Tensor Core 运算在 Hopper 和 Blackwell GPU 上运行得更快229。其中有多少体现在单步上,取决于乘法占单步的比例,以及对其张量做量化的代价;对于大型 MoE 训练,Megatron Core 团队报告端到端约有 10% 到 25% 的提升229。
并非每个运算都能采用更低的精度。下图展示了 FP8 在一层中的前向和反向分别运行于何处,遵循 DeepSeek-V3 训练时的划分:每个线性层的前向乘法及其两个反向乘法都以 FP8 运行,而 embedding、输出头、norm、注意力核心和路由器保持 BF16 或 FP32230。

显存的节省来自反向传播。权重梯度乘法读取前向传播保存的输入,所以把该输入保持在 FP8 就能使它减半,对 DeepSeek-V3 来说,每块 GPU 的激活大约节省 16 GB231。主权重、权重梯度和优化器状态保持更高的精度230。
路由器是需要保护的部分。它的分数决定每个 token 的专家,所以那里的量化噪声可能改变选择并使训练不稳定,这就是 Megatron Core 报告把它保持在 FP32 的原因232。在 Megatron 中,路由器不是 Transformer Engine 层,所以 FP8 永远不会作用到它,--moe-router-dtype fp32 设置它的运算精度(router.py#L125-L130、3.1 精度)。量化的 grouped GEMM 需要把每个专家的 token 数补齐到对齐的大小,--moe-router-padding-for-quantization 就提供了这一点(transformer_config.py#L851-L854)。
Megatron 源码
fp8_utils.py#L779-L829(格式与配方交给 TE)
779if config.fp8 == "e4m3":780fp8_format = transformer_engine.common.recipe.Format.E4M3781elif config.fp8 == "hybrid":782fp8_format = transformer_engine.common.recipe.Format.HYBRID783else:784raise ValueError("E4M3 and HYBRID are the only supported FP8 formats.")785786# Select fp8 recipe (TE version >= 2.1.0).787fp8_recipe = None788if is_te_min_version("2.1.0"):789if config.fp8_recipe == Fp8Recipe.delayed:790fp8_recipe = TEDelayedScaling(791config=config,792fp8_format=fp8_format,793override_linear_precision=(False, False, not config.fp8_wgrad),794)795elif config.fp8_recipe == Fp8Recipe.tensorwise and is_te_min_version("2.2.0.dev0"):796fp8_recipe = transformer_engine.common.recipe.Float8CurrentScaling(797fp8_format=fp8_format, fp8_dpa=config.fp8_dot_product_attention798)799elif config.fp8_recipe == Fp8Recipe.blockwise and is_te_min_version("2.3.0.dev0"):800fp8_recipe = transformer_engine.common.recipe.Float8BlockScaling(801fp8_format=fp8_format802)803elif config.fp8_recipe == Fp8Recipe.mxfp8:804fp8_recipe = transformer_engine.common.recipe.MXFP8BlockScaling(805fp8_format=fp8_format, fp8_dpa=config.fp8_dot_product_attention806)807elif config.fp8_recipe == Fp8Recipe.custom:808assert config.fp8_quantizer_factory is not None809fp8_recipe = _get_custom_recipe(config.fp8_quantizer_factory)810else:811raise ValueError(812"Float8CurrentScaling, MXFP8BlockScaling, Float8BlockwiseScaling and "813"DelayedScaling are the only supported FP8 recipes. Please also make sure "814"you are using a compatible TE version."815)816else:817# Assert that the user is using delayed scaling.818assert config.fp8_recipe == Fp8Recipe.delayed, (819"Please make sure to use TransformerEngine version >= 2.2.0.dev0 for "820"Float8CurrentScaling, >= 2.1.0 for MXFP8BlockScaling, and >= 2.3.0.dev0 for "821"Float8BlockScaling."822)823fp8_recipe = TEDelayedScaling(824config=config,825fp8_format=fp8_format,826override_linear_precision=(False, False, not config.fp8_wgrad),827)828return fp8_recipe829
token_dispatcher.py#L652-L657(为量化补齐路由)
652if self.config.moe_router_padding_for_quantization:653pad_multiple = get_align_size_for_quantization(self.config)654if is_experimental_enabled() and self.config.moe_permute_fusion:655self.routing_map = fused_pad_routing_map(self.routing_map, pad_multiple)656else:657self.routing_map = pad_routing_map(self.routing_map, pad_multiple)
配方(recipe)决定缩放比例跟随数据的精细程度。每个张量只用一个缩放时,最大的离群值决定了其他所有值的范围,所以 DeepSeek-V3 和 Ling 2.0 对激活和梯度按 1×128 个元素的 tile 缩放,对权重按 128×128 的 block 缩放233,234。Megatron Core 报告建议在 Hopper 上使用这种分块配方,在 Blackwell 上使用 MXFP8(每 32 个元素一个缩放)235。你用 --fp8-format 和 --fp8-recipe 选择它们,分块配方需要 Transformer Engine 2.3 或更新版本(fp8_utils.py#L799)。
FP8 也可以穿越网络。DeepSeek-V3 在 dispatch 之前把 token 量化为 FP8,因为专家的第一层本来就是以 FP8 读取它们的;“a similar strategy is applied to the activation gradient before MoE down-projections”,而“both the forward and backward combine components”则保持 BF16236。在 Megatron 中,--moe-dispatch-fwd-dtype mxfp8 和 --moe-combine-bwd-dtype mxfp8 以 MXFP8 发送 dispatch 的负载以及通过 combine 返回的梯度。两者都需要 flex dispatcher 的 ncclep 后端(transformer_config.py#L2150-L2158),而 MXFP8 本身需要 Blackwell 级别的 GPU(#L656-L661)。
长时间训练的报告显示 loss 保持住了。DeepSeek 用 FP8 分别把一个 16B 和一个 230B 的 MoE 训练了约一万亿 token,两者与其 BF16 基线的相对误差都在 0.25% 以内237。Ling-1T 在 900B token 内保持在同一界限之内,平均约 0.1%,而 FP8 使它的 MFU 提高了约 15%234。
四比特是再往下的一步,第一批大型 MoE 已经在这个精度上完成了预训练。NVIDIA 用 NVFP4一种 4 位浮点格式,每 16 个元素的 block 一个 FP8 缩放,外加第二个按张量的 FP32 缩放。在 25T token 上训练了 Nemotron 3 Super(120B 参数、12B 激活),其大多数线性层的三个乘法都以它运行。例外之处显示了 4 位在哪里不够用:网络最后 15%、注意力投影、embedding 和多 token 预测层保持 BF16,Mamba 输出投影以 MXFP8 运行,因为它在 NVFP4 下出现了下溢。该配方还对权重按二维 block 缩放,使前向和反向看到相同的量化权重,对权重梯度乘法的输入施加随机 Hadamard 变换,并对梯度做随机舍入238。Nemotron 3 Ultra(550B、55B 激活)随后以相同配方在 20T token 上训练,当 NVIDIA 从其检查点分叉出 BF16 运行时,与它们的 loss 差距平均保持在 0.4% 以下239。
FP4 把保存的输入缩小到 BF16 大小的四分之一,而 FP8 是二分之一231,原生的 FP4 乘法需要 Blackwell 级别的 GPU240。Hopper 没有 4 位 Tensor Core 指令,然而浙江实验室的 Zhang 等人以软件模拟的 MXFP4 存储了一个 671B MoE 的激活和前向 dispatch 流量,同时其乘法仍然使用 FP8,使峰值激活显存降低了 14.8%,并与强 FP8 基线的收敛一致。它释放出的显存使训练可以少做一些重计算,比能放得下的最佳 FP8 设置快了 12.5%241。
FP8 训练的 loss 应该在整个训练过程中保持接近 BF16,所以请把它与相同配置的 BF16 训练做比较,看相对差异。DeepSeek 的 16B 和 230B 训练以及 Ling-1T 都保持在 0.25% 以下,所以远超这个值的差距,或者持续扩大的差距,都指向配方有问题。使用 NVFP4 时,还要统计专家层中恰好为零的权重梯度元素。在 Nemotron 3 Super 中,到预训练结束时,它们增长到所有参数的 7%,因为某些专家中范数较低的通道缩小趋近于零,而在 Nemotron 3 Nano 上的一个较小规模的消融中,切换回 BF16 使该计数回到了它的基线242。
当线性层占了单步的大部分时间时使用 FP8:在 Hopper 上用分块配方,在 Blackwell 上用 MXFP8,并让路由器、norm 和注意力核心保持更高精度。在大型 MoE 上,预期吞吐提高约 10% 到 25%,loss 与 BF16 相差不到百分之几。在 Blackwell 上,NVFP4 是再往下的一步,Nemotron 3 的配方让最后几层、注意力投影和 embedding 保持 BF16。
该看什么
| 部分 | 症状 | 需要关注的信号 |
|---|---|---|
| Profiling | slow:单步耗时比应有的更长。 | 先看单步耗时或 TFLOP/s。然后根据 trace 看 all-to-all 有多少暴露在外。 |
| 互联 | 多节点上 slow:NCCL 回退到 TCP socket 时,我们的 EP16 代理运行慢了约 25 倍,1.7 对 42.0 TFLOP/s。 | 使用 NCCL_DEBUG=INFO,检查“Using network”是否为预期的传输:InfiniBand 对应 IB,EFA 上的 OFI 插件对应 Libfabric;Socket 表示发生了回退。然后比较 nccl-tests 在节点内和跨节点的 alltoall bus 带宽(2.1),以及节点内与跨节点 EP 下的 TFLOP/s。 |
| 重叠 | slow:all-to-all 没有被隐藏在计算后面。 | 前后的每块 GPU TFLOP/s(--log-throughput)。暴露的 all-to-all 占比只用来解释变化。 |
| 显存 | OOM:某个 rank 显存耗尽。slow:重计算,或超过计算时间的 offload 重新加载,增加了单步耗时。 | 每次改动之后比较单步耗时和峰值显存。使用最忙 rank 的峰值:各 rank 的 torch.cuda.max_memory_allocated() 最大值,或每个 rank 的 --record-memory-history 快照。更长的反向可能暴露了超过计算时间的 offload 重新加载。 |
| 分组受限路由 | slow:每个 token 向多个节点扇出。 | 每个 token 到达多少个节点(路由 trace 和专家到 rank 的映射),以及每个 EP rank 收到的 token 数(token 计数),A.1。 |
| 容量与副本 | learns badly:token 被悄悄丢弃。OOM:某个 rank 显存耗尽。 | 每层被丢弃的 token-专家分配所占比例,1 - kept / (tokens * topk),来自路由器前向 hook,并与验证 loss 一起看。路由 trace 会跳过有丢弃的记录。 |
| 精度 | slow:相对 bf16 没有加速。learns badly:loss 高于 bf16。 | 整个训练过程中相对于相同配置的 BF16 训练的 loss 相对差异;DeepSeek 的 16B 和 230B 训练以及 Ling-1T 都保持在 0.25% 以下237,234。使用 NVFP4 时,还要统计恰好为零的专家权重梯度元素:它们在 Nemotron 3 Super 中达到了所有参数的 7%242。 |
现在你已经拥有 MoE 层的每个部分,从挑选专家的路由器到它们计算所用的精度。训练结束后,这些选择中哪些在模型被部署服务时仍然重要?
4. 从训练到推理服务
模型只训练一次,却在有人使用的整个期间一直被用来提供服务。到目前为止,本手册讲的都是前一部分:让 MoE 又快又好地训练。本章讲后一部分。
推理服务用不同的数字来评判模型。训练用单步耗时和 loss 来衡量;推理服务系统则用每个请求多快得到答案、以及要用多少块 GPU 才能回答所有请求来衡量。两种情形下模型相同,但目标不同,所以一些对训练正确的选择,在训练结束后值得重新审视。
MoE 比稠密模型有更多需要重新审视的地方。每个 token 只经过少数几个专家,但为防万一有 token 选中,每个专家通常都要保留在显存里,所以模型的每 token 计算很便宜,显存却很昂贵。一旦请求逐 token 解码,每个专家每一步也只看到少数几个 token,这使得专家分散在多少块 GPU 上成为一个独立的服务决策。在迄今采用的布局中共享每块 GPU 的注意力和专家,对硬件的要求也不一样。
本章逐一讨论这些差异。我们从 k 开始,即路由器为一个 token 挑选的专家集合的大小。接着,我们看专家占多少显存、把它们分散到多少块 GPU 上,以及注意力和专家应该在哪里运行。最后讲 RL 后训练:推理服务引擎写出样本,训练器从中学习,而两者可能对每个 token 经过了哪些专家意见不一。
这些变化中的第一个,是你在服务时设置的一个数字。如果你用与训练时不同数量的专家来服务每个 token,它的输出会怎样?
使用不同的 k 进行服务
训练固定了每个 token 使用多少专家,但没有什么能阻止你用更少的专家来服务。从一个 token 的 top k 中每丢掉一个路由专家,就节省一份计算,而每个专家仍为选中它的 token 驻留,所以显存不变243。难点在于路由权重。做重新归一化的路由器(3.1)把被选专家的概率除以它们的总和,所以专家分支输出的尺度,即它的增益,是为训练时的 k 设定的。当你用更少的专家服务时,留下来的专家要分享同样的总和,每个得到的权重都比训练的 k 下更大。因此,较小的 k 同时改变了两件事:哪些专家运行,以及每个专家贡献多少。
Chen 和 Yao 用一个整数把这两种效应分开。他们保留 top k1 个专家,但用 top k2 的 softmax 质量去除它们的权重,在服务时选择,无需训练。取 k2 = k1 就是对留存者做通常的重新归一化,LExI(一种为每一层选取不同 k 的方法)也使用它244;设为专家总数则取消重新归一化;设为训练时的 k 则把增益锚定在模型训练时的值。
下图让一个模拟的 token 经过一个形状类似 Qwen3.6-35B-A3B 路由器的 softmax(256 个路由专家,按 top-8 训练),并以更小的 k 来服务,每个分母对应一行。请跟着中间的面板看 k 下降的过程:除以留存者时,每个被服务的专家分量比 top-8 时更重;除以训练时的 top 8 时,它保持训练时的权重;除以 top 16 时,它分量更轻。右侧面板给出每一行实测的 MMLU 变化。

该路由器很平坦,它的 top 8 专家在 WikiText 上平均只占 0.182 的 softmax 质量245,所以分母使增益移动了很远。与训练时 top-8 的 81.65% MMLU 相比,除以四个留存者做重新归一化的 top-4 得分低 4.65 分,除以 top-8 质量时低 3.10。除以 top-16 质量时,它低 0.35 分,这一降幅不显著(p = 0.66)。完全不做重新归一化时,top-6 损失 27.45 分246。作为回报,top-4 把每个 token 激活的路由参数减半,从 1.006B 到 0.503B,相当于每个 token 所用全部参数的 17%243。
分母有多重要,取决于路由器有多平坦。在 Gemma-4-26B-A4B 上,它 128 个专家中的 top 8 占 0.302 的质量,top-6 时取消重新归一化使困惑度上升了 0.7%,而在 Qwen 模型上是 356%。这两个结果都来自 softmax 路由器247。
用比训练时更多的专家来服务会使每个 token 的计算量更高,质量却未必跟着提升。在 Gu 等人对 OLMoE-1B-7B(按 top-8 训练)的微调实验中,用 top-16 服务使九个基准的平均值从 41.35 变到 41.09,落在他们报告的误差范围之内。额外的专家形成了模型从未一起训练过的组合,所以在他们的实验中,仅在服务时增大 k 没有帮助248。
Megatron 按 --moe-router-topk 所说的服务,权重遵循你所训练的路由器。默认情况下,softmax 路由器对 top-k 的 logits 取 softmax,所以更小的 k 会对留存者做重新归一化,即 Chen 和 Yao 的 k2 = k1。使用 --moe-router-pre-softmax 时,权重来自完整的 softmax,且不会重新归一化。sigmoid 路由器在 k 大于 1 时除以它的 top-k 之和,而任何路由器若设置了 --moe-router-topk-scaling-factor,都会乘以它。在 transformers 的 Qwen3-MoE 中,服务所用的 k 是 num_experts_per_tok,仅当设置了 norm_topk_prob 时,路由权重才会除以其 top-k 之和。任何其他分母,都需要在这两种路由器中打一个几行的补丁,保留 top k1 个专家并除以 top-k2 的质量。
Megatron 源码
moe_utils.py#L913-L947(top-k 权重:在 top-k 之前或之后做 softmax,sigmoid 除以其 top-k 之和,然后缩放)
913if score_function == "softmax":914if use_pre_softmax:915scores = torch.softmax(logits, dim=-1, dtype=torch.float32)916if precomputed_indices is not None:917top_indices = precomputed_indices918probs = torch.gather(scores, dim=1, index=top_indices)919else:920probs, top_indices = compute_topk(scores, topk, num_groups, group_topk)921else:922if precomputed_indices is not None:923top_indices = precomputed_indices924scores = torch.gather(logits, dim=1, index=top_indices)925else:926scores, top_indices = compute_topk(logits, topk, num_groups, group_topk)927probs = torch.softmax(scores, dim=-1, dtype=torch.float32)928elif score_function in ("sigmoid", "sqrtsoftplus"):929if score_function == "sigmoid":930scores = torch.sigmoid(logits.float())931else:932scores = torch.nn.functional.softplus(logits.float()).sqrt()933if precomputed_indices is not None:934top_indices = precomputed_indices935scores = torch.gather(scores, dim=1, index=top_indices)936elif expert_bias is not None:937scores_for_routing = scores + expert_bias.float()938_, top_indices = compute_topk(scores_for_routing, topk, num_groups, group_topk)939scores = torch.gather(scores, dim=1, index=top_indices)940else:941scores, top_indices = compute_topk(scores, topk, num_groups, group_topk)942probs = scores / (scores.sum(dim=-1, keepdim=True) + 1e-20) if topk > 1 else scores943else:944raise ValueError(f"Invalid score_function: {score_function}")945946if scaling_factor:947probs = probs * scaling_factor
拟议:一个几行的补丁,保留 top k1 个专家并除以 top-k2 的质量,加在那里或加在 transformers 的路由器里;然后是下面的服务 k 扫描。
请在带标注的任务上,同时也在困惑度上,对每个服务用的 k 打分,因为两者可能不一致:在 35B 模型上取 top-6 时,以训练时的 top-8 质量为分母时困惑度最低,而以 top-16 质量为分母时 MMLU 最高249。
当你需要降低每个 token 的路由专家计算量、并且能把每个专家都留在显存中时使用它:以较小的 k 服务,并且用比留存者自身更大的质量去除它们的权重。在 Qwen3.6-35B-A3B 的 top-4 下,除以 top-16 的质量使 MMLU 保持在训练模型的 0.35 分以内246。请在你自己的模型上检查分母,因为它有多重要取决于你的路由器有多平坦247。
减小 k 能节省计算,但每个专家仍留在显存里。当限制你推理服务的是显存而不是计算时,怎样才能让专家占用更少的显存?
低比特专家
训练结束后,权重不再变化,有两个数字描述它们在服务时的代价:它们占用的显存字节数,以及每个解码 token 读取的字节数。在 MoE 中,路由专家占据了大部分参数,所以它们的精度决定了模型的大部分体积,只把它们存成 4 位、其余部分保留更宽的格式,就能获得大部分节省。
一些前沿 MoE 已经以这种方式发布。OpenAI 对 gpt-oss 做后训练,把它的 MoE 权重量化为 MXFP4,每个参数 4.25 位。这些权重占参数的 90% 以上,所以 120b 模型可以放进一块 80 GB 的 GPU250。Moonshot 通过 SFT 和 RL 把 Kimi K3 的路由专家量化为 MXFP4,其余部分保留更高精度21。DeepSeek-V4 在后训练中以 MXFP4 量化感知训练(quantization-aware training)训练时在前向传播中把权重舍入到目标格式。来训练它的 MoE 专家权重251,GLM 团队在 GLM-5 的 SFT 阶段应用了 INT4 量化感知训练252。这四个模型的量化都发生在预训练之后,所以你的预训练配置保持不变。
下图比较了存储 gpt-oss-20b 的三种方式,每次解码一个 token:全部使用 bf16、仅路由专家使用 4 位,以及每个线性层都使用 4 位。每根柱子是模型在显存中的大小,蓝色块是一个 token 读取的权重。从第一行到第二行,比较模型缩小了多少与一个 token 的读取量缩小了多少,然后在第三行看看注意力使用 4 位增加了什么。

把专家存成 4 位使 gpt-oss-20b 从 39.0 GiB 缩小到 12.8 GiB,缩小为三分之一,但一个解码 token 读取的权重字节数只从 6.72 GiB 降到 3.45 GiB,约减半。在 batch-1 解码中,一个 token 在每层 32 个专家里只读 4 个,却要读全部的注意力和 unembedding,所以一旦专家变小,这些 bf16 权重就占了它所读权重的三分之二。把注意力也放到 4 位,把这些读取量又削减了四分之一,却只释放 0.9 GiB 的显存,因为注意力占的参数很少。
已发布的检查点两种范围都有采用。ZAYA1-8B 的 MXFP4 发布版只量化路由专家,Kimi K2 Thinking 和 Qwen 的 Qwen3.5 GPTQ-Int4 版本也是如此,只是用 int4 而不是 MXFP4253。Qwen 针对 Qwen3 30B MoE 的 GPTQ-Int4 版本,以及腾讯针对 Hunyuan-A13B 的版本,把注意力也放进了 int4,只留下路由器、embedding 和输出头不量化254。
Megatron 通过 ModelOpt 导出:examples/post_training/modelopt/quantize.py 在 --export-quant-cfg 中接收一个 ModelOpt 配置名称,FP8 导出用 FP8_DEFAULT_CFG,选项中还有 --weight-only 和 --sync-expert-weight-amax。要以 4 位训练,请设置 --fp4-format e2m1,即在 Blackwell 上通过 Transformer Engine 使用 NVFP4,这需要 Transformer Engine 2.7 或更新版本,并且不能与 --fp8-format 组合使用。
Megatron 源码
post_training/arguments.py#L56-L61 (--export-quant-cfg)
56group.add_argument(57"--export-quant-cfg",58type=str,59default=None,60# TODO replace choices with mtq.config.choices after deprecating the shorter aliases61help="Specify a quantization config from mtq.config.choices.",
quantize.py#L159-L176(导出选项:--weight-only、--sync-expert-weight-amax)
159group.add_argument("--weight-only", action="store_true", help="Disable input quantization.")160group.add_argument(161"--recipe",162type=str,163default=None,164help=(165"PTQ recipe YAML file or name without suffix (e.g. "166"'general/ptq/nvfp4_default-fp8_kv', "167"'models/Nemotron-3-Super-120B-A12B/super-nvfp4'). "168"When set, --export-quant-cfg / --export-kv-cache-quant are ignored; "169"the recipe is authoritative for quant_cfg, algorithm, and KV cache config."170),171)172group.add_argument(173"--sync-expert-weight-amax",174action="store_true",175help="Synchronize expert weight amax across experts.",176)
transformer_config.py#L735-L743(--fp4-format,通过 Transformer Engine 使用 NVFP4)
735fp4: Optional[Literal['e2m1']] = field(736default=None, metadata={"argparse_meta": {"arg_names": ["--fp4-format"]}}737)738"""If set, enables the use of FP4 precision through Transformer Engine. Currently only 739supports 'nvfp4' which uses NVFP4BlockScaling recipe (requires TE >= 2.7.0.dev0)."""740741fp4_recipe: Optional[Literal['nvfp4', 'custom']] = "nvfp4"742"""If set, enables the use of FP4 precision through Transformer Engine. Currently only743'nvfp4' is supported which uses NVFP4BlockScaling recipe for Blackwell+ architecture."""
arguments.py#L1060-L1070(FP4 需要 Transformer Engine 2.7,不能与 --fp8-format 一起用)
1060# FP4 and FP8 are mutually exclusive1061if args.fp4 and args.fp8:1062raise ValueError("--fp4-format and --fp8-format cannot be used simultaneously. Please choose one.")10631064# FP4 param requires FP4 mode1065if args.fp4_param_gather and not args.fp4:1066raise ValueError("--fp4-param-gather must be used together with --fp4-format.")10671068# FP4 requires TE >= 2.7.0.dev01069if args.fp4 and not is_te_min_version("2.7.0.dev0"):1070raise ValueError("--fp4-format requires Transformer Engine >= 2.7.0.dev0 for NVFP4BlockScaling support.")
拟议:我们的 t56 流程,精简版:在单块 GPU、EP1 下做 PTQ 导出,进行 24 次 QAT 迭代,然后运行逐专家失真脚本。
请使用 3.0 中每个专家的 token 计数,绘制每个专家的量化误差与其 token 数的关系,这样因为很少被路由而吃亏的专家就会凸显出来。然后在相同文本上,比较量化导出模型的 loss 与 Megatron 的 loss。
当推理服务受限于显存或每个 token 读取的字节数时使用它:在后训练中把路由专家量化为 4 位,其余部分像 Kimi K3 那样保留更高精度。
用更少的比特存储专家,缩小了每块 GPU 持有的内容,但没有回答该把它们分散到多少块 GPU 上。一旦请求逐 token 到来,你还应该把它们分散到与训练时一样多的 GPU 上吗?
推理服务中的专家并行
训练为一种类型的步骤选择专家并行大小:一起处理的大批量 token。推理服务则运行两种步骤。prefill 步骤处理 prompt,DeepSeek 的引擎允许这样的一步在每块 GPU 上携带多达 32,768 个 token255。decode 步骤对每个在途请求只携带下一个或少数几个 token,所以每个专家每一步看到的 token 很少。把专家放到更多 GPU 上在这里有帮助:每块 GPU 持有更少的专家,每步读取更少的权重,而 all-to-all 则为每个专家汇集一个更大的 batch256。
DeepSeek 在服务 DeepSeek-V4.1-Flash 时,对两个阶段朝相反的方向设定规模。Prefill 在 EP2 到 EP8 运行,取 GPU 显存足够的最小规模;decode 在 EP64 到 EP128 运行,取可用 GPU 所允许的最大规模。两个阶段中,注意力都是数据并行,每个 EP rank 对应一个 rank,且两个阶段都不使用张量并行或上下文并行256。
下图重绘了 DeepSeek 自己对 decode 中这两种设置的比较,每个点对应每块 GPU 的请求数。每块 GPU 64 个请求时,EP64 每块 GPU 持有 7 个路由专家,每块 GPU 每秒解码约 15,700 个 token、每个用户约每秒 246 个 token,而 EP8 每块 GPU 持有 52 个路由专家,达到约 12,600 和 198,所以两个数字在 EP64 下都高出约 25%。每块 GPU 256 个请求时,两种设置几乎重合,分别约为每块 GPU 每秒 26,300 和 24,900 个 token257。

宽度是有代价的。DeepSeek 给 prefill 和 decode 的 GPU 数量大致相等,所以 decode 在 EP64 或更大时,值得运行的最小部署是 prefill 64 块加 decode 64 块 GPU258。一个 EP 实例的所有 GPU 还构成同一个通信域,所以一块 GPU 故障就会使整个实例宕机,重启时 DeepSeek 会把 EP 组重新调整到仍然健康的 GPU 上259。
Megatron 在其 coordinator 模式(默认)下使用专家并行进行服务;direct 模式拒绝大于 1 的 EP 大小。在专家并行下,只有当每个 EP rank 都在 decode 时,一步才会作为 CUDA graph 运行:只要有任何一个 rank 的 batch 里有 prefill,所有 rank 都会回退到 eager 模式。在 RL 中,--rl-inference-expert-model-parallel-size 给 rollout 引擎设置它自己的 EP 大小,它被构建成一个单独的推理模型,训练器的权重会被重新灌入(refit)其中。
Megatron 源码
mcore-inference-user-guide.md#L277-L278(EP 需要 coordinator 模式)
277- *Required* for: HTTP serving (`serve`), expert parallelism (`EP > 1`),278multimodal inputs, streaming, and the lifecycle controls
batch_dimensions_utils.py#L156-L161(一个 prefill rank 会使整个 EP 组转到 eager)
156"""Adjust CUDA graph batch dimensions for expert parallelism.157158All-reduce-max the token count and non-decode flag across the EP group.159If any rank has a prefill (non-decode) step, all ranks fall back to eager160mode (return None) — the non-CG path handles variable token counts via161use_allgather_v. Otherwise return adjusted dims with the max token count.
rl_config.py#L140-L141(rollout 的 EP 大小)
140rl_inference_expert_model_parallel_size: int | None = None141"""Degree of expert model parallelism for inference for RL."""
training.py#L1965-L1993(带有自己并行配置的独立推理模型)
1965if args.perform_rl_step:1966# RL inference doesn't support CP; when training uses CP>1, always build a1967# separate CP=1 inference model (CP ranks become extra DP replicas, dp*=cp).1968force_cp1_inference_model = args.context_parallel_size > 11969if (1970args.rl_inference_tensor_model_parallel_size is not None1971or args.rl_inference_pipeline_model_parallel_size is not None1972or args.rl_inference_expert_model_parallel_size is not None1973or args.rl_inference_expert_tensor_model_parallel_size is not None1974or force_cp1_inference_model1975):1976from megatron.core.inference.shards import build_inference_pg_collection19771978print_rank_0(1979"Building separate RL inference model with custom parallelism: "1980f"TP={args.rl_inference_tensor_model_parallel_size}, "1981f"PP={args.rl_inference_pipeline_model_parallel_size}, "1982f"CP={1 if force_cp1_inference_model else None}, "1983f"EP={args.rl_inference_expert_model_parallel_size}, "1984f"ExptTP={args.rl_inference_expert_tensor_model_parallel_size}"1985)1986inference_pg_collection = build_inference_pg_collection(1987args.world_size,1988tp_size=args.rl_inference_tensor_model_parallel_size,1989pp_size=args.rl_inference_pipeline_model_parallel_size,1990cp_size=1 if force_cp1_inference_model else None,1991ep_size=args.rl_inference_expert_model_parallel_size,1992expt_tp_size=args.rl_inference_expert_tensor_model_parallel_size,1993use_tp_pp_dp_mapping=args.use_tp_pp_dp_mapping,
rl_utils.py#L810-L822(权重被重新灌入其中)
810# If we have separate training and inference models we to refit weights from the training model to the inference model.811has_separate_inference_model = inference_model is not None812if has_separate_inference_model:813# If the separate inference model weights were prefetched to CPU while idle, bring them814# back to GPU before refit/copy and before any CUDA-graph'd inference.815with nvtx_range("rl/prefetch-weights-to-gpu", time=True):816inf_core = unwrap_model(inference_model[0])817_maybe_prefetch_separate_inference_model_weights(inf_core, to_cpu=False)818swap_model_weights(819model,820inference_model,821args.refit_method,822execution_batch_bytes=args.refit_execution_batch_bytes,
DeepSeek 把宽 EP 在 decode 中的收益部分归功于“good EPLB support”256,即它的专家并行负载均衡器,所以请跟踪最慢 EP rank 的负载与平均值之比,DeepSeek 将其报告为 moe_lb。借助热门专家的冗余副本,DeepSeek 在 decode 中把它保持在 1.09071。
当你需要 decode 速度并且有足够的 GPU 做宽部署时使用它:像 DeepSeek 对 V4.1-Flash 所做的那样,decode 采用 GPU 所允许的最宽的专家并行,prefill 采用显存能放下的最窄的专家并行,并给宽 decode 组配备冗余专家,使它最慢的 rank 保持接近平均值256,71。
更宽的专家组改变了每块 GPU 做多少专家工作,但每块 GPU 仍然把注意力和专家并排运行,尽管两者对它的要求不同。在推理时,共享 GPU 仍然是放置它们的正确方式吗?
注意力-FFN 解耦
在 colocated(同置)布局中,专家并行组里的每块 GPU 都运行每一层的两半,即注意力和专家,但在解码期间这两半需要不同的资源。注意力持有的参数很少,却要为每个在途请求保存 key-value cache,而专家持有大部分参数,且不保存按请求区分的状态260。因此推理服务可以把注意力和专家放在不同的 GPU 上,各自一个池,并来回传递 micro-batch,使每个池在另一个池处理上一个 micro-batch 时进行计算。Megatron 的 megatron/core/inference/disaggregation 沿着另一条线来拆分:它把 KV 和 SSM 状态从 prefill 引擎交给 decode 引擎。MegaScale-Infer 以这种方式在每一层内部把注意力和 FFN 模块解耦,据报告,其每块 GPU 的吞吐最高可达早期推理服务系统的 1.90 倍261。
Megatron 源码
mcore-inference-user-guide.md#L130(Megatron 的解耦:prefill 到 decode,而不是注意力到 FFN)
130| **Disaggregation** | KV and SSM state handoff between prefill and decode engines over NIXL or NCCL, with resharding across mismatched TP/PP layouts. Refer to [Disaggregated Prefill and Decode](#disaggregated-prefill-and-decode) for what is and is not turnkey today |下图绘制了 FastAFD 对 Qwen3-235B-A22B 的部署,28 块注意力 GPU 加 4 块专家 GPU,旁边是 4 块 GPU 上的 colocated 专家并行262。在左侧,比较每种布局下一块 GPU 持有什么:没有专家的注意力 GPU 有空间容纳更多请求的缓存,而专家 GPU 不持有任何请求的缓存,每块 GPU 请求数的柱子统计了两个池。在右侧,跟随一个 decode 步,看看当第一个 micro-batch 去专家那里时,第二个 micro-batch 如何让注意力池保持忙碌。colocated 那一行同样用两个 micro-batch 重叠它的 all-to-all,vLLM 把这提供为 dual-batch overlap263。

这能带来多少收益,取决于你拿它与什么比较。按已发表的数字,FastAFD 的布局给出的每块 GPU 吞吐是 colocated EP4 的 1.41 倍。美团的 Qiu 等人用一个分析模型重构了这个增益,然后在该模型中为两种布局重新配置了同样的 72 块 GPU 预算,比值降到 0.99 倍。在他们建模的所有设置中,同构 AFD 只在少数几个设置中提高了固定预算下的吞吐262。Step-3 的头条数字,在每秒 20 个 token 的相同解码目标下,每块 GPU 每秒 4,039 个 token 对 DeepSeek-V3 的 2,324,是把两个不同的模型相互对比,所以它并没有把布局的作用单独分离出来264。
训练在这里决定一件事:专家池需要服务多稀疏的模型。Step-3 把稀疏度定义为激活专家数(包含共享专家)与路由专家数之比,并推导出专家池在保持 compute-bound 并使通信与计算重叠的前提下所能服务的最稀疏的 MoE。这个界限随模型宽度和深度而上升;在 DeepSeek-V3 的宽度和深度、H800 上它是 0.058,而 Step-3 训练时约为 0.08265。更稀疏的模型只能退回到大规模专家并行,或诸如 3.7 中分组受限路由这样的路由限制266。
当你的推理引擎能把注意力和专家作为独立的 GPU 池来运行时使用它(如 MegaScale-Infer 和 Step-3 的服务系统那样),并且该布局胜过为相同 GPU 数量重新配置的 colocated 专家并行布局,因为在 Qiu 等人的模型中,已发表的增益正是在这个对比之下缩小到持平的262。如果你打算这样服务,请在确定专家数量和 top-k 之前,针对你的宽度、深度和硬件计算 Step-3 的界限,并让激活比例保持在它之上265。
注意力和专家在哪里运行是一个推理服务的决定,但在 RL 后训练中,推理服务引擎还要写出训练器赖以学习的 rollout。你能指望训练器把每个 token 送到与 rollout 引擎相同的专家吗?
RL 路由
RL 后训练把样本生成与梯度计算分开。rollout 引擎用它自己的 kernel 生成样本,在 off-policy 或异步 RL 中,它的权重还比训练器落后一次或多次更新,而训练器要重新计算每个 token 来取梯度。这些差异可能使 token 概率发生偏移,而在 MoE 中它们还可能改变一个 token 所经过的专家,于是训练器对样本从未走过的路径求了导267,268。
每个成因都分别被测量过。Ma 等人用 SGLang 在 Qwen3-30B-A3B 上生成回复,再把它们送入 Megatron:约 10% 的路由器选择了不同的专家,94% 的 token 至少在一层中有所不同267,269。GSPO 的作者 Zheng 等人在 Qwen3-30B-A3B-Base 上测量了另一个成因:一次梯度更新之后,同一条 rollout 所激活的专家约有 10% 发生了变化268。这两个 10% 统计的是不同的东西:一个是跨引擎意见不一致的路由器,一个是一次更新中发生变化的被激活专家。
Ma 等人的修复方案 R3,记录 rollout 选中的专家,并在训练器中重放它们。这消除了差距中路由的那一部分,但没有消除其余部分:训练-推理 KL 从 1.5e-3 降到 7.5e-4,接近稠密 Qwen3-8B 的 6.4e-4270。在 Megatron 中,--moe-enable-routing-replay 使推理引擎记录每个请求的 top-k。然后你的 RL 框架在 REPLAY_FORWARD 传递之前,用 set_replay_data 把这些索引交还给训练器。第三个动作 REPLAY_BACKWARD 会在激活重计算于反向传播期间重复前向传播时,再次重放这些索引。请在关闭引擎异步调度的情况下记录,因为引擎不允许两者同时使用。重放并不冻结路由器:在 REPLAY_FORWARD 中,它在被重放的索引处收集自己当前的分数,所以它的梯度流经的是 rollout 所选的专家,而不是它自己会选的专家。
Megatron 源码
inference_request.py#L786-L787(rollout 每个请求的索引)
786# routing_indices is reconstructed from per-block storage when a request finishes.787routing_indices: Optional[np.ndarray] = None
router_replay.md#L70-L80(set_replay_data,然后是 REPLAY_FORWARD)
701. **Enable & Instantiate**71- Create one `RouterReplay` instance per MoE router layer when building the model.72- Optionally use the global helpers to set/clear actions across all layers.732. **Record Routing Decisions**74- Set action: `RouterReplay.set_global_router_replay_action(RouterReplayAction.RECORD)`.75- Run the model; retrieve per-layer indices via `RouterReplay.get_recorded_data()` and persist.763. **Forward Replay**77- Load indices and distribute: `RouterReplay.set_replay_data(list_of_tensors)`.78- Set action: `RouterReplay.set_global_router_replay_action(RouterReplayAction.REPLAY_FORWARD)`.79- Run the model; dynamic top‑k is bypassed and target indices are used.804. **Backward Replay**
router_replay.py#L13-L15(重计算下的 REPLAY_BACKWARD)
13RECORD = "record" # Record the topk indices for replay14REPLAY_FORWARD = "replay_forward" # Replay the recorded topk indices for forward pass15REPLAY_BACKWARD = "replay_backward" # Replay topk indices for re-compute during backward pass
router_replay.py#L161-L182(记录,或收集被重放的索引)
161if self.router_replay_action == RouterReplayAction.RECORD:162probs, top_indices = default_compute_topk(163scores, topk, num_groups=num_groups, group_topk=group_topk164)165self.record_indices(top_indices)166return probs, top_indices167elif self.router_replay_action == RouterReplayAction.REPLAY_FORWARD:168top_indices = self.target_topk_idx169# Ensure indices are on the correct device170top_indices = top_indices.to(scores.device)171# Gather the scores for the replayed indices to get the probabilities172probs = scores.gather(1, top_indices)173return probs, top_indices174elif self.router_replay_action == RouterReplayAction.REPLAY_BACKWARD:175top_indices = self.replay_backward_list.pop(0)176# Ensure indices are on the correct device177top_indices = top_indices.to(scores.device)178# Gather the scores for the replayed indices to get the probabilities179probs = scores.gather(1, top_indices)180return probs, top_indices181else:182return default_compute_topk(scores, topk, num_groups, group_topk)
moe_utils.py#L899-L907(top-k 交给重放)
899def compute_topk(scores, topk, num_groups=None, group_topk=None):900# Default behavior if no replay is active901902if router_replay is None:903return _compute_topk(scores, topk, num_groups=num_groups, group_topk=group_topk)904else:905return router_replay.get_replay_topk(906scores, topk, num_groups, group_topk, _compute_topk907)
dynamic_engine.py#L1863-L1864(异步调度下拒绝记录)
1863if model_config.moe_enable_routing_replay:1864raise ValueError("Async scheduling does not support routing replay.")
mcore-inference-user-guide.md#L133-L149(针对训练-推理不匹配的 batch 不变模式)
133> **Batch-invariant kernels (training and inference log-prob consistency).** Standard134> GEMM, attention, and norm kernels can produce slightly different numerics depending135> on batch composition, which shows up as log-prob mismatch between training and136> inference. This mismatch is a real source of error and instability in RL. Megatron Inference137> offers *batch-invariant kernels* whose outputs do not depend on how requests are138> batched, so per-token log-probs match between the training and inference forward139> passes.140>141> Enable it with `batch_invariant_mode` on the model's `TransformerConfig` — it142> is *not* an `InferenceConfig` field, so it must be set when you build the143> model, not on the engine config. Two companion fields tune it:144> `batch_invariant_backend` (`te_native` by default, or `deepgemm` / `triton`)145> selects the GEMM backend, and `batch_invariant_collective` (`ordered` by146> default, or `multimem`) selects the cross-rank expert-combine reduction.147>148> Both dense and MoE models are supported. Batch-invariant MoE supports BF16 and149> MXFP8 squared-ReLU/SwiGLU experts, requires unfused permute/unpermute, and under
transformer_config.py#L3770-L3803(batch 不变的要求)
3770assert self.params_dtype == torch.bfloat16, (3771"Batch invariant mode supports BF16 model parameters only; "3772f"got {self.params_dtype}."3773)3774assert (3775self.attention_backend == AttnBackend.flash3776), "Batch invariant mode only supports FlashAttention (--attention-backend flash)"3777# The training (TransformerEngine) and inference attention paths must run3778# the same FlashAttention kernel, so the version cannot be left to each3779# path's autodetection. FlashAttention-2 is excluded because it does not3780# expose the fixed num_splits schedule the batch-invariant kernels require.3781assert self.flash_attention_version in (3, 4), (3782"Batch invariant mode requires --flash-attention-version 3 or 4 so the "3783"training and inference attention paths run the same batch-invariant "3784f"FlashAttention kernel (got {self.flash_attention_version})."3785)3786# Context parallelism routes through TE's FA2 fwd/bwd kernels directly, which3787# cannot be pinned to another version; dropout is not batch-invariant.3788assert (3789self.context_parallel_size == 13790), "Batch invariant mode does not support context parallelism"3791assert (3792self.attention_dropout == 0.03793), "Batch invariant mode does not support attention dropout"3794if (self.num_moe_experts or 0) > 0:3795from megatron.core.transformer.custom_layers.batch_invariant_kernels import (3796HAVE_DEEPGEMM_BF16,3797)37983799if self.transformer_impl != "inference_optimized":3800assert self.moe_token_dispatcher_type == "alltoall", (3801"Batch-invariant MoE training requires "3802"moe_token_dispatcher_type='alltoall'."3803)
transformer_config.py#L1337-L1341(“will significantly affect speed”)
1337batch_invariant_mode: bool = False1338"""If true, uses batch-invariant kernels that provide deterministic forward execution regardless1339of batch size. This ensures bitwise identical results when the same inputs are processed1340in different batch configurations. This will significantly affect speed of 1341training and inference as the kernels are not full optimized.
rl_utils.py#L521-L533(训练-推理概率指标)
521group_stats: Statistics object to update with computed metrics522"""523n_elems = mask.sum()524if n_elems > 0:525ratios = (old_logprobs - inference_logprobs).exp()[mask]526abs_diffs = (old_logprobs.exp() - inference_logprobs.exp()).abs()[mask]527528group_stats.min_piold_to_inf_prob = ratios.min().item()529group_stats.max_piold_to_inf_prob = ratios.max().item()530group_stats.mean_piold_to_inf_prob = (ratios.sum() / n_elems).item()531group_stats.min_inf_train_prob_abs_diff = abs_diffs.min().item()532group_stats.max_inf_train_prob_abs_diff = abs_diffs.max().item()533group_stats.mean_inf_train_prob_abs_diff = (abs_diffs.sum() / n_elems).item()
rl_utils.py#L1991-L2001(记录训练-推理差距)
1991metrics = {1992'min_piold_to_inf_prob': group_stats.min_piold_to_inf_prob,1993'max_piold_to_inf_prob': group_stats.max_piold_to_inf_prob,1994'mean_piold_to_inf_prob': group_stats.mean_piold_to_inf_prob,1995'min_inf_train_prob_abs_diff': group_stats.min_inf_train_prob_abs_diff,1996'max_inf_train_prob_abs_diff': group_stats.max_inf_train_prob_abs_diff,1997'mean_inf_train_prob_abs_diff': group_stats.mean_inf_train_prob_abs_diff,1998'min_inf_prob': group_stats.min_inf_prob,1999'max_inf_prob': group_stats.max_inf_prob,2000'mean_inf_prob': group_stats.mean_inf_prob,2001}
下图模拟了一个玩具 MoE 层(512 个 token、16 选 4),其 rollout 以自己的数值方式路由,并比训练器落后一次更新,每个成因都按上面的测量结果缩放。在自己路由的训练器与做重放的训练器之间,中间一行冻结了路由器矩阵。在左侧,比较训练器为一个 token 运行的专家与 rollout 的选择;在右侧,看专家与 rollout 不同的 token 所占的比例:在玩具示例中,训练器自己路由时该比例居高不下;冻结的路由器仍然留有来自数值差异和路由器输入变化的那一部分;而重放则按构造使它归零。

已发布的 RL 方案分处于这一选择的两侧。DeepSeek-V3.2、MiMo-V2-Flash 和 Instella-MoE 在训练器中重放 rollout 的路由271,272,273,而 Kimi K2.5 和 Mellum 2 没有描述重放,而是在 loss 中处理这种不匹配,即屏蔽概率比值漂移过大的 token 的梯度274,275。
重放在奖励上是否划算仍有争议。在 Ma 等人对 Qwen3-30B-A3B 的比较中,不做重放的 GRPO 在全部三种设置下都崩溃了,使用截断重要性采样的 GRPO 在两种设置中有一种崩溃,而使用重放的运行没有一次崩溃276,他们报告训练稳定性和性能都有显著提升267。Qwen 后来由 Zheng 等人做的一项研究在 on-policy 训练中没有看到 R3 的收益277,而在 He 等人的实验中,重放在 Moonlight-16B-A3B 上的得分低于普通 GRPO,但在 Qwen 的 30B-A3B 模型上并非如此278。在 rollout 中它的开销很小,存储路由信息增加的延迟不到 3%279。曾使用过重放的 GSPO 作者列出了额外的显存和通信开销以及对模型容量可能的限制,并改用序列级重要性比值,放弃了它268。
TRL 在不做重放的情况下处理同样的不匹配。在它的 GRPOConfig 中,importance_sampling_level="sequence" 给出 GSPO 的序列级比值,而默认开启的 vllm_importance_sampling_correction 对训练器与 vLLM 的概率之间应用重要性采样比值,并屏蔽比值落在设定范围之外的序列280。
重放留下的部分问题是 kernel 自身造成的那部分差距,Megatron 用 --batch-invariant-mode 来应对:它把 batch 不变 kernel 记录为解决训练与推理之间 log-probability 不匹配的办法,这是“a real source of error and instability in RL”。它需要 flash attention 3 或 4,并且对 MoE 训练还需要 alltoall dispatcher,Megatron 警告它“will significantly affect speed”。在我们的 64 专家 MoE 上,使用较旧的 Megatron 提交,使用它的两次运行在全部 12 次迭代中输出了相同的 loss 和梯度范数,它对迭代耗时的影响无法与运行间的波动区分开。比训练器落后一次更新的 rollout 权重是另一个成因,batch 不变模式并不解决它268。
DeepSeek 的生产级推理引擎 DeepInfer 提供了同样的选项:设置 DEEPINFER_BATCH_INVARIANT=1 时,它使模型结果在不同的 batch 组成下保持一致,再加上 DEEPINFER_ENABLE_MTP_VARLEN=0 和每个请求固定的随机种子,它就能确定性地采样,且仅限 NVIDIA GPU281。
StepFun 对 Step 5 Preview 的 RL 同时使用了两种补救措施。当 rollout 使用当前权重时,它对齐了训练和推理的算子,直到它们的 log-probability 按位相同,开销不到 10%。当 rollout 陈旧时,它在冻结路由器的情况下重放所路由的专家,包括它们的索引和系数,对 actor 和 reference 策略都如此。这比 Megatron 的重放走得更远,后者是根据路由器当前的分数,在被重放的索引处重新计算权重282。
NVIDIA 针对 Nemotron 3 Super 和 Ultra 的 NeMo-RL 方案,在 rollout 至多落后训练器一次更新的异步 RL 中冻结路由器矩阵,并继续更新 Megatron 加到分数上、仅用于选择专家的均衡偏置283。该偏置每一步都在变,所以即使矩阵被冻结,选择仍然会变化,图中冻结的一行忽略了这种漂移。
量化的 rollout 激活会扩大同样的差距。Qwen 的 Zhuge 等人用 NVFP4 做 rollout(权重和激活都是 4 位),对照 BF16 训练器,训练在大约 150 步后崩溃。他们把只量化权重的 rollout 与只量化激活的 rollout 作比较,将崩溃追溯到量化的激活而不是权重284。
有害的不匹配表现为学习不好或崩溃的 RL 训练276。信号是训练-推理概率差距,Megatron 的 RL 循环向 W&B 记录两个指标:mean_inf_train_prob_abs_diff,即训练器与 rollout 概率之间的平均绝对差;以及 max_piold_to_inf_prob,即训练器概率与 rollout 概率之比的最大值。要单独看路由那一部分,请离线比较 Megatron 推理引擎记录的 routing_indices 与训练器自己的 top-k。
当一个 MoE 的 RL 训练中训练器和 rollout 引擎在路由上意见不一致时使用它,无论这种不一致来自独立的引擎,还是(在 off-policy 或异步 RL 中)来自落后于训练器的 rollout 权重。重放消除了这种不一致,但它在奖励上的收益存在争议:Ma 等人报告了收益,而 Qwen 的 on-policy 研究则没有看到。请先测量有多少路由器不一致,再在保留它之前比较有无重放的学习情况。如果你还量化了 rollout,请先尝试只量化权重,因为在 Zhuge 等人的实验中,是量化的激活导致了崩溃。
你现在已经带着一个 MoE 走完了从它最初的稠密基线,到推理服务,再进入 RL 循环的全过程。沿途的选择中,哪些可以视为已有定论,哪些仍然悬而未决?
5. 结语
我们从一个稠密训练出发,逐项设置地拆解了 MoE 层,然后跟随训练好的模型进入推理服务和 RL 后训练。你现在可以在信任集群之前先测试它,用相同的数据和启动脚本训练稠密基线和 MoE,并让两次运行足够可重复以便比较。第 3 章把该层的每个部分,从路由器的分数到 all-to-all,都配上了需要关注的信号和一条建议。附录 A.2 则反过来走,从仪表盘上的症状回溯到背后的配置。
下面的代码块汇集了各章推荐的每个参数,每个都带有一条注释,指出论证它的章节:被注释掉的行只在某个条件下成立,或者用来替换上面的某一行,尖括号中的值由你自己选择。请从你自己的启动脚本出发,一次引入一组,并拿每一组与前一次运行比较来测量,因为每条建议都来自各自的配置,它们的收益未必能叠加。
按章节列出的所有推荐参数
# 2.1 Test your hardware
--gpu-sniff-test-interval <n>               # 2.1: GPU and EP all-to-all check every n iters

# 2.2 Build your image (EFA on AWS P5)
# 2.2, 3.7: EFA libraries first, or NCCL quietly falls back to sockets
export LD_LIBRARY_PATH=/opt/amazon/ofi-nccl/lib:/opt/amazon/efa/lib:${LD_LIBRARY_PATH:-}
export NCCL_NET_PLUGIN=ofi                  # 2.2: by name; a path left NCCL on sockets
export FI_PROVIDER=efa                      # 2.2
export FI_EFA_USE_DEVICE_RDMA=1             # 2.2
export NCCL_SOCKET_IFNAME='^lo,docker0,veth_def_agent'  # 2.2: adapt to your interfaces
export NCCL_DEBUG=INFO                      # 2.2, 3.7: want "Using network Libfabric"

# 2.5 Your first MoE
# --deterministic-mode                      # 2.5: to compare runs or chase a NaN;
# export NVTE_ALLOW_NONDETERMINISTIC_ALGO=0 #   also drop --cross-entropy-loss-fusion

# 3.0 Monitoring
--moe-per-layer-logging                     # 3.0, 3.5: router losses per layer
--save <dir> --save-interval <m>            # 3.0: token counts and dumps go here
--save-tokens-per-expert-interval <n>       # 3.0, 3.3: tokens per expert, MaxVio
--log-throughput --log-params-norm          # 3.0: TFLOP/s, parameter norm
--log-num-zeros-in-grad --log-max-attention-logit  # 3.0: run health
# --moe-routing-trace-path <dir> --moe-routing-trace-max-training-iters <n>
# --cuda-graph-impl none                    # 3.0: bounded routing trace; hooks skip graphs
# --save-activations-interval <n>           # 3.0, 3.4: expert output norms; sample sparsely

# 3.1 Router scoring
--moe-router-dtype fp32                     # 3.1: bf16 ties can flip experts
# --moe-router-score-function sigmoid       # 3.1, 3.3: needed by the expert bias
# --moe-router-pre-softmax                  # 3.1: softmax at top-1, else no router gradient
# --moe-z-loss-coeff 1e-3                   # 3.1: softmax router whose logits drift up

# 3.2 Routing strategy
# --moe-num-hash-layers <n>                 # 3.2: only to reproduce DeepSeek-V4;
#                                           #   load a fixed table, not the placeholder

# 3.3 Load balancing
--moe-router-load-balancing-type aux_loss --moe-aux-loss-coeff 1e-3  # 3.3 Aux loss
# --moe-router-force-load-balancing         # 3.3, 3.7: control run only, never train
# --moe-router-load-balancing-type global_aux_loss  # 3.3 Scope: domain experts, +5.8% step
# 3.3 Loss-free bias, in place of the aux_loss line:
# --moe-router-enable-expert-bias --moe-router-score-function sigmoid
# --moe-router-bias-update-rate <rate>      # tune to expert count; 1e-3 coarse past 128
# --moe-router-load-balancing-type seq_aux_loss --moe-aux-loss-coeff 1e-4  # DeepSeek-V3
# --moe-router-load-balancing-type quantile_balancing  # 3.3 Quantile: no aux loss,
#                                           #   router fusion or group-limited routing

# 3.4 Experts
# 2.5 shape; 3.4 Count and size: finer experts help, up to a point
--num-experts 64 --moe-ffn-hidden-size 1024 --moe-router-topk 8
# --moe-latent-size <l>                     # 3.4 Latent MoE: more experts, same traffic
# --moe-use-norm-before-up-proj             # 3.4: Kimi K3's fix for latent blow-ups
# --moe-shared-expert-intermediate-size 1024  # 3.4: routed width, top-k one lower
# --activation-func-clamp-value 10          # 3.4 Activation: if expert norms diverge
# --activation-func-tanh-clamp-scale 4 --activation-func-tanh-clamp-scale-linear 25
#                                           # 3.4: Kimi K3's SiTU-GLU, Megatron Core v0.20 on

# 3.5 Block layout
# --moe-layer-freq "([0]+[1]*15)"           # 3.5: leading dense layer, fewer all-to-alls
# --moe-shortcut-connection --moe-shortcut-parallel  # 3.5 Block wiring: hybrid stack;
#                                           #   no FSDP, CUDA graphs or full recompute

# 3.6 Training
# --moe-use-upcycling --moe-upcycling-granularity 8  # 3.6: first run only, 2.5's two fixes
# --optimizer muon --muon-extra-scale-factor 0.2     # 3.6 Optimizer: 1.0 diverged; no FSDP
# --moe-router-skip-muon                    # 3.6: router on Adam, Megatron Core v0.20 on
# --mtp-num-layers 1 --mtp-loss-scaling-factor 0.1   # 3.6 MTP
# --pipeline-model-parallel-layout <layout> # 3.6: place the MTP layer under PP
# --timing-log-level 2 --timing-log-option all       # 3.6: find the slowest PP stage
--rerun-mode validate_results               # 3.6 Stability: the default; keep it

# 3.7 Systems
# --profile --profile-step-start <a> --profile-step-end <b> --profile-ranks <r>
#                                           # 3.7 Profiling: one step per new config
# --moe-permute-fusion                      # 3.7: if permute and copy kernels show
--expert-model-parallel-size 8              # 3.7 Interconnect: EP inside one node
# --overlap-moe-expert-parallel-comm --delay-wgrad-compute  # 3.7 Overlap: exposed
#                                           #   all-to-all; no full recompute, VPP under PP
# --recompute-granularity selective --recompute-modules layernorm moe_act
# --fine-grained-activation-offloading --offload-modules core_attn attn_proj expert_fc1
#                                           # 3.7 Memory: when the overlap does not fit
# --activation-offload-fraction <f>         # 3.7: lower it if step time grows
# --moe-token-dispatcher-type flex --moe-router-num-groups <nodes> --moe-router-group-topk <g>
#                                           # 3.7 Group-limited: EP across nodes, DeepEP
# --moe-expert-capacity-factor <cf> --moe-pad-expert-input-to-capacity
#                                           # 3.7 Capacity: memory short; dropless to fine-tune
# --fp8-format <fmt> --fp8-recipe blockwise # 3.7 Precision: Hopper; mxfp8 on Blackwell
# --moe-router-padding-for-quantization     # 3.7: aligned counts for quantized GEMMs
# --moe-dispatch-fwd-dtype mxfp8 --moe-combine-bwd-dtype mxfp8  # 3.7: ncclep, Blackwell

# 4 From training to serving
# --fp4-format e2m1                         # 4 Low-bit: NVFP4 on Blackwell, not with FP8
# --rl-inference-expert-model-parallel-size <n>  # 4: rollout engine's own EP size
# --moe-enable-routing-replay               # 4 RL routing: rollout and trainer disagree
# --batch-invariant-mode                    # 4: kernels' share of the mismatch; slow
仍有大量问题悬而未决。我们对大规模训练 MoE 所知的大部分内容,来自开放权重模型的技术报告,而报告展示的是一个团队发布了什么:很少展示它尝试后又放弃的做法,或者敲定某个选择的那次实验。上面的许多建议都建立在某个实验室设置下的一次消融之上,每一条都值得在另一种规模、另一批数据或另一个集群上重新做一次实验。如果你做了,请连同配置和日志一起发表,包括负面结果:这样下一个团队才能从你学到的东西出发,而不是从零开始。你可以在本文的讨论页分享你的结果,或者询问我们的情况。
我们希望这篇文章能为你的下一次 MoE 训练省去我们花掉的那几天中的一部分。
致谢
感谢 Antoine Bosselut、Martin Jaggi 和 Swiss AI 团队提供了本文背后的部分算力,并在此过程中与我们进行了富有启发的交流。我们还感谢 Thibaud Frere 在图表方面提供的帮助。
附录
A.1 监控详解
本附录给出第 3 章“Watch”标注框背后的命令和计算。路由器统计描述工作的分布,路由 trace 保留各个专家的选择,激活转储显示专家产生了什么。运行级日志把这些测量与 loss、耗时和显存放在一起。
这些方案针对 Megatron 提交 d6316eb45。请把配置和 rank 布局与每次抓取一起保存:它们决定本地专家 id、token 位置和路由分数应当如何解读。请在短的诊断运行中收集 trace 和激活,与吞吐测量分开进行。
代码
router.py#L691-L700(辅助损失,每层一个槽位)
691layer_number = self._get_metric_layer_number()692693get_moe_metrics_tracker().record(694aux_loss_name,695aux_loss / aux_loss_coeff,696layer_number,697num_layers,698reduce_group=reduce_group,699needs_dp_avg=needs_dp_avg,700)
router.py#L805-L811(z-loss,每层一个槽位)
805get_moe_metrics_tracker().record(806"z_loss",807z_loss / moe_z_loss_coeff,808layer_number,809num_layers,810avg_group=self.tp_dp_cp_group,811)
moe_logging.py#L392-L404(逐层标量)
392for name in metric_names:393if name not in self._metrics:394continue395396values = self._metrics[name].values.float() * loss_scale397is_sparse = percentiles is not None and name in percentiles398for i, val in enumerate(values.tolist()):399if is_sparse and val == 0:400continue401if writer is not None:402writer.add_scalar(f"moe/{name}_layer_{i}", val, iteration)403if wandb_writer is not None:404wandb_writer.log({f"moe/{name}_layer_{i}": val}, iteration)
router_trace.py#L217-L221(每个路由器上的 hook)
217for chunk in model:218unwrapped = unwrap_model(chunk)219for module_name, module in unwrapped.named_modules():220if isinstance(module, TopKRouter):221handle = module.register_forward_hook(self.make_hook(module_name))
router_trace.py#L353-L365(路由映射转为 top-k id)
353if second.dtype == torch.bool:354topk = getattr(module, "topk", None)355if topk is None:356return357num_tokens = second.shape[0]358_, expert_idx = second.nonzero(as_tuple=True)359if expert_idx.numel() != num_tokens * topk:360return361top_indices = expert_idx.view(num_tokens, topk)362else:363top_indices = second364365top_indices_cpu = top_indices.detach().to("cpu", torch.int32, non_blocking=True)
router_trace.py#L383-L395(重新计算 logits,以 bf16 保存)
383if self.capture_logits:384hs_for_gating = self._extract_hidden_state(inputs, num_tokens)385gating_fn = getattr(module, "gating", None)386if hs_for_gating is not None and callable(gating_fn):387try:388with torch.no_grad():389logits = gating_fn(hs_for_gating)390if isinstance(logits, tuple):391logits = logits[0]392except Exception:393logits = None394if torch.is_tensor(logits) and logits.shape[0] == num_tokens:395logits_cpu = logits.detach().to("cpu", dtype=torch.bfloat16).contiguous()
training.py#L5387-L5393(参数范数)
5387if _should_compute_params_norm(args, iteration, is_first_iteration):5388# Cross-rank param L2 norm (--log-params-norm): a full-model reduction5389# + all-reduce that BLOCKS the training loop -- exposed goodput cost5390# (~1.5s cold on the first iteration, ~10ms steady). Kept as a real5391# cost span (it stalls the critical path), unlike passive monitors.5392with _otel_managed_span('step', 'megatron.train.params_norm', is_goodput_span=True):5393params_norm = calc_params_l2_norm(model, pg_collection=pg_collection)
clip_grads.py#L282-L288(梯度中的零)
282if grad_not_none and is_not_shared and is_not_tp_duplicate and is_not_gtp_duplicate:283grad_obj = getattr(param, grad_attr)284data_parallel_group = get_data_parallel_group_if_dtensor(grad_obj, data_parallel_group)285grad = to_local_if_dtensor(grad_obj).detach()286num_zeros = grad.numel() - torch.count_nonzero(grad)287num_zeros -= _gtp_pad_zero_count(param, grad) # exclude structural GTP padding288total_num_zeros = num_zeros + total_num_zeros
qk_clip.py#L30-L40(最大注意力 logit)
30torch.distributed.all_reduce(31transformer_layer.self_attention.core_attention.current_max_attn_logits,32op=torch.distributed.ReduceOp.MAX,33group=parallel_state.get_data_parallel_group(with_context_parallel=True),34)35log_max_attention_logit = max(36log_max_attention_logit,37torch.max(38transformer_layer.self_attention.core_attention.current_max_attn_logits39).item(),40)
param_and_grad_buffer.py#L396-L406(NaN 梯度会停止训练)
396grad_norm = self.buckets[i].grad_data.norm(p=2)397# check for NaN, Inf and unexpectedly large grads398if check_for_nan_or_inf:399rerun_state_machine.validate_result(400result=grad_norm,401rejection_func=torch.isnan,402message=f"found NaN in local grad norm for bucket #{i} "403f"in backward pass before data-parallel communication collective",404tolerance=0.001, # 0.1% tolerance to account for non-deterministic FA backward405fatal=True,406)
我们的脚本:router_watch.py 读取 token 计数和路由 trace,并在线上路由器上检查 fp32 翻转;expert_watch.py 读取激活转储;expert_watch_hooks.py 对线上前向采样;它们的命令和抓取方案出现在正文中相关指标的旁边。
路由器统计
逐层损失
请配合 2.4 中的 Trackio 启动器启用 --moe-per-layer-logging,以记录每一层的辅助损失和 z-loss。Megatron 记录配置中已启用的各项损失,并已除去其系数。使用专家偏置做均衡的训练,在启用了这些损失时,仍可以报告序列级辅助损失或 z-loss。
即使 token 计数不均匀,辅助损失在概率平坦时也可能读数为 1(3.3),所以请用 token 计数直接衡量负载。Z-loss 描述 logits 的尺度:其记录值的平方根给出各 token 上 logsumexp 的 RMS。
专家计数与 MaxVio
要保存每个本地专家处理的 token 数,请把这些参数加到训练命令中:
--save run/ \
--moe-grouped-gemm \
--save-tokens-per-expert-interval 100
grouped linear 层上的 hook 写出 run/tokens_per_expert/rank*.jsonl。每条记录标识一次迭代和一层,带有一个 tpe 列表,其中包含每个被抓取 micro-batch 的计数向量。decoder 层和 MTP 层有各自独立的标识。这些向量描述 dispatch 之后的本地专家负载(activation_logging.py)。
对于专家计数向量 c,MaxVio 衡量最忙专家相对于均值的超额负载52:
MaxVio = max(c) / mean(c) - 1例如,计数 [2, 2, 4, 0] 的均值为 2,MaxVio 为 1:最忙的专家接收的是平均负载的两倍。计数为零的专家也计入该均值,必须保留在计算中。均匀负载给出 0;全零向量的 MaxVio 未定义。
请在计算指标之前选定聚合范围:
- Micro-batch:按全局专家 id 的顺序,把一个专家并行(EP)组内的本地专家向量拼接起来。
- 全局 batch:把每个专家的计数在各 micro-batch 和各独立的数据副本上求和,然后从所得向量计算 MaxVio。
- 序列:使用单独的路由选择和序列边界,如“路由诊断”所述。
对各 micro-batch 的 MaxVio 取平均并不等于全局 batch 的 MaxVio。专家在每个 micro-batch 内可能负载不均,而在整个 batch 上却是均衡的(3.3)。聚合还必须保留层的标识:把流水线 stage 和 MTP 深度分开。交错流水线的各 chunk 会复用本地层 id,而保存的记录并不区分它们(activation_logging.py#L131-L134),所以抓取时请关闭交错。激活重计算可能使 hook 被重复调用,所以请在不做重计算的情况下抓取,或者保留原始前向的标识。
router_watch.py 读取器用一个从 rank 到全局专家 id 的显式映射来拼接计数文件。对于两个 rank、各持有四个专家的情况,请把 {"0": [0, 1], "1": [2, 3]} 保存为 experts.json,然后运行:
python3 scripts/router_watch.py counts run/tokens_per_expert \
    --num-experts 4 --ranks 0 1 \
    --expert-map experts.json --pool-ranks
--pool-ranks 声明所选文件包含同一层的独立工作,且已去除张量并行的重复。对于逐 micro-batch 的测量,请保留把各 rank 上被抓取的前向对应起来所需的标识。
每个 rank 的负载
对放置在每个 EP rank 上的专家的计数求和,然后把最忙的 rank 与均值比较。请与专家级 MaxVio 一起阅读:放在同一块 GPU 上的几个繁忙专家可能使工作集中在那里(3.3、3.7)。
启用容量限制或补齐时,grouped GEMM 的计数描述的是这些操作之后的工作量。要测量原始需求,请使用路由器未补齐的分配。
路由诊断
抓取专家选择
要做一次简短的抓取,请把以下参数加到训练命令中,并把 trace_steps 替换成要抓取的迭代次数:
--moe-routing-trace-path trace/ \
--moe-routing-trace-max-training-iters trace_steps \
--cuda-graph-impl none
hook 在 dispatch 之前记录所选的专家 id。添加 --moe-routing-trace-capture-logits 可保存 logits 文件,添加 --moe-routing-trace-capture-hidden-states --moe-routing-trace-dump-weights 可保存隐藏状态和路由器权重。这些抓取会写入磁盘,而且 Python hook 需要 eager 执行。
专家 id 按路由映射的顺序排列,所以当某个指标需要排名第一的专家时,请按重建的权重排序。丢弃可能导致整条记录被跳过。请把这样的空缺当作缺失的观测值(router_trace.py)。
来自 trace 的计数与 MaxVio
所选的专家 id 同样能给出 token 计数和 MaxVio,而无需抓取 logits。要读取一个有 64 个专家的 rank 的这些数据:
python3 scripts/router_watch.py trace trace/ --num-experts 64 --ranks 0每条 trace_call 记录包含一次被抓取调用的 counts 和 maxvio。rank_captured_step 记录把这些计数在每一层、每个 rank 和每一步内求和,然后从总和计算 MaxVio。这些汇总涵盖被抓取的 token;全局 batch 的测量需要其所有原始前向和独立副本,并去除张量并行的重复。合并抓取结果时,请使用“专家计数与 MaxVio”下的聚合规则。因丢弃分配而被跳过的记录仍然在这些总数中缺失。
逐序列均衡
逐序列均衡需要每一行 token 所属的序列信息。对于布局为 [sequence, batch, hidden]、batch 大小为 B 的完整、未切分的输入,第 s * B + b 行属于序列 b。仅当该布局成立时,才向 trace 读取器传入 --sequence-length S --batch-size B。
在每条序列内部,统计对每个专家的分配数(包括分配数为零的专家),然后从该向量计算 MaxVio。按层汇总各序列的值。
对于 packed 序列,请用实际的序列边界替换固定长度的布局。上下文并行或序列并行还需要 token 位置,才能把各 rank 上的片段拼接起来。跨观测跟踪一个 token 同样需要它的标识,因为两个训练步中相同的行号通常指的是不同的 token。
混合权重
logits 文件支持近似重建施加在所选专家上的权重。hook 重新计算这些 logits 并以 bf16 存储。请保留记录的选择,并在重建权重时使用该训练的打分函数、归一化和路由缩放因子。
对于 64 个专家、缩放因子为 1 的 softmax 抓取:
python3 scripts/router_watch.py trace trace/ \
    --num-experts 64 --ranks 0 --score softmax --scale 1
如果训练在选择之前对全部专家应用了 softmax,请添加 --pre-softmax。否则,softmax 作用于所选的 logits。对于 sigmoid 和 sqrt(softplus),请使用该训练对所选分数的归一化。专家偏置影响选择;请不要把它放进混合权重里。
令 w 表示最终所选的权重(包括缩放因子),令 q 为 w 除以其总和。请对每个 token 计算每个指标,再按层汇总:
- 最大权重:
max(w)是专家输出上最大的乘数。请使用max(q)来比较不同缩放因子下的集中程度。 - 所选权重的熵:
-sum(q * log(q))的取值范围是 0 到log(k),k 个所选权重越接近相等,它就越大。在 top-1 时为 0。 - Max1/Max2:最大权重除以第二大权重。接近 1 的值表示领先的几个权重相近;在 top-1 时该比值未定义。
- 估计的混合 RMS:当各专家输出的 RMS 相等且互不相关时,
sqrt(sum(q*q))估计的是相对于单个专家的混合 RMS(3.1)。使用 w 则包含了路由缩放因子。 - Top-k 概率质量:对于 pre-softmax 路由,在缩放之前把所选的全 softmax 概率求和。原始的 sigmoid 和 sqrt(softplus) 分数有不同的解释,因为它们不是对全部专家的概率。
为便于说明:所选权重 [0.75, 0.25] 给出的最大权重为 0.75,Max1/Max2 为 3,熵约为 0.562(使用自然对数)。
每个 token 到达的节点数
要测量通信扇出,请把所选的专家 id 映射到它们的目标节点,并统计每个 token 的不同节点数。按层报告均值和最大值(3.7)。
请向 trace 读取器传入 --node-map nodes.json。该文件把全局专家 id 映射到节点名称,例如 {"0": "node-a", "1": "node-a", "2": "node-b"}。对于有副本的专家,请抓取 dispatcher 实际选择的目标。统计远程节点还需要 token 的源节点,以便将其排除。
把扇出换算为字节需要隐藏维度宽度、dtype 和 dispatcher 的副本策略:每个专家一份副本,与每个目标节点一份副本,得到的流量大小不同。
被丢弃的分配
在有容量限制时,请根据路由器最终的路由映射来测量丢弃情况。对于 N 个有效 token 和 K 个留存的分配:
dropped_fraction = 1 - K / (N * topk)这统计的是丢失的 token-专家分配。一个 token 可能仍保留它的一些专家。计算时请排除被屏蔽的 token 以及为量化 GEMM 而添加的行。请使用线上 hook 做这项测量,因为保存的 trace 可能会跳过含有丢弃的记录。ExpertWatch 辅助工具会抓取这个映射;它的配置和支持的设置见“共享与路由贡献”。
精度翻转
fp32 翻转率衡量路由器计算改用 fp32 时,所选专家集合有多频繁地发生变化。两次计算必须使用同一次前向的输入、权重、偏置和选择规则。请比较集合,这样单纯顺序的变化就不会被算作翻转。
对于普通的 token-choice 路由,install_fp32_flip_hook 在线上状态下执行这项比较。请把它挂到所选 MoE 层的路由器上,进行一次 eager 前向。把 moe_layer、model 和 tokens 替换成训练框架中的对象:
import torch
from scripts.router_watch import install_fp32_flip_hook

previous_tf32 = torch.backends.cuda.matmul.allow_tf32
handle = install_fp32_flip_hook(moe_layer.router, emit=print)
try:
    torch.backends.cuda.matmul.allow_tf32 = False
    output = model(tokens)
finally:
    handle.remove()
    torch.backends.cuda.matmul.allow_tf32 = previous_tf32
禁用 TF32 使作为参照的矩阵乘法具有 fp32 精度。该 hook 在一个有限的有效 token 样本上比较所选的专家集合。它的 docstring 列出了所支持的设置;这些设置之外的路由变换会被拒绝。请在禁用 CUDA graph 且处于计时测量之外的情况下运行。
两次计算都从线上输入已有的精度出发。结果分离出的是在该输入精度下路由的不一致;评估它对 loss 的影响需要另做实验(3.1)。
对于离线比较,请保留被抓取前向的精确状态和门控输入,包括 jitter。内置的权重转储在每个路由器第一次被观察到的调用时做快照,所以它不会跟踪权重和均衡偏置之后的更新。隐藏状态和重新计算的 logits 以 bf16 存储,而且快照省略了路由器的线性 bias(如果存在的话)。因此,根据这些文件做出的重建应标注为近似,并说明抓取的步数和缺失的状态。
专家激活
抓取激活
添加 --save run/ --save-activations-interval 100 可抓取受支持线性模块的输入和输出,包括 grouped 专家 token 计数。每个模块的条目在其下一次被抓取的调用时会被覆盖,只留下最后被抓取的 micro-batch。hook 在被抓取的调用中把张量拷贝到 CPU,所以请使用稀疏的间隔和简短的诊断运行,并禁用 CUDA graph 和激活重计算。
每个专家的输出范数
原生转储的 experts.linear_fc2/output0 包含本地专家的各行。请用该模块的 input1 token 计数拆分这些行,转换成 fp32,并计算每个 token 输出向量的 L2 范数。这些范数的均值描述了专家的输出幅度。把每个范数除以输出宽度的平方根,得到 token RMS,便于跨不同宽度比较。
expert_watch.py 读取器执行这些计算。在装有 PyTorch 的环境中,运行:
python3 scripts/expert_watch.py \
    --unpadded --expert-tp-size 1 activations.pth
这些选项断言被抓取的行不含补齐,且专家张量并行为 1。读取器报告每个专家的 token 数、范数之和与平均范数。它还报告在收到 token 的专家中,最大和最小的平均范数相对于中位数的比值(3.4、3.6)。
空专家没有平均输出范数,所以读取器把空专家单独列出。当中位数为零时,这些比值同样未定义。对一个专家所有行拼接在一起取范数,会把输出幅度与 token 数混在一起;对逐 token 的范数取平均,才让这两种测量保持分离。
这些比值所用的中位数涵盖一个文件中的专家。要做整层的比较,请在计算中位数之前先拼接各 EP 分片。重复的观测可以通过对每个专家的 sum_l2 和 rows 求和,然后相除得到其均值来合并。当专家张量并行大于 1 时,请先合并部分输出向量;它们各自的范数不能相加来恢复完整向量的范数。请在这些计算中排除补齐的行。
grouped fc2 的输出可能已经包含路由权重,取决于实现在哪里应用它们。因此较小的范数可能反映的是较小的路由权重。请在各次比较中固定权重被应用的位置,并把混合权重与范数一起检查。
对于线上采样,ExpertWatch 在其 routed_experts 输出中报告相同的逐专家范数统计,包括 local_max_to_median 和 local_min_to_median。这些比值涵盖本地专家;请先跨 EP rank 合并它们的统计量,再计算整层的中位数。“共享与路由贡献”下的配置会在同一次前向中收集这些统计量。
潜在上投影
要检查潜在上投影,请读取 fc2_latent_proj/output0 并比较它的输入和输出 RMS(3.4)。RMS 消除了潜在宽度与模型宽度之间的差异。使用 --moe-use-norm-before-up-proj 时,也请在归一化之前采样,以找出增长从哪里开始。
共享与路由贡献
要比较这两个分支,请抓取经过可选 sigmoid 门之后的共享输出,以及经过反置换(unpermutation)和 combine 之后的路由输出。若存在潜在上投影,也要包含它。对每个 token 计算 norm(shared) / norm(routed),零分母单独处理。这个比值比较的是分支的幅度;这两个向量相加时仍然可能互相加强或抵消。
原始的 fc2 转储发生得更早:共享 fc2 在门控之前,路由 fc2 在 combine 之前。要在所需的位置做线上采样,请在一次诊断前向的前后挂上 ExpertWatch:
from scripts.expert_watch_hooks import ExpertWatch

with ExpertWatch(moe_layer, emit=print):
    output = model(tokens)
这个辅助工具支持 eager 执行、all-to-all dispatcher、张量并行和专家张量并行大小为 1,以及禁用共享专家重叠。样本必须未经补齐,且禁用量化和专家补齐。请把 hook 限定在诊断前向的范围内,如上所示,并按每个 rank 保存 JSON 输出,附上步数和 micro-batch 标识。
对于标准 MoE,该辅助工具通过从总量中减去门控之后的共享输出来恢复路由分支。这个减法保留了原始加法的舍入误差,所以当小的路由贡献紧挨着大的共享贡献时,需要在相加之前直接抓取。对于潜在 MoE,该辅助工具直接抓取上投影的输出。分支汇总包含补齐的位置,这就是此比较需要未经补齐的样本的原因。
要在挂载之前先在 CPU 上检查这些 hook,请运行 python -m unittest scripts.test_router_watch scripts.test_expert_watch。
运行健康状况
Loss 与梯度信号
请把 LM loss 和梯度范数与路由器及专家的测量放在一起看。下列参数增加了运行级信号:
--log-throughput:训练吞吐。--log-params-norm:参数范数。--log-num-zeros-in-grad:模型梯度中零元素的个数。--log-max-attention-logit:最大的注意力 logit;需要 Transformer Engine 2.9 或更新版本。
要排查专家层面的下溢(3.7),请在累积之后、优化器更新之前,统计专家权重梯度中恰好为零的元素。把这个专家层面的计数与相同配置的 BF16 训练作比较。
NaN 检查默认开启。检测到 NaN 会停止该步并触发重跑处理(3.6);--no-check-for-nan-in-loss-and-grad 会关闭该检查。
耗时与显存
添加 --timing-log-level 2 --timing-log-option all 可获得每个 rank 的前向和反向耗时。按流水线 stage 对 rank 分组,以定位慢的 stage,包括持有 MTP 的那个(3.6)。然后用 3.7 中的工具对该 stage 做 profile。
请比较各次运行中同一段预热之后的区间。对于峰值显存,在区间开始时重置 CUDA 峰值统计,在结束时读取每个 rank 上的 torch.cuda.max_memory_allocated()。取各 rank 的最大值,作为所报告的最高峰值已分配显存。
A.2 调试索引
第 3 章是逐项设置展开的,从一个参数到它对训练的影响。当训练出问题时,你要反向而行:你在仪表盘上看到一个症状,需要找到背后的配置。本附录就是这个反向索引,每个症状一行,每行都指回文中解释它的部分。
不过在怪罪某个设置之前,请先用 2.5 末尾的两项检查排除软件栈本身的问题。
如何阅读索引
每一行带有一个标签、最先变化的信号对应的症状,以及要阅读的章节。标签按训练的失败方式对它们分类:slow、OOM、blows up、learns badly,以及 won't start(用于在第一次迭代之前就停止的训练)。找到你的标签,再找最先变化的信号,该行就会告诉你该去哪里;引言中的地图画出了这些行中除一行以外的全部,即 global_aux_loss 设置,它没有可供入手的信号。
调试索引,42 个症状
| 标签 | 症状 | 阅读 |
|---|---|---|
slow | 吞吐下降 | 3.3、3.7 profiling |
slow | 单节点一步中有一半是 all-to-all | 先看 3.3 均衡,再看 3.7 重叠 |
slow | 辅助损失接近 1,但某块 GPU 很慢 | 3.3 不均衡的代价(对于平坦的路由器概率,无论负载如何,辅助损失都等于 1;请读 MaxVio) |
slow, learns badly | 使用无损失偏置的训练在很多步之后仍不均衡 | 3.3 无损失偏置(固定步长滞后;分位数均衡) |
slow, learns badly | 少数专家只在前几层过载 | 3.2 哈希层,3.5 稠密层 |
slow | 每个 token 的 all-to-all 到达每一个节点 | 3.7 互联与分组受限路由 |
slow | 转向更多、更小的专家后吞吐下降 | 3.4 数量与大小 |
slow, OOM | 打开 MTP 后单步慢了很多,或在流水线并行下层数增多时 OOM | 3.6 MTP |
slow | profile 中 all-to-all 暴露在外 | 3.5 Block 连接、3.7 重叠 |
slow | 多节点在我们的 EP16 代理上慢约 25 倍,且 NCCL 日志显示“Using network Socket” | 3.7 互联 |
slow | 改用 global_aux_loss 后单步变慢 | 3.3 范围 |
slow | 使用分位数均衡时,每个全局 batch 的 MaxVio 低,而每个 micro-batch 的 MaxVio 高 | 3.3 分位数 |
slow | 使用 --moe-latent-size 后单步变慢 | 3.4 Latent MoE,来自两次 d × ℓ 投影和更小的专家 GEMM(3.4);LatentMoE 报告的吞吐是推理服务的,在并发为 1 时低 12% |
slow | 在路由 top-k 之上加入共享专家后推理变慢 | 3.4 共享专家 |
slow | 完整重计算仍然开着 | 3.7 显存 |
slow | 经过均衡、重叠和融合之后 TFLOP/s 仍然不足 | 3.7 精度 |
OOM | 某个 rank OOM | 3.3(不均衡)、3.7 显存 |
OOM | 峰值显存看起来正常,但某个 rank OOM | 3.7 显存(Megatron 只记录数据并行 rank 0) |
blows up | 出现 NaN,而之前没有任何指标变动(梯度范数、参数范数、z-loss 都很平稳) | 3.6 稳定性(没有警告;在另一块 GPU 上重跑可以区分是 GPU 故障还是可复现的 NaN) |
blows up | 同一个节点上两次退出码 16 | 3.6 稳定性(重跑需要一块不同的 GPU) |
blows up | Muon 训练在最初几步发散 | 3.6 优化器(更新缩放,--muon-extra-scale-factor) |
blows up | 尖峰之前 z-loss 或路由器 logits 攀升 | 3.1 精度(NaN 之前 z-loss 平稳则应转向 3.6 稳定性) |
blows up | 专家输出范数增长,或尖峰之前其最大值与中位数之比攀升 | 3.4 激活(clamp) |
blows up | 使用 latent MoE 时激活爆炸或出现尖峰 | 3.4 latent(上投影之前的 norm) |
blows up | NaN 之前几次迭代,梯度范数和负载均衡 loss 跳升 | 3.6 稳定性、3.3。我们的 7B-A1B |
blows up | 使用 Muon 时出现的 loss 尖峰,从附近的检查点恢复往往可以避免 | 3.6 优化器(bf16 下的正交化) |
learns badly | 训练-推理概率差距增大的同时,RL 奖励停滞或崩塌 | 4 RL 路由 |
learns badly | loss 平稳,但 MaxVio 或某个专家的输出范数偏离该层中位数(塌缩、死专家或流氓专家) | 3.6 稳定性、3.3 |
learns badly | top-k 权重全部相等(平坦门控) | 3.1 锐度 |
learns badly | 开着辅助损失却有死专家 | 3.3 辅助损失(系数太小) |
learns badly | 每个全局 batch 超过 256 个 micro-batch 时使用 global_aux_loss | 3.3 范围 参数(bf16 计数器) |
learns badly, blows up | 前几个 MoE 层出现路由塌缩或发散 | 3.5 稠密层 |
learns badly | 设置了容量因子,loss 落后于 dropless 训练 | 3.7 容量与副本(丢弃没有被记录 |
learns badly | 使用 Muon 时专家逐层塌缩 | 3.6 优化器 |
learns badly | 使用 --moe-router-pre-softmax(top-k 权重未重新归一化)时,loss 高于做了重新归一化的训练 | 3.1 输出缩放 |
learns badly | 专家没有按领域专门化 | 3.3 范围 |
learns badly | LM loss 随辅助损失系数上升 | 3.3 辅助损失 |
learns badly | 专家越小,loss 不再改善 | 3.4 数量与大小 |
learns badly | 用 expert choice 训练的模型在推理时路由不同 | 3.2 谁来选 |
learns badly | upcycle 得到的 MoE 在领先之后学得很慢 | 3.6 Upcycling |
won't start | --moe-use-upcycling 因“unexpected keyword argument 'model'”或缺失 pre_mlp_layernorm 键而失败 | 3.6 upcycling(两个上游 bug) |
won't start | 打开 --overlap-moe-expert-parallel-comm 后出现关于完整重计算的 assert | 3.7 重叠与显存 |
信号比症状更重要,因为同一个症状可能来自不同部分的原因。在我们的每次 NaN 之前,我们所盯着的信号(梯度范数、参数范数或 z-loss)都保持平稳,而我们追查到的那一个,诞生于 grouped 专家 GEMM 的反向传播中。对于这样的 NaN,Megatron 在另一块 GPU 上的重跑可以区分是 GPU 故障,还是数据或模型真的产生了 NaN(3.6 稳定性)。辅助损失接近 1 的慢步骤则会把你引向 MaxVio:Megatron 的辅助损失只要路由器概率平坦就等于 1,无论负载如何,所以单块过载的 GPU 可能躲在它的后面(3.3 不均衡的代价)。
- Julien Abadji, Marah Abdin, Connor Adams, Eric Alcaide, Mustafa Altun et al. (2026). Laguna M.1/XS.2 Technical Report. arXiv:2605.27605.
- Chandan Akiti, Ajay Modukuri, Murali Nandan Nagarapu, Gunavardhan Akiti, Haozhe Liu (2026). Nucleus-Image: Sparse MoE for Image Generation. arXiv:2604.12163.
- Weilin Cai, Juyong Jiang, Le Qin, Junwei Cui, Sunghun Kim et al. (2024). Shortcut-connected Expert Parallelism for Accelerating Mixture-of-Experts. arXiv:2404.05019.
- Jonathan Chang. Causal Routing Bias for Aux-Loss-Free MoE Training. blog.
- Yanbei Chen, Hanxian Huang, Ernie Chang, Jacob Szwejbka, Digant Desai et al. (2026). MobileMoE: Scaling On-Device Mixture of Experts. arXiv:2605.27358.
- Xing Chen, Hengshuai Yao (2026). Training-Free Halving of Activated Experts in Fine-Grained Mixture-of-Experts Models. arXiv:2609.04575.
- Zewen Chi, Li Dong, Shaohan Huang, Damai Dai, Shuming Ma et al. (2022). On the Representation Collapse of Sparse Mixture of Experts. arXiv:2204.09179.
- Aidan Clark, Diego de las Casas, Aurelia Guy, Arthur Mensch, Michela Paganini et al. (2022). Unified Scaling Laws for Routed Language Models. arXiv:2202.01169.
- Chenwei Cui, Rockwell Jackson, Benjamin Joseph Herrera, Ana María Tárano, Hannah Kerner (2026). Multi-Head LatentMoE and Head Parallel: Communication-Efficient and Deterministic MoE Parallelism. arXiv:2602.04870.
- Damai Dai, Chengqi Deng, Chenggang Zhao, R. X. Xu, Huazuo Gao et al. (2024). DeepSeekMoE: Towards Ultimate Expert Specialization in Mixture-of-Experts Language Models. arXiv:2401.06066.
- DeepSeek-AI. DeepSeek V4.1 Flash 大规模推理部署实践 (the DeepInfer release post). Zhihu.
- DeepSeek-AI. DeepSeek V4.1 Flash Inference Deployment Q&A. GitHub, deepseek-ai/DeepInfer.
- DeepSeek-AI. DeepInfer. GitHub.
- DeepSeek-AI, Aixin Liu, Bei Feng, Bin Wang, Bingxuan Wang et al. (2024). DeepSeek-V2: A Strong, Economical, and Efficient Mixture-of-Experts Language Model. arXiv:2405.04434.
- DeepSeek-AI, Aixin Liu, Bei Feng, Bing Xue, Bingxuan Wang et al. (2024). DeepSeek-V3 Technical Report. arXiv:2412.19437.
- DeepSeek-AI, Anyi Xu, Bangcai Lin, Bing Xue, Bingxuan Wang et al. (2026). DeepSeek-V4: Towards Highly Efficient Million-Token Context Intelligence. arXiv:2606.19348.
- DeepSeek-AI, Anyi Xu, B. Li, Bangcai Lin, Bing Xue et al. (2026). DeepSeek-V4.1-Flash: Pushing the Limits of KV Cache Compression. arXiv:2609.19969.
- Yonatan Dukler, Guihong Li, Deval Shah, Jiang Liu, Vikram Appia et al. (2025). FarSkip-Collective: Unhobbling Blocking Communication in Mixture of Experts Models. arXiv:2511.11505.
- Venmugil Elango, Nidhi Bhatia, Roger Waleffe, Rasoul Shafipour, Tomer Asida et al. (2026). LatentMoE: Toward Optimal Accuracy per FLOP and Parameter in Mixture of Experts. arXiv:2601.18089.
- Hugging Face (2025). The Smol Training Playbook.
- William Fedus, Barret Zoph, Noam Shazeer (2021). Switch Transformers: Scaling to Trillion Parameter Models with Simple and Efficient Sparsity. arXiv:2101.03961.
- Trevor Gale, Deepak Narayanan, Cliff Young, Matei Zaharia (2022). MegaBlocks: Efficient Sparse Training with Mixture-of-Experts. arXiv:2211.15841.
- GLM-5-Team, Aohan Zeng, Xin Lv, Zhenyu Hou, Zhengxiao Du et al. (2026). GLM-5: from Vibe Coding to Agentic Engineering. arXiv:2602.15763.
- Naibin Gu, Zhenyu Zhang, Yuchen Feng, Yilong Chen, Peng Fu et al. (2025). Elastic MoE: Unlocking the Inference-Time Scalability of Mixture-of-Experts. arXiv:2509.21892.
- Hongyi He, Zhenghao Lin, Xiao Liu, Peng Cheng, Yan Lu et al. (2026). Expert-Space Exploration in MoE Reinforcement Learning. arXiv:2609.13058.
- Jordan Hoffmann, Sebastian Borgeaud, Arthur Mensch, Elena Buchatskaya, Trevor Cai et al. (2022). Training Compute-Optimal Large Language Models. arXiv:2203.15556.
- Qingguo Hu, Zhenghao Lin, Ziyue Yang, Yucheng Ding, Xiao Liu et al. (2025). Sigma-MoE-Tiny Technical Report. arXiv:2512.16248.
- Ailin Huang, Ang Li, Aobo Kong, Bin Wang, Binxing Jiao et al. (2026). Step 3.5 Flash: Open Frontier-Level Intelligence with 11B Active Parameters. arXiv:2602.10604.
- Peijie Jiang, Yuqi Feng, Cunyin Peng, Qian Zhao, Jia Liu et al. (2026). PowLU: An Activation Function for Stable Pre-Training of LLMs. arXiv:2605.25704.
- Peng Jin, Zihan Qiu, Zekun Wang, Bo Zheng, Yang Xu et al. (2026). ID Balancing: Stable Training of Extremely Sparse MoE via PID-Based Load Control. arXiv:2609.39137.
- Marko Kojic, Ivan Bondyrev, Aral de Moor, Joseph Shtok, Petr Borovlev et al. (2026). Mellum2 Technical Report. arXiv:2605.31268.
- Aran Komatsuzaki, Joan Puigcerver, James Lee-Thorp, Carlos Riquelme Ruiz, Basil Mustafa et al. (2022). Sparse Upcycling: Training Mixture-of-Experts from Dense Checkpoints. arXiv:2212.05055.
- Jakub Krajewski, Marcin Chochowski, Daniel Korzekwa (2025). Scaling Fine-Grained MoE Beyond 50B Parameters: Empirical Evaluation and Practical Insights. arXiv:2506.02890.
- AWS Labs. awsome-distributed-ai, NCCL test recipes. GitHub.
- Tim Tsz-Kit Lau, Weijie Su (2026). Symmetry-Compatible Principle for Optimizer Design: Embeddings, LM Heads, SwiGLU MLPs, and MoE Routers. arXiv:2605.18106.
- Margaret Li, Sneha Kudugunta, Danielle Rothermel, Luke Zettlemoyer (2026). Slicing and Dicing: Configuring Optimal Mixtures of Experts. arXiv:2605.11689.
- Seng Pei Liew, Kenta Shinzato, Yuyang Dong (2026). Towards Principled Design of Mixture-of-Experts Language Models under Memory and Inference Constraints. arXiv:2601.08215.
- Junghwan Lim, Joon Son Chung, Sungmin Lee, Wai Ting Cheung, Gihun Cho et al. (2026). Motif 3: Technical Report. arXiv:2608.09119.
- Jingyuan Liu, Jianlin Su, Xingcheng Yao, Zhejun Jiang, Guokun Lai et al. (2025). Muon is Scalable for LLM Training. arXiv:2502.16982.
- Jiang Liu, Sudhanshu Ranjan, Prakamya Mishra, Yonatan Dukler, Gowtham Ramesh et al. (2026). Instella-MoE Technical Report. arXiv:2609.00791.
- Wenhan Ma, Hailin Zhang, Liang Zhao, Yifan Song, Yudong Wang et al. (2025). Stabilizing MoE Reinforcement Learning by Aligning Training and Inference Routers. arXiv:2510.11370.
- Niklas Muennighoff, Luca Soldaini, Dirk Groeneveld, Kyle Lo, Jacob Morrison et al. (2024). OLMoE: Open Mixture-of-Experts Language Models. arXiv:2409.02060.
- Pit Neitemeier, Jiaze Li, Alessio Serra, Philipp Scholl, Sohir Maskey (2026). Exact Quantile Balancing and Load-Error Injection for Mixture-of-Experts. arXiv:2609.28053.
- NVIDIA. enroot. GitHub.
- NVIDIA. nccl-tests. GitHub.
- NVIDIA. Megatron-LM PR #1913, feat(moe): Fine-grained activation offloading. GitHub.
- NVIDIA. DCGM Diagnostics. DCGM documentation.
- NVIDIA. pyxis. GitHub.
- NVIDIA, Felix Abecassis, Anjulie Agrusa, Dong Ahn, Jonah Alben et al. (2025). Pretraining Large Language Models with NVFP4. arXiv:2509.25149.
- NVIDIA, Aakshita Chandiramani, Aaron Blakeman, Abdullahi Olaoye, Abhibha Gupta et al. (2026). Nemotron 3 Super: Open, Efficient Mixture-of-Experts Hybrid Mamba-Transformer Model for Agentic Reasoning. arXiv:2604.12374.
- NVIDIA, Aaron Blakeman, Aaron Thomas, Aastha Jhunjhunwala, Abhibha Gupta et al. (2026). Nemotron 3 Ultra: Open, Efficient Mixture-of-Experts Hybrid Mamba-Transformer Model for Agentic Reasoning. arXiv:2606.15007.
- OpenAI, Sandhini Agarwal, Lama Ahmad, Jason Ai, Sam Altman et al. (2025). gpt-oss-120b & gpt-oss-20b Model Card. arXiv:2508.10925.
- Sungrae Park, Sanghoon Kim, Jungho Cho, Gyoungjin Gim, Dawoon Jung et al. (2026). Solar Open Technical Report. arXiv:2601.07022.
- Zihan Qiu, Zeyu Huang, Bo Zheng, Kaiyue Wen, Zekun Wang et al. (2025). Demons in the Detail: On Implementing Load Balancing Loss for Training Specialized Mixture-of-Expert Models. arXiv:2501.11873.
- Chengyu Qiu, Xiao Fu, Fengcun Li, Yulei Qian, Yuchen Xie et al. (2026). AFD-Ledger: Deployment Provisioning for Attention--FFN Disaggregation. arXiv:2608.04502.
- Zihan Qiu, Zekun Wang, Xiao Li, Yanpeng Li, Yang Xu et al. (2026). On the Design of Qwen3.8-Next Architecture: Evaluation, Efficiency, and Training Stability. arXiv:2608.30320.
- Stephen Roller, Sainbayar Sukhbaatar, Arthur Szlam, Jason Weston (2021). Hash Layers For Large Sparse Models. arXiv:2106.04426.
- Soumajyoti Sarkar, Yuxin Tang, Sheng Zha (2026). Compute-Optimal Is Not Cluster-Optimal: Systems-Aware Scaling for Sparse Mixture-of-Experts. arXiv:2608.10605.
- Noam Shazeer, Azalia Mirhoseini, Krzysztof Maziarz, Andy Davis, Quoc Le et al. (2017). Outrageously Large Neural Networks: The Sparsely-Gated Mixture-of-Experts Layer. arXiv:1701.06538.
- StepFun. Inside Step 5 Preview. blog.
- StepFun, Bin Wang, Bojun Wang, Changyi Wan, Guanzhe Huang et al. (2025). Step-3 is Large yet Affordable: Model-system Co-design for Cost-effective Decoding. arXiv:2507.19427.
- Manxi Sun, Wei Liu, Jian Luan, Pengzhi Gao, Bin Wang (2024). Mixture of Diverse Size Experts. arXiv:2409.12210.
- Hanchi Sun, Yixin Liu, Yonghui Wu, Lichao Sun (2026). Expert Threshold Routing for Autoregressive Language Modeling with Dynamic Computation Allocation and Load Balancing. arXiv:2603.11535.
- Yehui Tang, Yichun Yin, Yaoyuan Wang, Hang Zhou, Yu Pan et al. (2025). Pangu Ultra MoE: How to Train Your Big MoE on Ascend NPUs. arXiv:2505.04519.
- Yehui Tang, Xiaosong Li, Fangcheng Liu, Wei Guo, Hang Zhou et al. (2025). Pangu Pro MoE: Mixture of Grouped Experts for Efficient Sparsity. arXiv:2505.21411.
- Kimi Team. Kimi K3 tech report. GitHub, MoonshotAI/Kimi-K3.
- Meituan LongCat Team, Bayan, Bei Li, Bingye Lei, Bo Wang et al. (2025). LongCat-Flash Technical Report. arXiv:2509.01322.
- Ling Team, Ang Li, Ben Liu, Binbin Hu, Bing Li et al. (2025). Every Activation Boosted: Scaling General Reasoner to 1 Trillion Open Language Foundation. arXiv:2510.22115.
- Kimi Team, Tongtong Bai, Yifan Bai, Yiping Bao, M. C. et al. (2026). Kimi K3: Open Frontier Intelligence. arXiv:2607.24653.
- Xiaomi LLM-Core Team, Zongming Qiao, Ziyue Hua, Zirui Ou, Zihao Yue et al. (2026). MiMo-V2.6: Scaling Reinforcement Learning Towards Self-Improvement. arXiv:2610.11959.
- Changxin Tian, Kunlong Chen, Jia Liu, Ziqi Liu, Zhiqiang Zhang et al. (2025). Towards Greater Leverage: Scaling Laws for Efficient Mixture-of-Experts Language Models. arXiv:2507.17702.
- Aditya Vavre, Ethan He, Dennis Liu, Zijie Yan, June Yang et al. (2024). Llama 3 Meets MoE: Efficient Upcycling. arXiv:2412.09952.
- An Wang, Xingwu Sun, Ruobing Xie, Shuaipeng Li, Jiaqi Zhu et al. (2024). HMoE: Heterogeneous Mixture of Experts for Language Modeling. arXiv:2408.10681.
- Lean Wang, Huazuo Gao, Chenggang Zhao, Xu Sun, Damai Dai (2024). Auxiliary-Loss-Free Load Balancing Strategy for Mixture-of-Experts. arXiv:2408.15664.
- Haifeng Wang, Hua Wu, Tian Wu, Yu Sun, Jing Liu et al. (2026). ERNIE 5.0 Technical Report. arXiv:2602.04705.
- Tianwen Wei, Bo Zhu, Liang Zhao, Cheng Cheng, Biye Li et al. (2024). Skywork-MoE: A Deep Dive into Training Techniques for Mixture-of-Experts Language Models. arXiv:2406.06563.
- Haoyuan Wu, Haoxing Chen, Xiaodong Chen, Zhanchao Zhou, Tieyuan Chen et al. (2025). Grove MoE: Towards Efficient and Superior MoE LLMs with Adjugate Experts. arXiv:2508.07785.
- Weicheng Xue, Bingqiang Wang, Li Yuan, Huihui Zhou, Yonghong Tian (2026). TerraceMoE: A Cost Model for Hierarchical MoE All-to-All Communication. arXiv:2608.27874.
- Zijie Yan, Hongxiao Bai, Xin Yao, Dennis Liu, Tong Liu et al. (2026). Scalable Training of Mixture-of-Experts Models with Megatron Core. arXiv:2603.07685.
- An Yang, Anfeng Li, Baosong Yang, Beichen Zhang, Binyuan Hui et al. (2025). Qwen3 Technical Report. arXiv:2505.09388.
- YuanLab.ai, Shawn Wu, Jiangang Luo, Darcy Chen, Sean Wang et al. (2026). Yuan3.0 Ultra: A Trillion-Parameter Enterprise-Oriented MoE LLM. arXiv:2601.14327.
- Wuyue Zhang, Chongdong Huang, Chunbo You, Cheng Gu, Fengjuan Wang et al. (2026). Practical FP4 Training for Large-Scale MoE Models on Hopper GPUs. arXiv:2603.02731.
- Chujie Zheng, Shixuan Liu, Mingze Li, Xiong-Hui Chen, Bowen Yu et al. (2025). Group Sequence Policy Optimization. arXiv:2507.18071.
- Chujie Zheng, Kai Dang, Bowen Yu, Mingze Li, Huiqiang Jiang et al. (2025). Stabilizing Reinforcement Learning with LLMs: Formulation and Practices. arXiv:2512.01374.
- Yanqi Zhou, Tao Lei, Hanxiao Liu, Nan Du, Yanping Huang et al. (2022). Mixture-of-Experts with Expert Choice Routing. arXiv:2202.09368.
- Ruidong Zhu, Ziheng Jiang, Chao Jin, Peng Wu, Cesar A. Stuardo et al. (2025). MegaScale-Infer: Serving Mixture-of-Experts at Scale with Disaggregated Expert Parallelism. arXiv:2504.02263.
- Zhengyang Zhuge, Hao Yu, Xin Wang, Zheng Li, Yizhong Cao et al. (2026). QUADS: Stabilizing NVFP4 Reinforcement Learning for MoE via QUantization-error Alignment across Dual Sides. arXiv:2607.15810.
- Zhijian Zhuo, Ya Wang, Yutao Zeng, Xiaoqing Li, Xun Zhou et al. (2024). Polynomial Composition Activations: Unleashing the Dynamics of Large Language Models. arXiv:2411.03884.
- Barret Zoph, Irwan Bello, Sameer Kumar, Nan Du, Yanping Huang et al. (2022). ST-MoE: Designing Stable and Transferable Sparse Expert Models. arXiv:2202.08906.
代码、配置与数据
- An MoE in every layer, Qwen3-30B-A3B.
- Arcee AI, 2026, Arcee Trinity Large Technical Report, arXiv:2602.17004, §2.3.
- Artificial Analysis Intelligence Index v5.0.1, open-weights models.
- Cheng et al., 2026, Conditional Memory via Scalable Lookup, arXiv:2601.07372, §2.2 (suffix N-grams of canonical token ids, retrieved by hashing into embedding tables) and §2.3.
- Chitty-Venkata, Madireddy, Emani and Vishwanath, 2025, LExI: Layer-Adaptive Active Experts for Efficient MoE Model Inference, arXiv:2509.02753.
CohereLabs/North-Mini-Code-1.0.- datatrove,
src/datatrove/executor/base.pyL30. - DeepSeek-AI, 2025, DeepSeek-V3.2, arXiv:2512.02556.
- DeepSeek-AI, DeepEP README at tag v1.2.1.
- DeepSeek-V3
config.json. - DeepSeek-V4-Flash
config.json. - DeepSeek-V4-Pro Hub
inference/model.py,Gate(L546). - DeepSeek-V4-Pro's own inference code,
model.py#L556(hash routing whenlayer_id < n_hash_layers). - DeepSeek-V4.1-Flash on the Hub (rev 314113f),
inference/engram.py#L90. - DeepSeek-V4.1-Flash's own inference code,
model.py#L811(router GEMM in fp32, divided bygate_temp, 1.0 by default). - EMO, 2026, arXiv:2605.13247, §3.3.
- Expert Upcycling, 2026, arXiv:2604.19835, Definition 3.1.
- Expert Upcycling, arXiv:2604.19835, App. D, Tables 9 and 11.
- GLM-5.3 publisher
config.json. - Grok 2,
config.json. - Grok 2,
config.json. hf jobs hardware.hidden_act: siluwith gated experts in DeepSeek-V3.- Hub config.json
quantization_config,Qwen/Qwen3-30B-A3B-GPTQ-Int4. - Hub config.json
quantization_config,Zyphra/ZAYA1-8B-MXFP4-Experts. - Hugging Face Hub API,
api/models/meta-llama/Llama-3.2-1B. - Hugging Face, Jobs, Pricing and Billing.
- Hugging Face, Run and manage Jobs.
- Intern-S1-Pro, 2026, Intern-S1-Pro: Scientific Multimodal Foundation Model at Trillion Scale, arXiv:2603.25040, §2.1 Group Routing.
- Kimi K3
config.json. - Kimi K3's repo code,
modeling_kimi_linear.py#L707-L712(router GEMM in fp32, sigmoid). - Kimi K3's repo code,
modeling_kimi_linear.py#L724. - Kimi Team, 2026, Kimi K2.5: Visual Agentic Intelligence, arXiv:2602.02276.
- Kimi-VL-A3B-Instruct publisher
config.json. - LG AI Research, 2026, K-EXAONE 2.0 Technical Report, arXiv:2608.04505, §2.2 Training stability.
- LG AI Research, 2026, K-EXAONE 2.0 Technical Report, arXiv:2608.04505, §2.2.
- Liu et al. (Meituan LongCat), 2026, Scaling Embeddings Outperforms Scaling Experts in Language Models, arXiv:2601.21204, Fig. 2 and §3.2.1, 280M active parameters, 300B tokens.
- Liu et al. (Meituan LongCat), 2026, Scaling Embeddings Outperforms Scaling Experts in Language Models, arXiv:2601.21204, §6,
config.json. - MiMo-V2.6-Pro-RL publisher
config.json, text configuration. - MiMo-V2.6-Pro-RL's repo code,
modeling_mimo_v2.py#L155(router GEMM in fp32). mistralai/Mistral-Large-3-675B-Instruct-2512params.json.mistralai/Mixtral-8x7B-v0.1config.json.- Nakamura et al., 2025, Drop-Upcycling, arXiv:2502.19261, §5.
- Nemotron 3 Ultra publisher
config.json. - NVIDIA NeMo-RL at fb121a00,
examples/nemo_gym/nemotron-3-super/stage1_rlvr.yaml#L59-L61(async_grpo: enabled: true,max_trajectory_age_steps: 1). - Publisher configs (hidden size / routed expert width, experts / top-k),
config.json. - Publisher configs,
config.json. - PyTorch
torch.topkdocumentation. Qwen/Qwen3-Next-80B-A3B-Instructconfig.json.- Qwen3.5-397B
config.json. - Qwen3.8-2.4T-A95B publisher
config.json. - Qwen3.8-Flash-Next on the Hub (rev de4b8e4),
modeling_qwen4_exp.py#L1262. - Released weights, one tensor range-read per layer from each safetensors file, DeepSeek-V3-Base.
- Router GEMM cast to fp32 in inference code,
modeling_deepseek_v32.py#L512. - Step 5 Preview publisher
config.json, text configuration. - Step-5-Preview on the Hub (
stepfun-ai/Step-5-Preview, rev 364b3b0),inference/model.py#L2020-L2030. - Step-5-Preview on the Hub (
stepfun-ai/Step-5-Preview, rev 364b3b0),inference/model.py#L2021-L2025. - Su Jianlin, kexue.fm post 11619, "MoE环游记:6、最优分配促均衡".
- Su Jianlin, kexue.fm post 11848, "简单谈谈K3的MoE和Attention".
swiglu_limit: 10inai-sage/GigaChat3.5-432B-A28B.- Trackio
README.mdat 4bef24c. - transformers
cohere2_moeat main ff704ff,modeling_cohere2_moe.py#L150-L160. - transformers
gemma4at main ff704ff,Gemma4TextRouter,modeling_gemma4.py#L1323. - transformers
glm_moe_dsaat main ff704ff,modeling_glm_moe_dsa.py#L485. - transformers
inklingat main ff704ff,modeling_inkling.py#L360. - transformers
llama4at main ff704ff,modeling_llama4.py#L146-L148. - transformers
llama4at main ff704ff,modeling_llama4.py#L150. - transformers main at a96730c8,
qwen3_moe/modeling_qwen3_moe.py#L257-L264. - transformers
qwen4_expat main ff704ff,modeling_qwen4_exp.py#L964. - transformers
zayaat main ff704ff,modeling_zaya.py#L538. - TRL,
trl/trainer/grpo_config.pyat 3749f2a,importance_sampling_level. unsloth/Llama-4-Maverick-17B-128E-Instructconfig.json,text_config.- vLLM at 790be385,
vllm/config/parallel.py#L275-L276. - Wei et al., 2026, UltraEP, arXiv:2606.04101, §8.2 and Fig. 11 (training, resumed at global batch 3,500 for 20 more).
- Wu et al., 2024, DeepSeek-V, arXiv:2412.10302, §2.
- Xiaomi, 2026, MiMo-V2-Flash Technical Report, arXiv:2601.02780.
zai-org/GLM-4.5-Airconfig.json.- Zyphra, 2026, ZAYA1-8B Technical Report, arXiv:2605.05365, §II-A2.