Dyna-2.1:面向端到端工作流的物理智能体
通用机器人要真正有用,需要接管整条工作流,而不是频繁依赖人工介入。Dyna-2.1 推出我们的物理智能体:半人形机器人 Taku,以及一套借重人类经验、强化可教性的学习系统。
中文译本 · 原文 Dyna-2.1: A Physical Agent for End-to-End Workflows · 2026-09-29 · Dyna Robotics · 约 19 分钟 · 图/视频仍链向 dyna.co
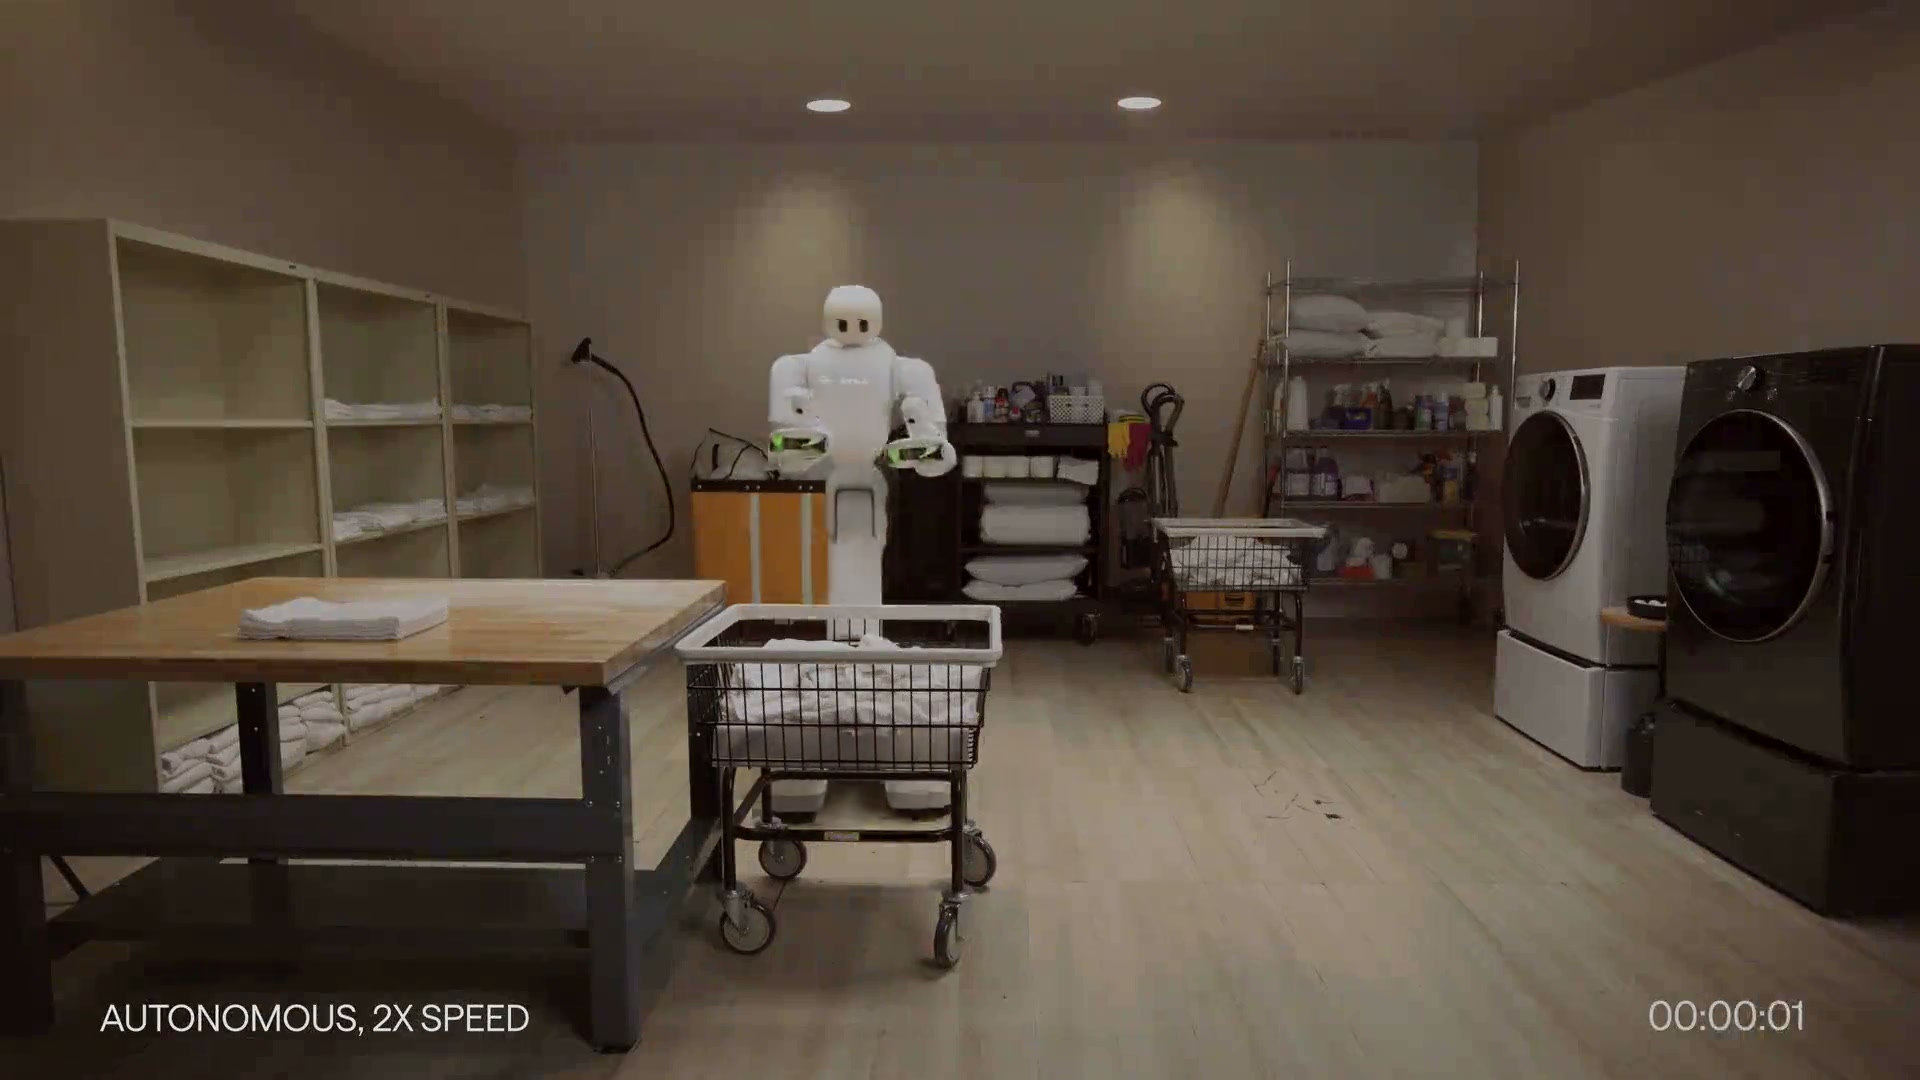
开篇。 Dyna-2.1:首个自动化端到端工作流的物理智能体——一小时全程无剪辑。完整一小时视频请在 原文 播放。
团队讨论。 听听团队如何讨论这些突破。
1. 通用机器人的价值在工作流,而不在单个任务
机器人基础模型在固定工位任务上已达到量产级表现,正如我们的 Dyna-1、Dyna-2 与部署相关发布所示 [1], [2], [3]。 尽管我们和其他团队都有令人鼓舞的进展,同等水平的性能与可靠性,在长时间运行的工作流上仍难以企及。 我们所说的工作流,是一套自洽的业务流程,允许不频繁、异步的交接:人把活交出去,走开,几小时后再回来看。能这样干活的机器人,几乎不需要盯着。
固定工位任务已经能跑,为什么还要关心工作流?作为产品,固定工位任务的根本局限是:多数情况下仍需要一个「机器人保姆」。 单个固定任务往往只是更大工作流里的一小段子步骤。例如,Dyna-1 在叠餐巾任务本身上曾 24 小时无干预 [1],但仍有人要不断往料箱里补餐巾、清空叠好的堆。没有这个人,料箱一空,工作流就停。 基于与大量客户的商业交流,我们逐渐认识到:客户买的是一个岗位,不是一个任务——机器人要在一个班次内接管整条工作流,而不需要旁边再站一个人托着。 换句话说,人们要的是能成为完整员工的机器人。
工作流要求机器人全栈能力同时解锁。仅举几项:
- 扩大工作空间:今天的工作流是人做的。机器人要覆盖该岗位的整个工作区,在每个工位上同时用底盘、躯干和双臂。
- 可教性:每个客户的工作流不同、会随时间变化,还把成百上千个子任务串起来,每个都要更高的可靠性(更多个 9)。 机器人必须从人类数据、仿真以及现场纠错中,快速学会新技能并做到可靠。
- 推理:工作流是非线性的,需要条件决策。
把这些能力一起解锁,已经不能指望「在受限硬件上部署单一动作模型」。我们必须从仔细的硬件设计一路做到稳健的策略学习,构建全栈物理智能体。
2. Dyna-2.1:引入物理智能体与 Taku 机器人
今天我们发布 Dyna-2.1:一个能自主完成端到端真实世界工作流的全栈物理智能体。 系统核心之一是全新的半人形机器人 Taku——名字来自日语「匠」(Takumi),意指精通技艺的工匠。
Dyna-2.1 兼容各类「移动 + 灵巧操作」工作流(例如服务器维护、取饮料),本文以酒店洗衣房工作流贯穿说明——商业洗衣是我们重点部署的垂类之一。 文首展示了 Dyna-2.1 自主执行、一小时无剪辑的完整洗衣房工作流。据我们所知,Dyna-2.1 是首个能完成小时级、非线性、移动灵巧操作工作流的物理智能体。
2.1 认识 Taku
可爱、能干、为真实工作而生:Taku 作为独一无二的物理智能体加入 Dyna 家族。 它腰部以上接近人体形态,下半身可折叠以够到低处与高处,四轮转向底盘异常稳定,并配备两只 7 自由度机械臂。
视频 2.1。 介绍 Taku。
在我们瞄准的工作流里,多数步骤需要的是到达范围与操作精度,而不是双腿,因此 Taku 靠轮子在工位间移动。 轮子之上,我们把 Taku 按普通人尺寸设计,使人的腕、肘、胸追踪姿态落在 Taku 可到达的附近。 为匹配人类动作速度,手臂采用低减速比行星执行器,比传统机械臂常用的谐波减速器能达到更高的速度与加速度。
视频 2.2。 跨工作空间的全身操作。自左上顺时针:深入烘干机、捡起毛巾、打开冰箱、把叠好的毛巾放到低架。
洗衣房说明了这具身体的用途。洗衣机、烘干机、折叠台和货架是相隔数米的独立工位,工作发生在各种高度: 探入约一臂深的烘干机滚筒、伸进洗衣机捞残留毛巾、腰部扭转搬运、蹲到最低层架或够到头顶以上的层架。 这需要移动灵巧操作——协调的全身运动与灵巧操作——对桌面双臂或「升降式」移动操作臂都很难。 Taku 的硬件让每个洗衣工位都在可达范围内(视频 2.2),兑现了第 1 节的第一项解锁;控制器再协调身体在这些工位上干活(第 3.1.2 节)。
2.2 物理智能体
够得到只是开始。要完成一个班次,机器人必须连续数小时可靠执行物理技能,并随着工作流展开决定下一步做什么。 当工作流视界达到小时量级时,这尤其困难。洗衣工作流说明了为什么两者都重要。除了够到每个工位,它还带来单任务没有的两个问题:
1. 一个班次会串起成百上千个子任务。 一小时内,小问题会发生很多次:一次抓取夹起两块毛巾、一角折进去了、一摞歪了。 有些错误会推翻前面的工作:掉落的毛巾要重新洗,掉落的一整摞则让其中每条毛巾都回到起点。 我们选择洗衣,部分因为大多数失败是可恢复的。但每次恢复都耗时,且每一步仍须避免不可恢复错误,于是逐步可靠性会复合。 若每步只有 95% 可靠,一个循环几乎永远无法无人协助地跑完(图 2.2)。
图 2.2 · 工作流可靠性。 给定逐步成功率时,整个循环无人协助跑完的概率。原文可拖动滑块(子任务数为估计值)。 在原文查看交互图
2. 它是非线性的。 毛巾从洗→烘→叠→码是线性进程,但机器人的路径不是(图 2.3)。每台机器按自己的时间表结束,闲置一台已完成的机器就是产能损失 [4]。因此折叠必须可中断:机器人一边折叠一边监控机器,某台一结束就去处理。 我们把一个循环拆成十三个决策点。其中若干依赖机器人几分钟甚至几小时前见过、此刻看不到的信息:洗衣机何时启动、哪一堆在哪台机器里、哪层架还有空位。
图 2.3 · 洗衣房工作流。 一个洗衣循环:机器人在长段移动灵巧操作之间做出的十三个决策。编排器按这些决策执行(第 3.2 节)。 在原文查看交互图
应对这些挑战,需要把机器人的「大脑」当作整体来设计。我们按决策的时间尺度、以及每种能力怎样学最高效来划分职责,让精确控制、可靠技能与工作流推理协同工作。 三层模型控制 Taku(图 2.4);第 3 节分别说明各层设计:
- 全身控制器:在仿真中用强化学习训练,把腕、肘、胸与足迹的任务空间目标轨迹 (统一机器人表示 URR;第 3.1.1 节)变成 100 Hz 的关节目标与轮速。
- Dyna-2 策略:我们 Dyna-2 世界—动作模型的改进版 [2],把当前步骤变成全身目标轨迹,交给全身控制器跟踪。
- 工作流编排器:一个视觉—语言模型,跟踪工作流、决定下一步,并引导 Dyna-2 执行。
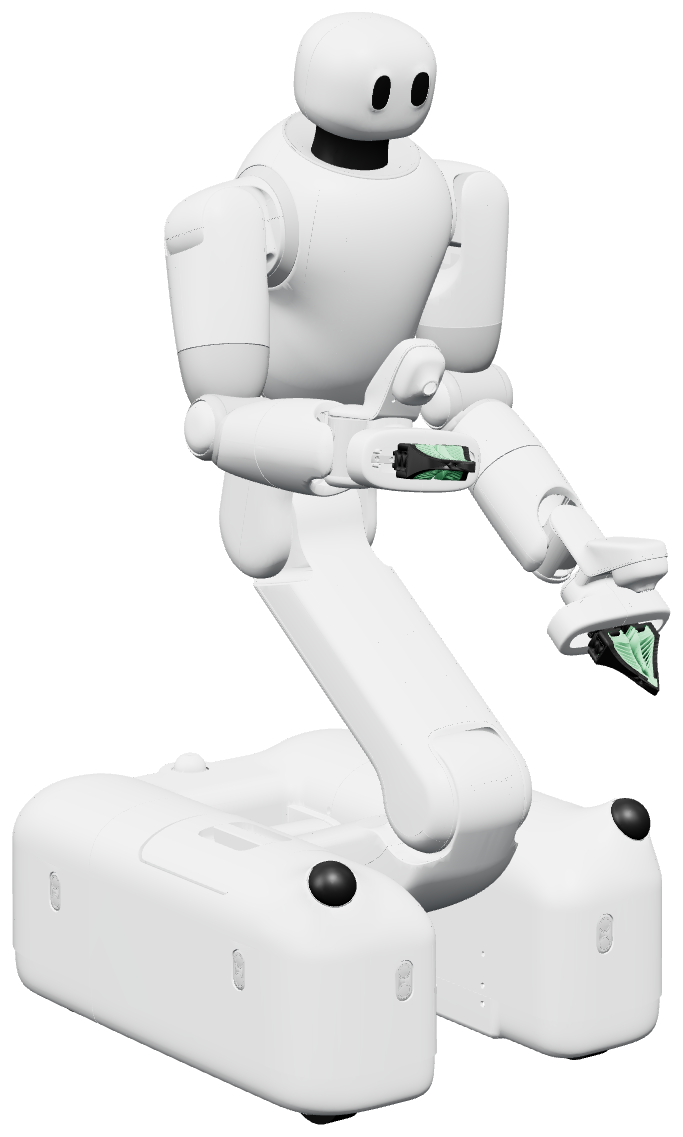
图 2.4。 物理智能体的组成。Taku 与三层模型,各自在自己的时钟上运行。人也可以产出 URR 目标轨迹,因此人类数据从策略命令进入的同一接口进来。
3. 构建物理智能体:全栈贡献
Taku 的硬件让工作落在可达范围内。接下来两节回应第 2.2 节的问题:第 3.1 节说明我们如何以低成本把物理技能教到足以串联的可靠度; 第 3.2 节说明机器人如何决定下一步。
3.1 可教性:用最便宜、仍能教会的数据学每项技能
可教性衡量的是:一项新技能、或某个客户的新流程,以多低的成本达到量产可靠性。 机器人数据是最稀缺的输入——它消耗机器人和操作员工时;每次硬件改版都会让旧数据变「不那么好用」,而人记录的经验却在持续增长。
我们的部署已经证明可教性的价值。在固定工位折叠部署中,新站点现在最快约三天就能达到量产门槛,而从前往往要数周到数月的现场工程 [3], [5]。 Dyna-2.1 更进一步:用远少于以往系统的示教数据,更快学会新技能。服务器维护与取饮料是两个近期例子。
学习新技能:服务器维护。
学习新技能:取饮料。
为提升 Dyna-2.1 的可教性,我们做了三项设计选择:
- 让人类数据对机器人可用(第 3.1.1 节):共享表示使人类录制可用于训练机器人。
- 训练最大化可教性的控制(第 3.1.2 节):控制器随每条示教变好,更好的控制器又录出更好的策略数据。
- 让旧机器人数据继续可用(第 3.1.3 节):硬件改版重训控制器,而不是改策略。
第 3.1.4 节汇总它们的结果:技能掌握,以及恢复掌握。
3.1.1 让人类数据对机器人可用
人类经验数据在快速增长。数据采集公司已大规模记录人做体力工作的过程——第一视角视频、动作捕捉、手持夹爪示教等 [6]。我们把 Taku 建成能跟随人类运动(第 2.1 节)。要从这些录制中学习,模型还需要人机共用的数据接口。
我们称该接口为统一机器人表示(Unified Robot Representation, URR)。 URR 用局部一致坐标系中的腕、肘、胸与足迹位姿描述身体(图 3.1)。人和机器人都能产出这些位姿,其二序列描述随时间的运动。URR 有三个性质:
- 与具身无关。同一格式可描述人、人形、半人形或桌面双臂机器人,按存在/观测到的部件增减组件。
- 抓住关键任务空间约束。这些位姿规定手的放置、手臂构型、躯干姿态以及身体在工作区中的位置——协调操作中最重要的空间约束。
- 在等价动作格式间无损。在保留参考系与起始位姿的前提下,可以从相对位姿等动作格式恢复所表示的组件位姿。
图 3.1 · URR 跟踪。 一次遥操作片段,从机器人日志回放。半透明目标为 URR 指令;实体机器人为全身控制器跟踪时的实测关节状态与里程计。原文可分层开关并拖拽环绕。 在原文查看交互图
训练时,我们把遥操作、第一视角录制与 UMI 数据 [7] 转成 URR,再编码进模型的动作表示;推理时,把模型动作解码回 URR 目标轨迹交给控制器(图 3.2)。 把人类运动转成 URR 是留在任务空间的重定向一步。多数全身遥操作栈会先把人类运动拟合到机器人关节,再交给跟踪控制器 [8], [9]。 对从视频学习而言,这种拟合可能把手从它碰过的物体上拉开,造成视频与动作标签不一致 [10]。 URR 把示教的任务空间运动保留为目标,把关节协调留给控制器。
遥操作也捕获机器人自身的可达范围与限制,并允许人接管以录制纠错。已有工作把任务空间策略与学习到的全身控制器配对 [11]。 我们增加的是所有这些来源共享的同一接口,同一接口也让人与模型来回交接控制权。
图 3.2 · 围绕 URR 的数据生命周期。 每个数据源以 URR 进入训练;推理时模型动作解码为控制器的 URR 目标轨迹。 在原文查看交互图
动作模型与 RL 控制器都在 URR 上的人类运动上训练。我们在一百万小时人类视频与机队机器人数据的混合上预训练改进版 Dyna-2 策略, 用从视频跟踪得到的全身 URR 位姿作为目标。这些目标已是策略在机器人上输出的格式,因此在机器人数据上微调时,主要只需教会策略 Taku 特有的身体。 人类视频还让策略见到机器人数据从未覆盖的毛巾、机器与房间。仅靠人类视频预训练已有回报:仅在人类视频上预训练的 Dyna-2,在未见过数据的站点、固定工位机器人上零样本通过了 87% 的客户验收测试,而 Dyna-1 为 46% [2]。
控制器(第 3.1.2 节)在仿真中复用这些运动录制作为跟踪目标。我们不为控制另采一套示教。 先前工作表明,跟踪人类动捕数据能教人形机器人自然的全身运动 [12];人的伸、倾、转也能迁移到轮式底盘。因此一条人类示教既教策略任务,也充当控制器的训练课程。
3.1.2 训练最大化可教性的控制
控制器与任务形成正循环:更多示教带来更好的控制器,更好的控制器录出更好的示教。
用人运动播种强化学习。 控制器在仿真中用强化学习学习平衡、姿态与运动跟踪——试错成本低(视频 3.3)。 我们不过度依赖探索与手工调奖励,而是动用庞大的 URR 数据库:把录制位姿目标与合成目标一起注入,为控制学习引入自然的人类姿态先验。 目标就是录制本身,因此控制器训练集随每条示教增长,每个新任务或操作员都会加入它要学会跟随的姿态。 经验上,增长的人类先验不仅加快收敛,还提高离线指标与遥操作测试中的控制质量。 控制器同时跟踪肘与胸以及手,因此在高架或低架上前臂能避开货架边或机门。 与逆运动学不同,它感知动力学、能容忍不可行命令,并在奖励权重中编码优先级(例如手精度高于胸精度)。 RL 全身控制已有充分研究 [12]–[16],但多面向腿式运动与不够精确的手臂;我们需要的是在要频繁迭代的硬件上做精确操作。 我们对连杆质量、关节摩擦与阻尼、执行器增益与延迟做随机化,以缩小与真机差距。
视频 3.3。 大规模训练的控制器。数千台仿真 Taku 在 NVIDIA Isaac Lab 中并行训练。
为模仿调控制器。 闭环通过策略闭合:每条示教都经控制器录制,因此更好的控制器为策略产出更平滑、更灵敏、更高质量的运动。 总跟踪误差相同的两种响应可以行为迥异:一种超调并振荡,另一种平滑逼近(图 3.4)。 我们发现振荡对策略学习一贯有害,因此「无振荡」是硬要求;这与 Tune to Learn [17] 一致——行为克隆受益于过阻尼增益,因为阻尼会在策略的小动作误差变成大偏差之前将其耗散掉。
图 3.4 · 过阻尼与欠阻尼。 15 cm 手部位移、总跟踪误差相同:欠阻尼超调并振铃,过阻尼永不越过目标。响应为构造示意。 在原文查看交互图
3.1.3 让旧机器人数据继续可用
只有早期数据继续「算数」,教学才会复合,因此机器人数据必须活得比录制它时的硬件与控制器更久。 尤其重要的是:我们把硬件研究当作持续迭代。关节级运动与限位留给控制器,于是硬件改版意味着在仿真中重训控制器、不占真机时间,而不是改策略的动作空间。
稳定的动作空间并不能消除控制动力学差异。每条示教都带着录制它的控制器动力学。我们的机器人数据跨越数代硬件与控制器,同一命令经 RL 控制器与逆运动学基线会产生不同运动。我们从两方面处理这些差异:
- 显式控制器条件化。 我们基于 Dyna-2 的语言可引导性 [2] ,让策略学会各控制器的特性。元数据提示告诉 Dyna-2 策略每条机器人示教经过哪个控制器,于是一个检查点学会各控制器如何动,并能引导到部署所用的那一个。
- 异步推理中的隐式上下文。 我们还在异步推理时对未来命令做条件化。命令上下文提供关于控制器动力学的隐式信息,补充显式控制器元数据。
3.1.4 结果:通用物理能力与恢复
廉价教学有两面回报。第一是通用能力。同一教学配方可跨越差异很大的任务,各自对全身灵巧与精度有不同要求(视频 3.5)。
视频 3.5。 跨任务的物理技能。自左上顺时针:按按钮、把叠好的毛巾放到高架、插入服务器、拾取洗衣凝珠。
第二是可靠性。图 2.2 显示工作流有多「不原谅」:一个洗衣循环约串起 79 步,逐步 95% 时几乎永远无法无人协助跑完。 没有策略能步步正确,弥合差距的是恢复,且必须一步步教恢复。第 3.1.1–3.1.3 节正是让这变得负担得起的原因。 视频 3.6 展示 Taku 从外部干扰与自身失误中自主恢复。
视频 3.6。 操作不如预期时的鲁棒性。两段均为自主、1× 速度。一段:Taku 开洗衣机时被人拨乱旋钮并把夹爪从按钮拉开,它回到面板并设好正确程序。另一段:从「一次抓两块毛巾」场景中恢复。
3.2 推理:运行工作流的编排器
Ling Li、Ming Qin 与 Chet Bhateja 讨论推理与语言跟随的设计,穿插推理系统引导机器人走完工作流的画面。
我们用视觉—语言编排器做出图 2.3 中的决策,并引导 Dyna-2 策略执行每一步。许多决策依赖它几分钟或几小时前观察到的内容。
3.2.1 建立在视觉—语言模型之上
编排器建立在对多样文本与图像预训练的视觉—语言模型上,因此一开始就对「洗衣房是干什么的」有一般理解;我们再按该工作流的分支(图 2.3)做后训练。 人也可以给它短指令,它会扩成策略可执行的步骤,因此客户流程的部分变更不需要新示教。 编排器以较低频率运行,策略继续执行当前步骤,因此我们可以换入更大、更慢的视觉—语言模型而不改下层。 其决策可比策略花更久,于是每一步能用更多上下文(如文本记忆与人工指令)与更多推理时间。
3.2.2 理解环境并选择下一步
编排器持续监控房间与进行中的任务。在图 2.3 的每个分支——例如装/卸哪台机器、一摞毛巾是否够码架——编排器选择下一步并引导策略执行(视频 3.7)。
视频 3.7。 从折叠转向卸烘干机。Taku 暂停折叠去处理烘干机,随工作流变化调整下一步。
折叠内部的检查留给策略:它在当前任务结束前准备下一任务,并在继续前确认每步完成(图 3.8)。 检查失败时,它决定接下来做什么:重复该步、换种方式,或改计划。恢复步骤仍由策略执行(第 3.1.4 节)。
图 3.8 · 编排器在工作。 上:循环。下:一个班次的示意片段,每行一个决策。 在原文查看交互图
3.2.3 长期记忆
控制器与 Dyna-2 策略学习的是通用技能,但没有数据集装着「今天这间房发生了什么」。 编排器从视觉跟踪进度,并压缩成以文本保存的长期记忆:哪些步骤完成了、每台洗/烘干机门开还是关、已叠多少毛巾、哪台机器在跑。 编排器记录 Taku 已叠多少毛巾,因此在完成洗/烘任务后,Taku 能从中断处接着叠。它把这段历史变成下一步。
4. 展望
我们介绍了 Dyna-2.1:首个能完成小时级端到端工作流的物理智能体。我们在硬件、控制器与分层策略设计上协同优化,才得到当前结果。 下一里程碑是把这套全新系统带到真实客户现场,建立部署飞轮——每一份部署数据都改进整套系统。 长期愿景是构建自改进物理智能体:既能吸收大量多样数据,又能用自身经验改进自己。
随着模型与智能体越来越强,机器人学习的标准评测指标开始测不到真正重要的东西。 当模型刚能勉强工作时,「基准任务上的每回合成功率」有信息量;但它说不清同一个模型能否被独自留下完成一个班次。 我们应当衡量:模型能在无任何干预的情况下处理多长的工作流。 语言智能体世界里有一个接近的类比:2025 年 3 月,METR 发表《Measuring AI Ability to Complete Long Tasks》 [18],论证基准准确率已不再说明 AI 系统真正能做什么,并提出替代指标: 50% 任务完成时间视界——以人类专家完成该任务所需时间为尺度,模型有一半概率成功的任务长度。 对物理 AI 而言,Dyna-2.1 只是开始。
参考文献
- Dyna Robotics. Dynamism v1 (Dyna-1) Model: A Breakthrough in Performance and Production-Ready Embodied AI. dyna.co/research/dyna-1, 2025 年 6 月.
- Dyna Robotics. Dyna-2: A 1-Million-Hour Scaling Law for World-Action Models. dyna.co/dyna-2, 2026 年 8 月.
- Dyna Robotics. Not Just a Model, But a Product. dyna.co/research/scaling-customer-deployments, 2026 年 8 月.
- Hietpas. Hotel Laundry Can Maximize Effectiveness with Right Equipment Mix (Part 1 of 2). American Laundry News, 2011 年 9 月. americanlaundrynews.com.
- Dyna Robotics. What 10 Months in Production Taught Us About the Robotics “Bubble”. dyna.co/news/robotics-bubble, 2026 年 5 月.
- Build AI. Egocentric-10K and Egocentric-100K datasets. huggingface.co/datasets/builddotai/Egocentric-100K, 2025.
- Chi et al. Universal Manipulation Interface: In-The-Wild Robot Teaching Without In-The-Wild Robots. Project page, 2024.
- Araujo et al. Retargeting Matters: General Motion Retargeting for Humanoid Motion Tracking. arXiv:2510.02252, 2025.
- He et al. OmniH2O: Universal and Dexterous Human-to-Humanoid Whole-Body Teleoperation and Learning. arXiv:2406.08858, 2024.
- Yang et al. OmniRetarget: Interaction-Preserving Data Generation for Humanoid Whole-Body Loco-Manipulation and Scene Interaction. arXiv:2509.26633, 2025.
- Ha et al. UMI on Legs: Making Manipulation Policies Mobile with a Manipulation-Centric Whole-body Controller. Project page, 2024.
- Luo et al. SONIC: Supersizing Motion Tracking for Natural Humanoid Whole-Body Control. Science Robotics 11(117), 2026. arXiv:2511.07820.
- Liu et al. Visual Whole-Body Control for Legged Loco-Manipulation. arXiv:2403.16967, 2024.
- Li et al. AMO: Adaptive Motion Optimization for Hyper-Dexterous Humanoid Whole-Body Control. arXiv:2505.03738, 2025.
- Ben et al. HOMIE: Humanoid Loco-Manipulation with Isomorphic Exoskeleton Cockpit. arXiv:2502.13013, 2025.
- Xue et al. LeVERB: Humanoid Whole-Body Control with Latent Vision-Language Instruction. arXiv:2506.13751, 2025.
- Bronars, Park and Agrawal. Tune to Learn: How Controller Gains Shape Robot Policy Learning. arXiv:2604.02523, 2026.
- Kwa et al. Measuring AI Ability to Complete Long Software Tasks. NeurIPS 2025; arXiv:2503.14499 (2025 年 3 月首发为 “Measuring AI Ability to Complete Long Tasks”)。见 METR 博客摘要。