用低成本硬件学习精细双臂操作
中文译本 · 原文 arXiv 2304.13705 · PDF 下载 · 项目站 tonyzhaozh.github.io/aloha · 工程落地见 LeRobot ACT 入门
摘要
穿扎带、装电池这类精细操作对机器人很难:需要高精度、仔细协调接触力,以及闭环视觉反馈。 传统做法往往依赖高端机械臂、精密传感器或仔细标定,昂贵且难搭。 学习能否让低成本、不精确的硬件也能完成精细操作? 本文给出一套低成本系统:用定制遥操作接口采集真实示教,再做端到端模仿学习。 模仿学习在高精度场景也有问题——策略误差会随时间累积,人类示教还可能非平稳。 为此我们提出简洁却新颖的算法 Action Chunking with Transformers(ACT):对动作序列学习生成模型。 ACT 使机器人在真实世界学会 6 个困难任务(如打开半透明酱料杯、装入电池),成功率约 80–90%,示教仅约 10 分钟。
一、引言
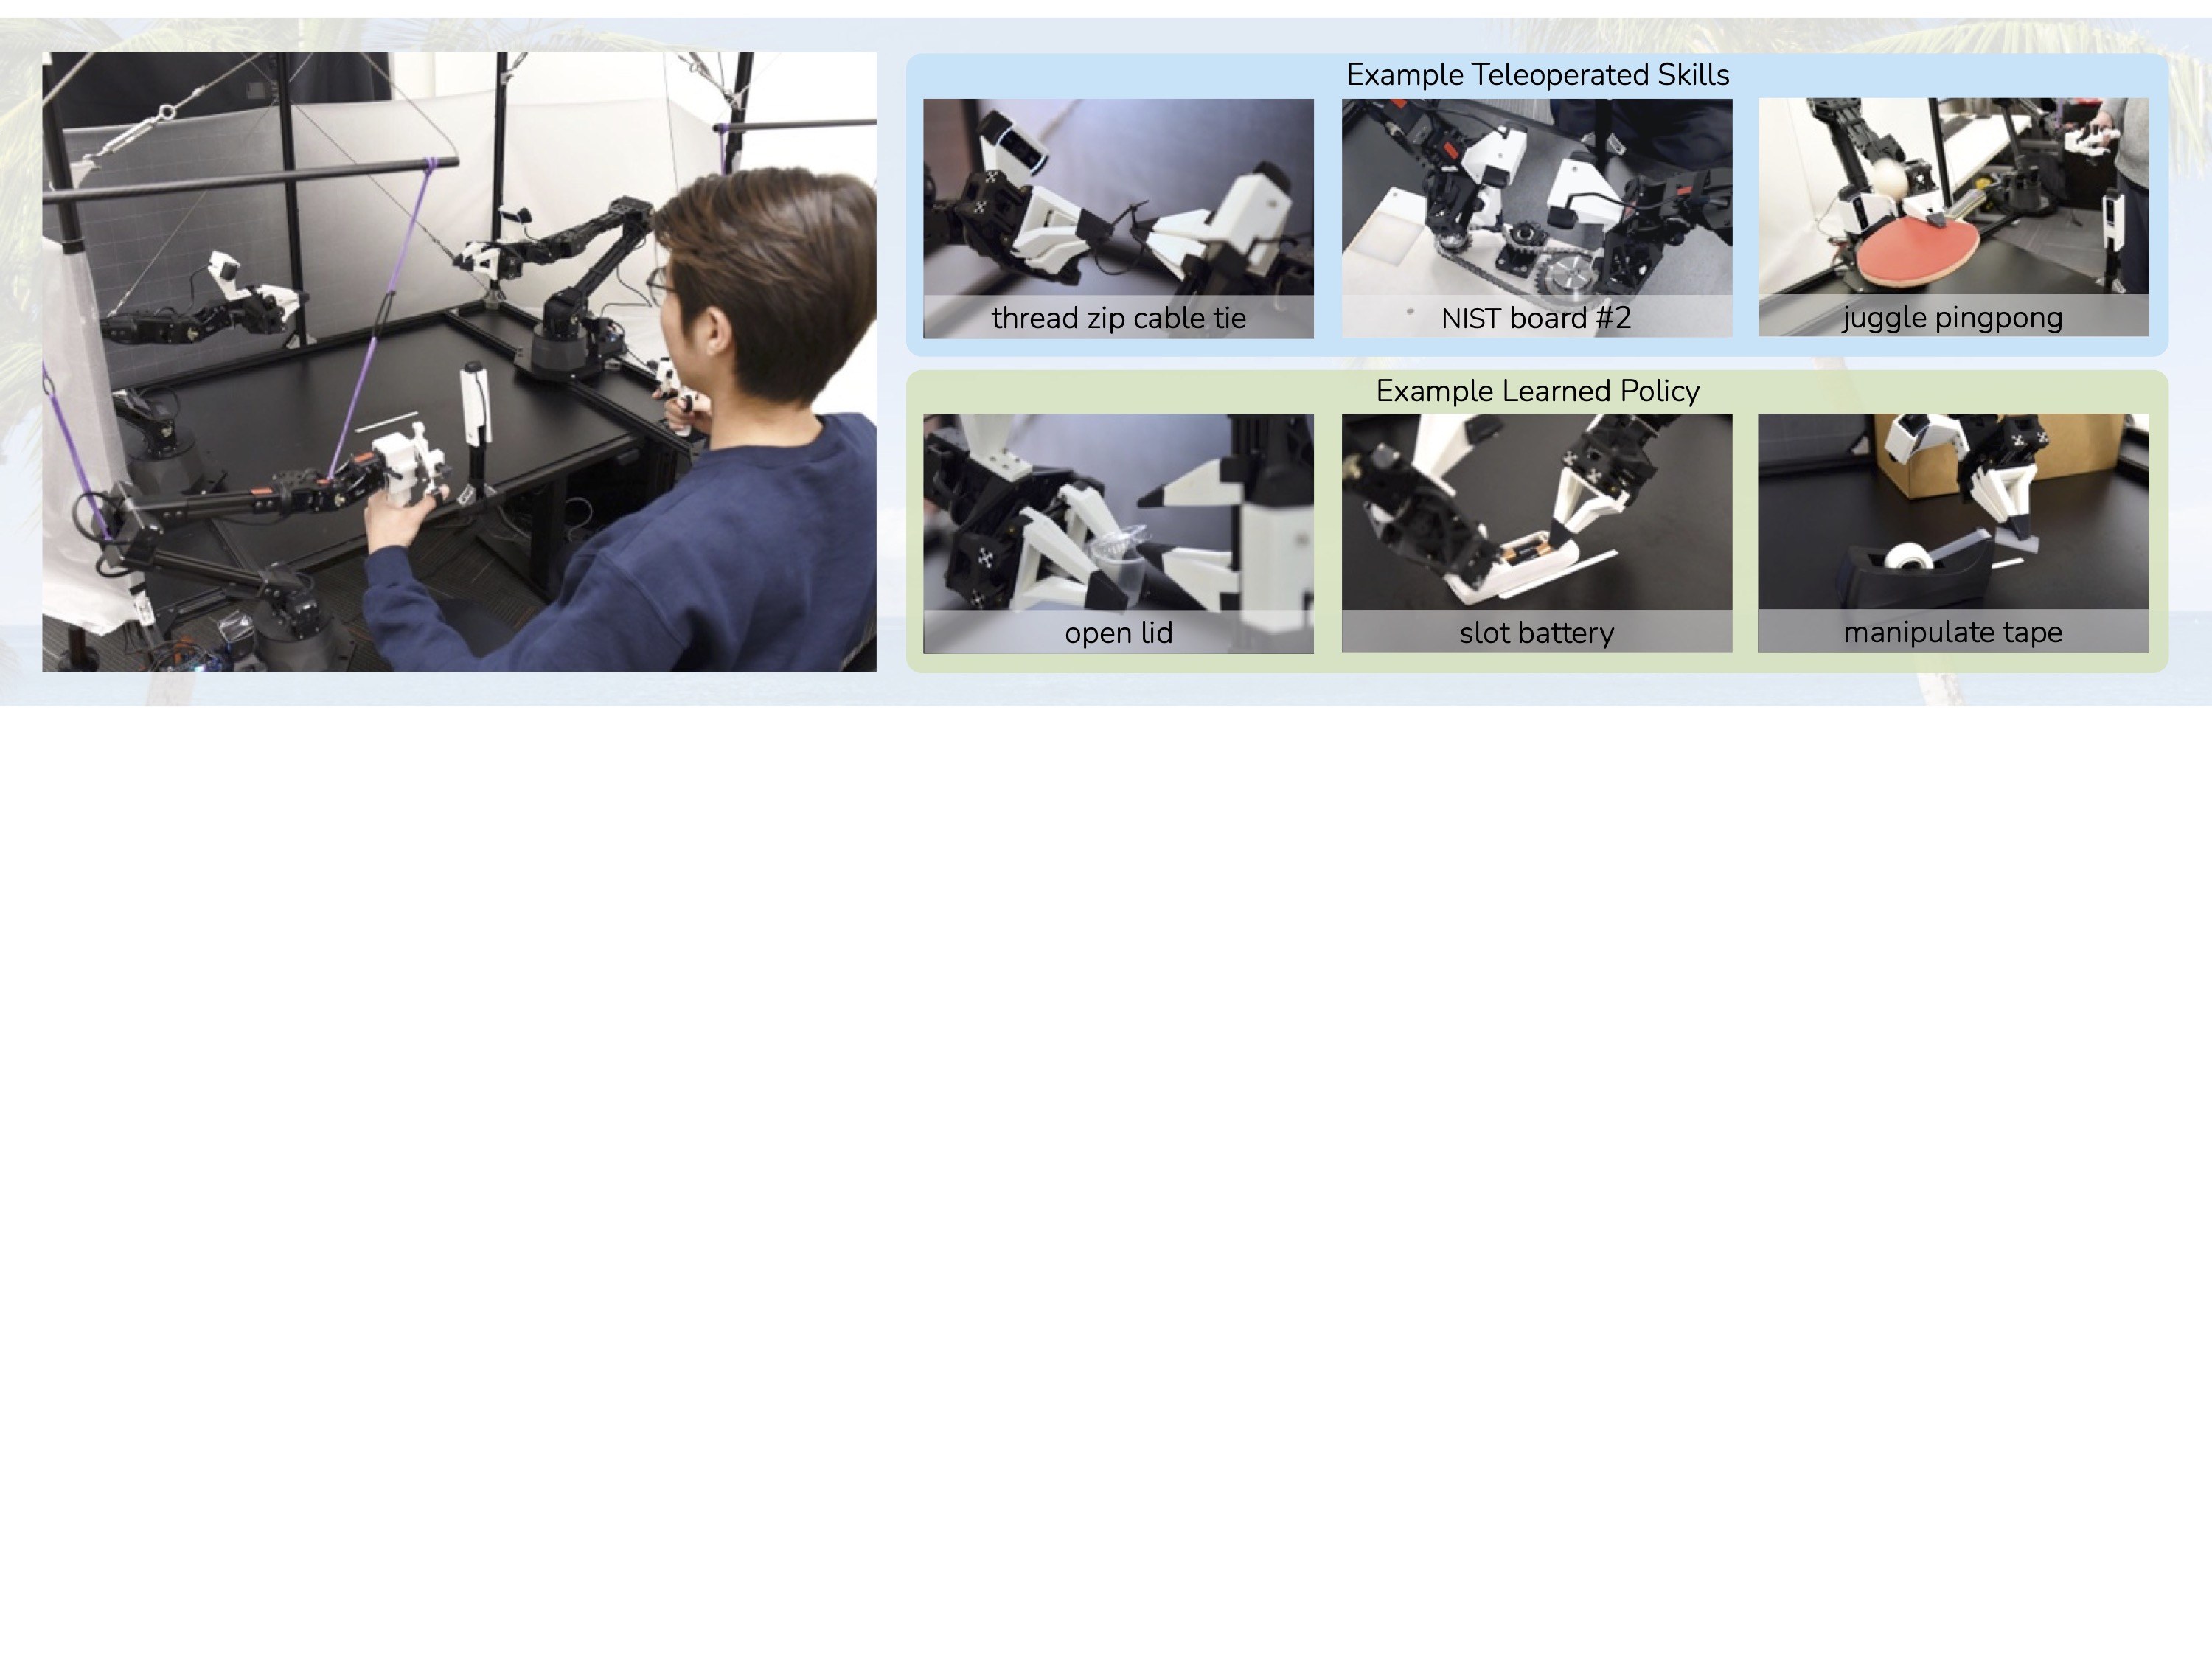
精细操作依赖精确的闭环反馈与高度眼手协调,才能随环境变化调整与重规划。 典型例子包括打开酱料杯盖、把电池推进卡槽——需要捏、撬、撕,而不是粗粒度的抓取放置。 以图 1 中酱料杯为例(杯初始直立于桌面):右夹爪先把它点倒,再推进已张开的左夹爪;左夹爪轻合并抬起; 右指再从下方接近并撬开盖子。每一步都要高精度、细腻协调与丰富接触,毫米级误差即可失败。
既有精细操作系统多用昂贵机器人与高端传感做精确状态估计。本文希望做一套低成本、可复现的系统。 但低成本硬件精度必然更差,感知与规划更难。一个有希望的方向是把学习做进系统: 人类也没有工业级本体感觉,却能靠闭环视觉反馈学习精细任务并主动补偿误差。 因此我们训练端到端策略:直接把普通网络摄像头的 RGB 映射到动作。 这种「像素→动作」对精细操作特别合适——物体物理往往很复杂,学策略常比建完整环境模型简单得多。
端到端策略的表现高度依赖数据分布;高质量人类示教能把人的灵巧性带进系统。 于是我们搭了低成本却灵巧的遥操作系统采数,并提出能有效利用这些示教的新模仿学习算法。
遥操作系统。两套低成本现成机械臂近似按比例,用关节空间映射遥操作; 再加 3D 打印件便于反驱,在约 $20k 预算内得到能力很强的系统。 图 1 展示了穿扎带(精确)、乒乓球颠球(动态)、NIST board #2 链条装配(接触丰富)等能力。
模仿学习算法。需要精度与视觉反馈的任务对模仿学习仍很难:预测动作的小误差会造成大状态偏差,加剧「误差累积」。 我们受心理学 action chunking(动作组块)启发:策略预测未来 \(k\) 步目标关节角,而不是单步。 有效视界缩短 \(k\) 倍,减轻累积误差;预测序列也有助于处理时间相关混淆(如示教中的停顿)。 为更平滑,提出 temporal ensembling:更频繁查询策略,并对重叠 chunk 加权平均。 用 Transformer 实现,并以条件 VAE(CVAE)训练以刻画人类数据的多样性,命名为 ACT。
本文贡献是一套低成本精细操作系统:遥操作 + 新算法。 二者协同,可在真实世界直接学会 6 项精细技能(打开半透明杯、装电池等),约 50 条 / 10 分钟示教即可达约 80–90% 成功率。
二、相关工作
机器人操作的模仿学习。行为克隆(BC)把模仿当作观测→动作的监督学习;后续工作用历史、不同目标、正则、多任务 / few-shot、语言或任务结构等改进; 规模化后可泛化到新物体与场景。本文聚焦低成本却能精细操作的系统,从硬件与算法两侧推进。
缓解误差累积。BC 的主要短板是误差累积导致偏离训练分布。DAgger 等需在线交互与专家纠正,遥操作下成本高; 采集时注入噪声对精细任务易直接失败。我们换角度:用动作组块缩短有效视界,并对重叠预测做集成,得到既准又平滑的轨迹,且兼容高维视觉观测。
双臂操作。从经典控制到 RL、模仿、关键点链式原语都有大量工作;部分精细任务用达芬奇、ABB YuMi 等昂贵平台。 本文转向约 $5k / 臂的低成本硬件,并尽量只用现成臂 + 少量 3D 打印件,非专家约 2 小时可组装。
三、ALOHA:低成本开源双臂遥操作
设计原则:低成本、通用、好用、可修、易搭。据此选用两台 ViperX 6-DoF 平行夹爪臂(不采用灵巧手,因价格与维护)。 ViperX 有效负载 750g、跨度约 1.5m、精度约 5–8mm,Dynamixel 电机易更换,现货约 $5600。 OEM 手指不够精细,我们设计「透视」3D 打印指 + 防滑胶带,兼顾可见性与对薄膜的抓取。
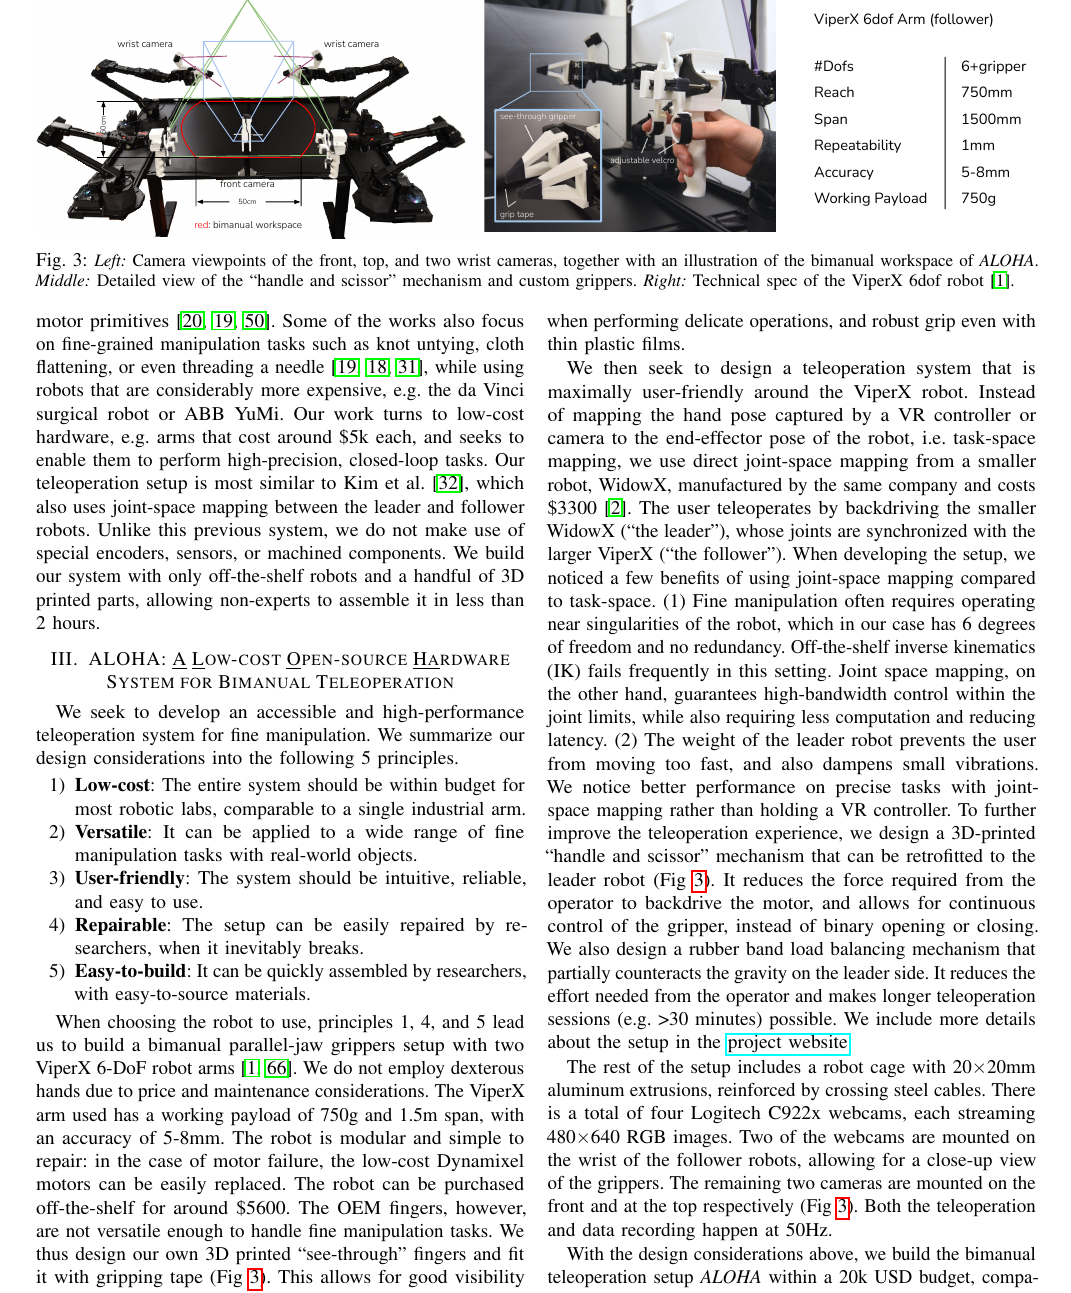
遥操作不用 VR 任务空间映射,而用同厂更小的 WidowX(约 $3300)做关节空间映射:反驱 leader,follower 同步。 好处包括:(1) 精细操作常靠近奇异点,现成 IK 易失败,关节映射带宽高、延迟低; (2) leader 自重限制过快运动并阻尼微振,比手持 VR 手柄更稳。 另设计「手柄 + 剪刀」机构减轻反驱力、支持连续夹爪控制,以及橡皮筋重力补偿以支撑 >30 分钟示教。 机架用铝型材 + 钢索加固;四路 Logitech C922x(480×640 RGB),两路腕部近景,前视与俯视各一;遥操作与录制均为 50Hz。
整套 ALOHA 预算约 $20k,可遥操作:穿扎带 / 取卡 / 开合密封袋(精确);插 288-pin 内存 / 翻书 / NIST 链条皮带(接触); 乒乓球颠球与空中甩袋(动态)等。软硬件与教程开源见项目站。
四、Action Chunking with Transformers
既有模仿算法在需要高频控制与闭环反馈的精细任务上表现较差。ACT 流程:用 ALOHA 采人类示教; 动作取 leader 关节角(力通过 leader/follower 差经底层 PID 隐式体现); 观测为 follower 关节角 + 四路图像。策略预测未来若干步目标关节角,由电机高频 PID 跟踪。 测试时加载验证损失最低的策略;核心挑战仍是误差累积。
4.1 动作组块与时间集成
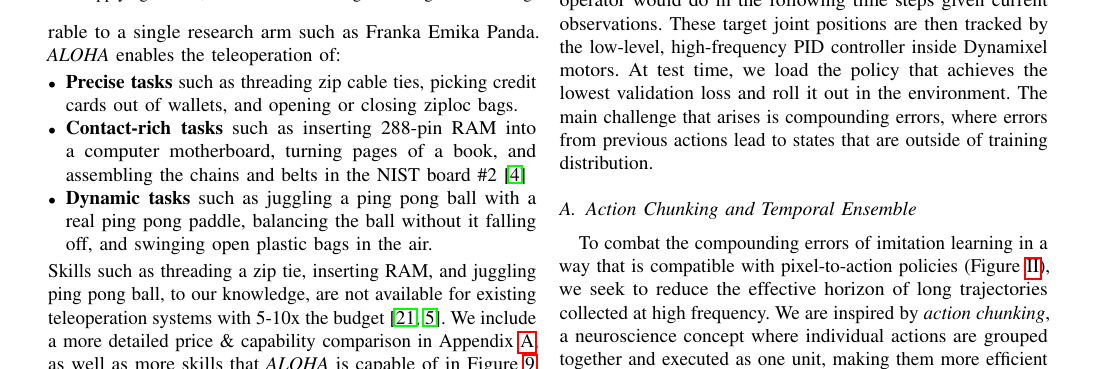
受 action chunking 启发:固定 chunk 长度 \(k\),每 \(k\) 步观测一次、生成 \(k\) 个动作并顺序执行,有效视界缩短 \(k\) 倍,即建模 \(\pi_\theta(a_{t:t+k}|s_t)\) 而非 \(\pi_\theta(a_t|s_t)\)。 组块也有助于建模非马尔可夫示教(如中途停顿)。朴素实现会每 \(k\) 步突然切换观测,运动易顿挫; 因此每步都查询策略,让 chunk 重叠,再用指数权重 \(w_i=\exp(-m\cdot i)\) 对同一时刻的多个预测做加权平均(temporal ensemble)。 注意是对同一时刻的预测集成,而非相邻时刻动作平滑,因而偏差更小;几乎无额外训练成本。
4.2 建模人类数据
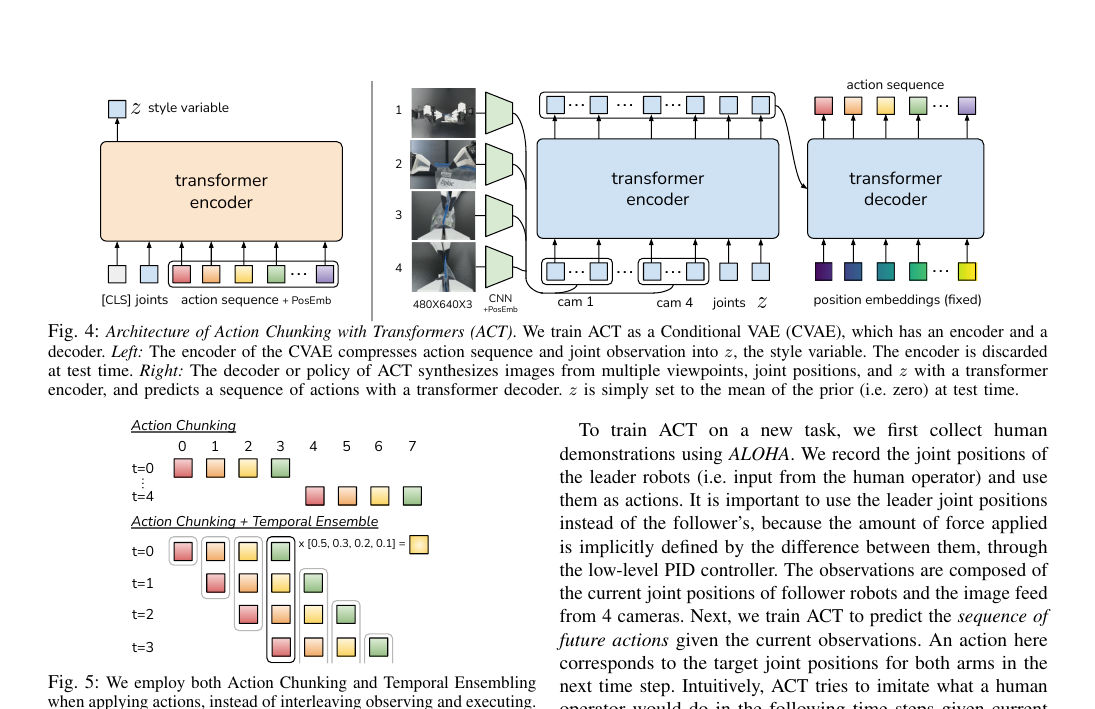
同一观测下人类轨迹多样,且在精度要求低的区域更随机。将策略作为 CVAE:编码器由动作序列与本体感觉预测 \(z\)(对角高斯), 解码器(策略)条件于 \(z\) 与完整观测生成动作序列;测试时 \(z=0\)。目标为重构损失 + \(\beta\) 加权的 KL 正则。 实践中发现 CVAE 对从人类示教学精细任务至关重要。
4.3 实现细节
CVAE 编码器为类 BERT Transformer;解码器用 ResNet18 处理四路 480×640 图 → 各 15×20×512,展平加 2D 正弦位置编码后共 1200×512, 再拼关节与 \(z\) 共 1202×512 进 Transformer encoder;decoder 以固定位置编码为 query、encoder 输出为 K/V,输出 \(k\times 14\) (双臂绝对关节目标)。重构用 L1(比 L2 更利于精确建模);约 80M 参数,单任务从零训练,2080 Ti 约 5 小时,推理约 0.01s。
算法 1 · ACT 训练
输入:示教集 D,chunk 大小 k,权重 β
初始化编码器 q_φ(z | a_{t:t+k}, ō_t),解码器 π_θ(â_{t:t+k} | o_t, z)
重复:
  从 D 采样 o_t, a_{t:t+k}
  从 q_φ 采样 z;由 π_θ 预测 â
  L_reconst = MSE(â, a);L_reg = KL(q_φ || N(0,I))
  用 ADAM 更新:L = L_reconst + β L_reg

算法 2 · ACT 推理
输入:训练好的 π_θ,episode 长度 T,权重 m
初始化 FIFO 缓冲 B[0:T]
对 t = 1..T:
  以 z=0 预测 â_{t:t+k},写入 B[t:t+k]
  对 B[t] 中多条预测做指数加权平均得到 a_t 并执行
五、实验
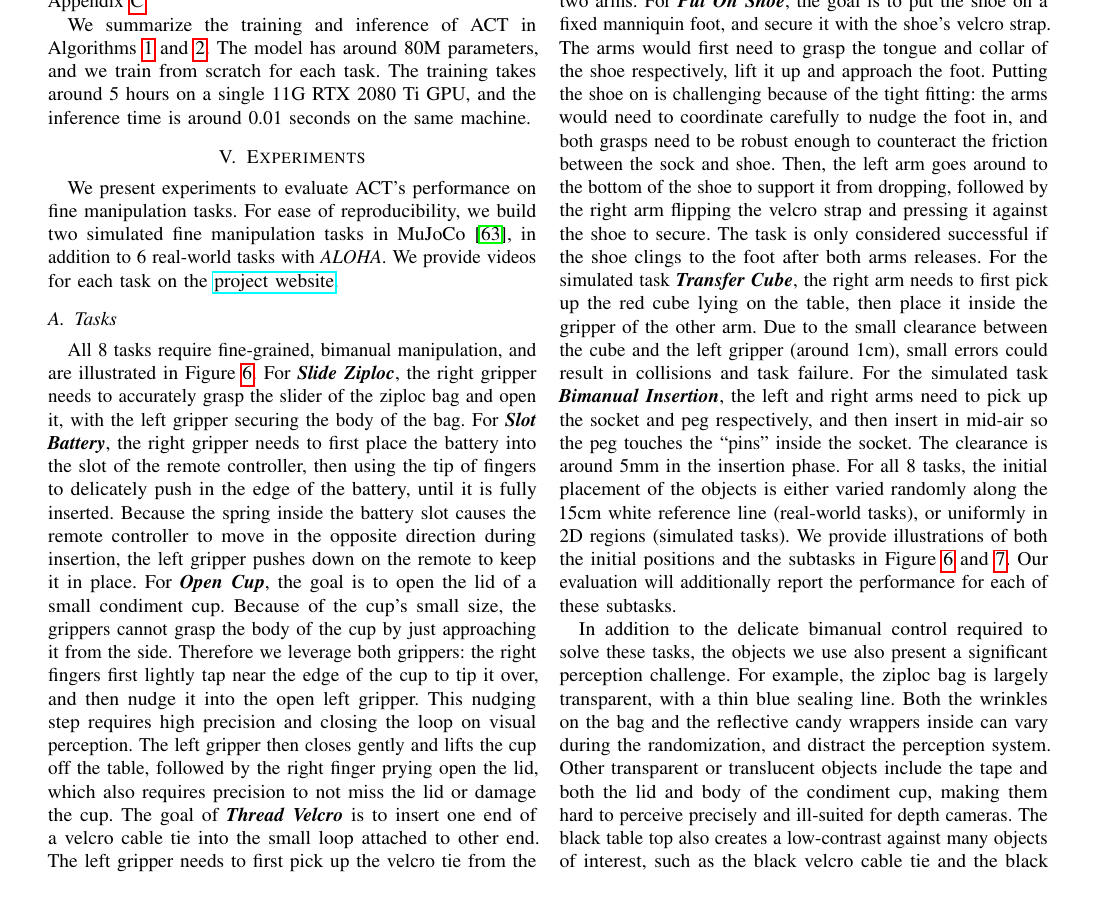
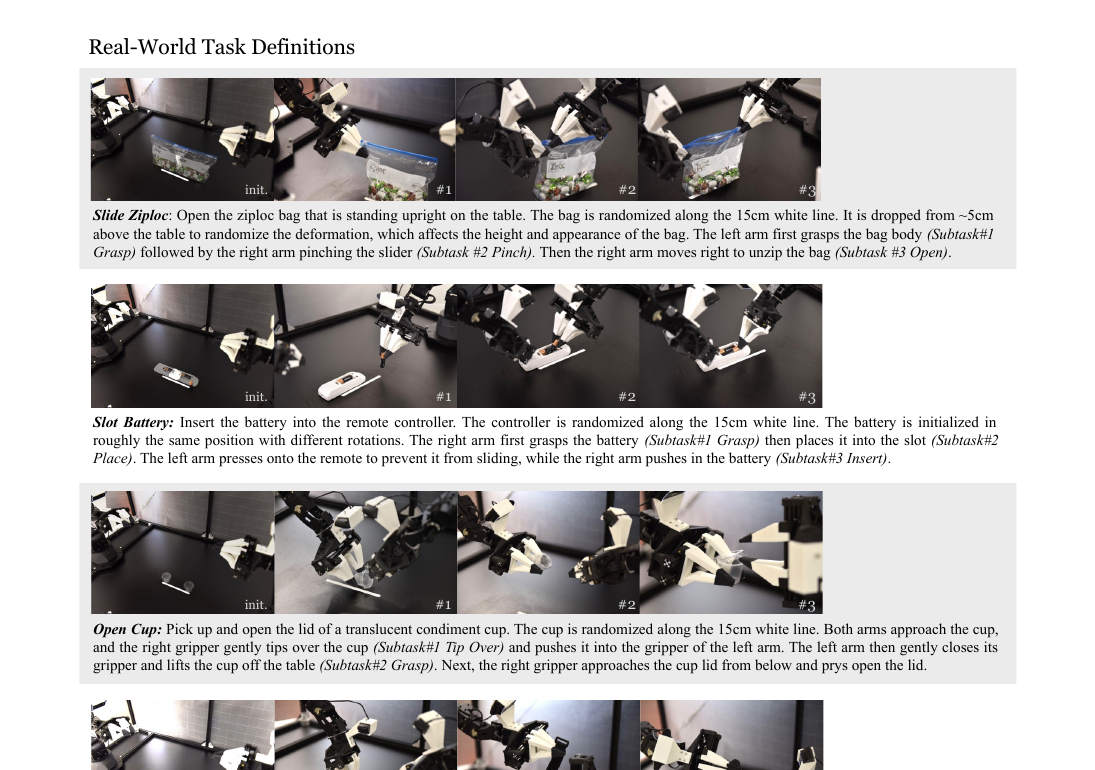
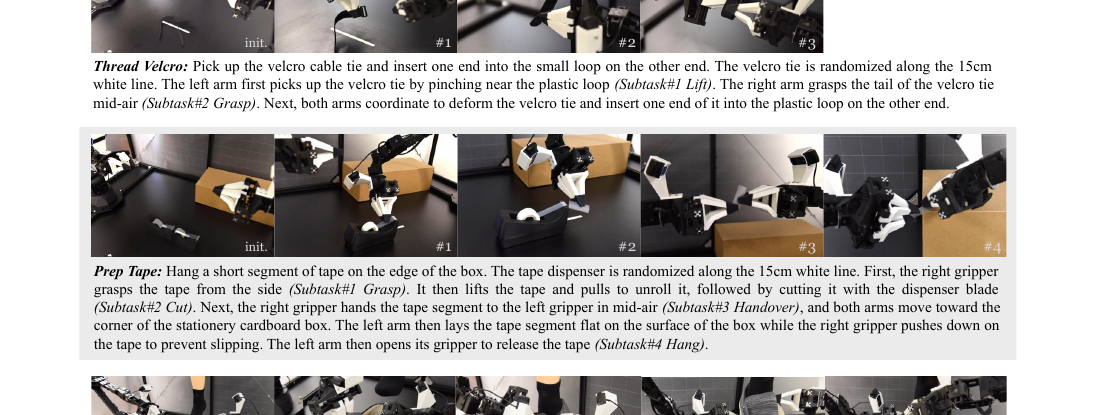
为便于复现,除 ALOHA 上 6 个真实任务外,还在 MuJoCo 建了 2 个仿真精细任务。任务均需精细双臂控制,见图 6–7。
5.1 任务简述
- Slide Ziploc:左夹固定袋身,右夹精确捏滑块拉开。
- Slot Battery:右夹放置并轻推电池入槽;左夹压住遥控器对抗弹簧反力。
- Open Cup:右指点倒半透明杯并推进左夹,抬起后撬盖——强依赖闭环视觉。
- Thread Velcro:空中把魔术贴扎带一端穿进另一端小环(约 3×25mm),毫米误差会在第二步放大。
- Prep Tape:剪胶带、空中交接、贴到纸盒边。
- Put On Shoe:给假脚穿鞋并扣魔术贴,摩擦大需双臂协调。
- 仿真:Cube Transfer(约 1cm 间隙)、Bimanual Insertion(约 5mm 间隙)。
物体含大量透明 / 半透明与低对比黑物,对深度相机不友好,对感知要求高。物体沿 15cm 白线随机摆放(仿真为 2D 区域均匀采样)。
5.2 数据采集
真实任务每条示教约 8–14s(50Hz 下 400–700 步);每任务 50 条(Thread Velcro 为 100),约 10–20 分钟有效数据。 仿真同时采集脚本策略与人类示教各 50 条成功轨迹。人类示教固有随机(如空中交接位置),策略需学「不要相撞、要能抓住」而非死记坐标。
5.3 结果
对比 BC-ConvMLP、BeT、RT-1、VINN。仿真 3 种子×50 次;真实 1 种子×25 次。 ACT 全面最高:如 Slide Ziploc / Slot Battery 最终成功率约 88% / 96%,基线几乎卡在第一阶段; Open Cup 84%、Prep Tape 64%、Put On Shoe 92%、Thread Velcro 20%(黑扎带对比度低、成像占比小导致后段失败)。 人类数据相对脚本数据更难,因多模态与随机性;ACT 靠组块同时缓解累积误差与示教中的停顿。
| 方法 | Cube 最终 | Insertion 最终 | Ziploc 最终 | Battery 最终 |
|---|---|---|---|---|
| BC-ConvMLP | 1 | 0 | 0 | 0 | 0 | 0 |
| BeT | 1 | 0 | 0 | 0 | 0 | 0 |
| RT-1 | 0 | 0 | 0 | 0 | 0 | 0 |
| VINN | 0 | 0 | 0 | 0 | 0 | 0 |
| ACT | 90 | 50 | 32 | 20 | 88 | 96 |
| 方法 | Open Cup | Thread Velcro | Prep Tape | Put On Shoe |
|---|---|---|---|---|
| BeT | 0 | 0 | 0 | 0 |
| ACT | 84 | 20 | 64 | 92 |
六、消融实验
\(k=1\) 平均成功率约 1%,\(k=100\) 约 44%,再增大接近开环略降。给 BC-ConvMLP / VINN 加组块也有类似趋势。 去掉 CVAE 后,人类数据成功率从约 35% 跌到约 2%,脚本数据几乎不变。 用户研究(穿扎带、拆叠杯,6 人):50Hz 显著快于 5Hz(\(p<0.001\)),说明高频遥操作对精细任务必要。
七、局限与结论
我们提出低成本精细操作系统:遥操作 ALOHA + 模仿算法 ACT,可在真实世界用约 10 分钟示教学会打开半透明杯、装电池等技能(约 80–90% 成功)。 仍有任务超出当前臂或算法能力(如扣衬衣扣)。更细局限见附录。希望这套开源低成本系统能成为推进精细机器人操作的可及起点。
附录要点
- 成本对比:相对 DexPilot / Shadow 等系统,ALOHA 双臂约 $18–20k,用平行夹爪换灵巧手以换取成本与敏捷性。
- 能力:相对 Shadow 演示视频中 15 类任务,可用相近物体复现 14/15(无法做掌内保定球旋转)。
- 架构超参、用户研究细节与失败模式见原文附录 C–F。