SuperMimic:用一个可微世界模型缩放人形全身控制
中文译本 · 原文 arXiv:2610.28480 · PDF 下载 · 项目站 supermimic.github.io · CoRL 2026(Oral),Austin。*同等贡献,†共同指导。 译文供阅读;版权归原作者。图与表来自原文 PDF,图注为中文。
摘要
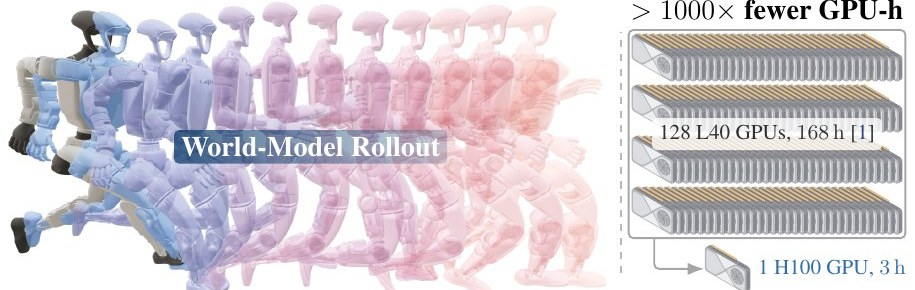
跟踪大规模人体动作数据集,已成为获得通用、富有表现力的人形全身控制的主流路径,但把覆盖的动作数量做上去很贵。现有流程用无模型强化学习:要么把逐条动作的专家策略做有损蒸馏,要么用集群规模的算力硬训一条策略。SuperMimic 用一个可微世界模型摊销全部动作上的学习:这个模型刻画它们共享的动力学,拟合自标准刚体仿真器记录下来的转移。世界模型与跟踪策略在同一个循环里一起训练;对短想象展开做沿时间反向传播(BPTT),给策略解析梯度。想象展开很快,梯度又是解析的,策略学习因此高效。在单张 GPU 上训练 3 小时,SuperMimic 超过一条最先进动作跟踪基线的回报——那条基线在 128 张 GPU 上训了 7 天。GPU 时减少超过 1000×;在 129,514 条基准动作上只失败 25 条,基线失败 179 条。两张 GPU 上再训 9.8 小时后,失败数为 0。动作时长从 1 小时增到 264 小时,世界模型的预测误差保持稳定,达到目标回报所需的 GPU 时增长缓慢。策略可迁移到实机 Unitree G1,覆盖多样与特技动作。SuperMimic 把算力从人形全身控制的缩放瓶颈里拿掉,使测量动作跟踪的缩放律变得可行。
关键词:人形机器人,全身控制,基于模型的强化学习
1 引言
人形机器人有望在为人设计的环境里工作,但这需要能覆盖多样人体动作的全身控制器:从行走、舞蹈到下蹲和平衡恢复。基于物理的动作模仿通过训练强化学习策略去跟踪参考动作片段来解决这个问题,片段来自大规模动捕数据集。现有系统要么把许多片段专用专家蒸馏成一个控制器,要么在大型动作库上直接训一个通才策略。两种做法里,动作库越多样,控制器越能干;但覆盖增长时,两者的计算都变贵。例如最先进跟踪器 SONIC 在 128 张 GPU 上训练约 168 小时,合计约 21,000 GPU 时。参考动作彼此不同,却共享同一套人形混合刚体动力学。无模型 RL 并不显式建模这份共享结构,而是反复从带噪声的仿真展开里估计动作后果。于是「动作更多」就等于「算力更多」。
SuperMimic 用一个从仿真转移日志拟合出的、可学习且可微的世界模型来消除这份低效。对短想象展开做 BPTT,通过学到的模型给出解析策略梯度,使一个动力学模型就能摊销整个动捕库上的学习。这些梯度来自学到的模型,而不是对仿真器求导,因此 SuperMimic 仍兼容刚体仿真器,包括带非光滑接触、实现本身不可微的仿真器。
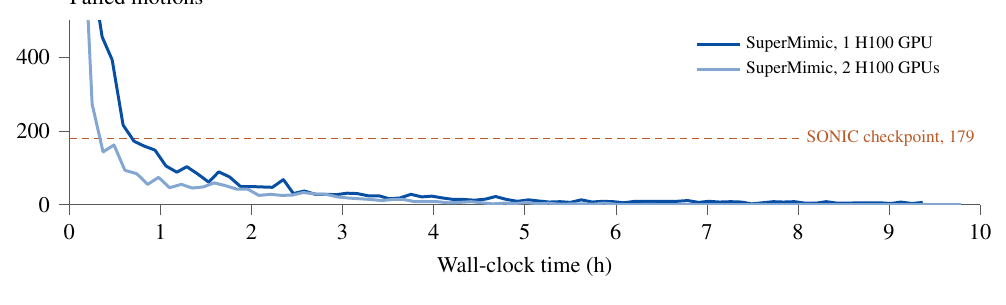
在一张 GPU 上,SuperMimic 于 3 小时内超过 SONIC 已发布检查点的归一化回报,GPU 时减少超过 1000×(§4.1)。在 129,514 条动作的基准上,单卡 3 小时后失败 25 条,两卡 9.8 小时后失败 0 条;SONIC 已发布检查点失败 179 条(附录 F)。数据集时长增加 264× 时,世界模型预测误差保持稳定,达到固定回报所需的计算增长缓慢。学到的策略可迁移到实机 Unitree G1。在对下游接口的初步研究中,用 RL 训练的速度编码器优于蒸馏基线。
贡献。
- 可用于部署的人形控制上的基于模型 RL。我们表明:通过学到的可微世界模型做 BPTT,可以在长期由无模型 PPO 主导的设定里训练全身跟踪策略,并且得到的控制器能迁移到实机 Unitree G1。
- 算力不再是缩放的瓶颈。SuperMimic 在单卡上超过集群规模 PPO 流程 SONIC 的回报,GPU 时减少超过 1000×(§4.1)。动作库扩大时训练成本增长缓慢,不必依赖庞大 GPU 设施就能缩放人形全身控制。
- 收益来自哪些成分。我们指出世界模型的三个性质支撑了算力下降:数据集时长增加 264× 时预测误差仍稳定;展开比仿真器快 10× 以上;解析梯度使策略用大约少 64× 的想象步数,达到 PPO 在该世界模型上的最佳回报。
- 蒸馏之外、用 RL 训练的下游控制。作为初步研究,同一个学到的世界模型可以在接口自己的任务奖励上训练下游目标编码器。在速度指令上,带这个编码器的策略比蒸馏基线跟踪得更准。
2 相关工作
大规模基于物理的动作跟踪。基于物理的动作模仿学习在接触丰富的刚体动力学下复现参考动作的控制器。DeepMimic 用无模型强化学习展示了有表现力的角色技能,PHC 把这一范式扩展到大规模动作集并带稳健恢复。SONIC 进一步表明:放大动作数据、策略容量和训练算力,能得到可迁移到人形硬件的通才控制器。这些结果把动作跟踪确立为获得宽覆盖全身行为的实用路径。但训练这些大规模跟踪器需要大量仿真展开和可观计算。SuperMimic 针对这一瓶颈,学习一个在全部动作间共享的可微动力学模型,使策略改进能利用解析梯度,而不是无模型的展开估计。
| 方法 | Mimic | Latent | Downstream | 任务信号 | 真机 |
|---|---|---|---|---|---|
| NPMP | SVG(0) | BC | SVG(0) | RL | ✗ |
| ControlVAE | MBRL | MBRL | RL | ✗ | |
| PhysicsVAE | PPO | BC1 | PPO | RL | ✗ |
| PULSE | PPO | DAgger | PPO | RL | ✗ |
| MaskedMimic | A2C | DAgger | Distill | ✗ | |
| BeyondMimic | PPO | DAgger | CGD | Distill | ✓ |
| SONIC | PPO | Distill2 | ✓ | ||
| LATENT | PPO | DAgger | PPO | RL | ✓ |
| SuperMimic | MBRL | Distill / RL | ✓ | ||
用于运动控制的可微学得动力学。SuperTrack 通过仿真器的可微学得代理来优化运动控制策略。ControlVAE 联合学习动力学模型、潜技能表示和生成式控制器;MoConVQ 把学得模型训练扩展到离散动作表示,数据达数十小时。SuperDyno 把可微神经动力学扩到数万条动作片段。这些方法确立了学得动力学与解析策略梯度对可缩放仿真角色控制的有效性。SuperMimic 把这一方向推进到:单卡训练大规模人形跟踪器,并做 sim-to-real 部署。它的世界模型以仿真上下文为条件,而部署时的 actor 使用带噪声的本体感觉观测和目标输入(§3.2)。我们评估模型精度、展开吞吐和可微策略更新如何贡献训练效率,以及预测误差如何随动作覆盖增长(§4.1–4.2),并展示所得控制器的实机部署(§4.4)。
基于模型的策略优化与机器人部署。Dreamer 与 DreamerV3 学习潜动力学,做基于想象的 actor–critic;TD-MPC 把短视界规划与终端价值预测结合起来。DayDreamer 直接在物理机器人上学习世界模型。SHAC 用可微仿真做短视界 actor–critic 更新,启发了 SuperMimic 由 critic 自举的目标。解析梯度的机器人控制也可以把简化的可微代理和高保真前向仿真结合起来,四足运动已有演示。SuperMimic 从仿真转移学习代理,并对短想象展开反向传播,从而保持与标准刚体仿真器的兼容。
RWM 与 RWM-U 表明,在学得神经仿真器里训练的策略可以迁移到物理机器人。二者都在想象展开上用 PPO 优化策略;RWM-U 另外使用带不确定性惩罚的离线优化。SuperMimic 则通过对学得动力学求导来优化回报。RWM 与 RWM-U 用其他策略的轨迹预训练世界模型;SuperMimic 在训练过程中,用自己的策略采集的数据拟合世界模型。
可复用的动作表示与下游控制。可复用控制器把动作跟踪接到下游目标接口(表 1)。NPMP 与 PhysicsVAE 从专家行为学习潜运动表示;PULSE 与 LATENT 用学得动作表示做下游强化学习。MaskedMimic 通过动作修补支持部分身体与多模态目标;BeyondMimic 用引导扩散做目标跟随。SONIC 用跟踪奖励和潜变量对齐损失,把目标编码器与跟踪器联合训练。ControlVAE 在冻结技能控制器的同时,通过学得模型优化下游任务策略。SuperMimic 通过同一动力学模型联合训练专用目标编码器和共享解码器(附录 B)。目标接口可以优化参考跟踪奖励,也可以优化自己的任务奖励。我们的初步研究与动作跟踪接口同时训练一个速度接口,两种目标各训一次(§4.5)。
3 方法
3.1 SuperMimic 训练循环
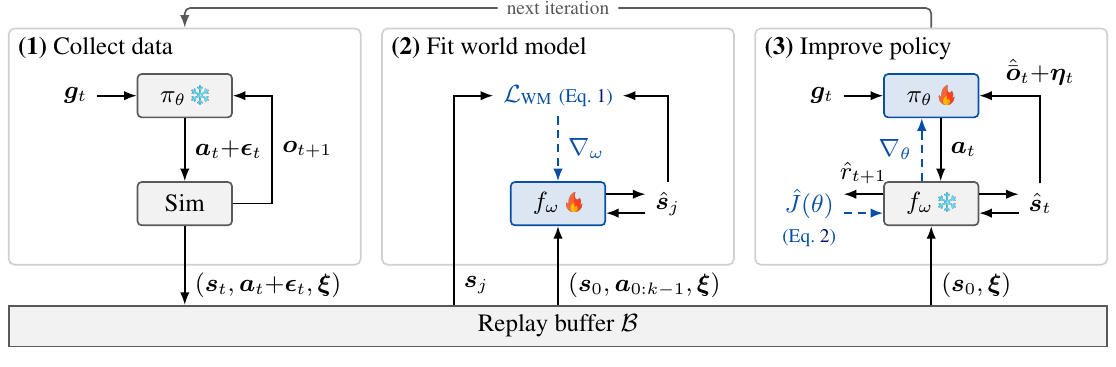
SuperMimic 在多技能动作库上训练一个目标条件的全身控制器,并支持多个目标接口。它把共享的人形动力学放进一个可微世界模型,再通过短想象展开改进策略。训练在一个循环里交替三个阶段(图 2)。第一,当前策略把仿真转移采进回放缓冲区。第二,把可微世界模型拟合到短的回放窗口。第三,把想象回报通过冻结的世界模型反向传播来改进策略;每次展开以 Dyna 风格从缓冲区里的状态起步。缓冲区、模型和策略在整个训练中持续更新,因此动力学学习与控制是一起变好的,而不是分成先后阶段(算法 A.1,附录 D)。更早策略采到的转移对拟合世界模型仍然有效,因为动力学不依赖于采集它的那条策略。
把目标条件部分可观马尔可夫决策过程记为 \(\mathcal{M}\),用紧凑记号:状态 \(s_t\)、目标 \(g_t\)、动作 \(a_t\)。状态 \(s_t\) 给出本体感觉观测 \(o_t\) 和终止 \(d_t\)(\(s_t\) 为终止状态时 \(d_t=1\))。在状态 \(s_t\) 执行动作 \(a_t\) 得到奖励 \(r_{t+1}\) 和下一状态 \(s_{t+1}\)。策略是确定性的,\(a_t=\pi_\theta(o_t,g_t)\),\(a_t\) 参数化归一化的关节设定点;动作跟踪时,\(g_t\) 从参考动作读取。数据采集时,仿真器执行带噪动作 \(a_t+\epsilon_t\),\(\epsilon_t\sim\rho_\epsilon\),缓冲区存的是这条实际执行的带噪动作。噪声拓宽世界模型所拟合的动作范围;它只服务于模型拟合,并且是可选的。回报使用软存活权重,\(c_0=1\),\(c_{t+1}=c_t(1-d_{t+1})\),于是
\[ J(\theta)=\mathbb{E}\Big[\sum_{t\ge 0}\gamma^t c_t r_{t+1}\Big],\qquad \gamma\in[0,1). \]
仿真器记录硬终止,学得模型则预测终止概率 \(\hat{d}_t\in[0,1]\),使想象展开里的存活权重可微。全文用帽子标记某仿真量在世界模型中的对应量。观测分解为 \(o_t=\bar{o}_t+\eta_t\):\(\bar{o}_t\) 是无噪声观测,已知观测噪声 \(\eta_t\sim\rho_\eta\) 在世界模型之外采样。完整空间与奖励见附录 A。
默认接口是全参考动作跟踪。其他目标接口(例如速度)共享同一套学得动力学,并与动作跟踪联合训练(附录 B)。
3.2 学习可微世界模型
仿真器的多刚体动力学是已知的,但仿真器不必提供梯度。SuperMimic 学习一个可微代理来获得策略梯度:它为 §3.3 的 BPTT 更新提供预测和雅可比。得到的解析策略梯度,是仿真中期望回报的一个代理的梯度。仿真随机性的来源已知,因此世界模型保持确定性:它以每回合仿真上下文 \(\xi\)(摩擦、标定偏移、躯干质心)为条件,并预测无噪声观测 \(\bar{o}_t\)。
世界模型包含学得的动力学,以及奖励、观测和终止头;每个头要么学习,要么解析计算:
\[ \hat{s}_{t+1}=f_\omega(\hat{s}_t,a_t,\xi),\quad \hat{r}_{t+1}=r_\omega(\hat{s}_t,a_t,g_t),\quad \hat{\bar{o}}_t=g_\omega(\hat{s}_t,\xi),\quad \hat{d}_t=d_\omega(\hat{s}_t,g_t). \]
在 \(k\) 步自回归回放窗口上拟合网络权重 \(\omega\)(\(k=8\))。窗口从记录状态 \(\hat{s}_0=s_0\) 起步,沿记录动作向前滚,最小化
\[ \mathcal{L}_{\mathrm{WM}}(\omega)=\mathbb{E}_{\mathcal{B}}\sum_{j=1}^{k}\Big[ \lVert\hat{s}_j-s_j\rVert^2+(\hat{r}_j-r_j)^2+\lVert\hat{\bar{o}}_j-\bar{o}_j\rVert^2+\mathrm{BCE}(\hat{d}_j,d_j) \Big]. \tag{1} \]
解析头没有对应损失项。这里 \(r_j\) 是仿真奖励,\(d_j\in\{0,1\}\) 是仿真终止标签,BCE 是二元交叉熵。
3.3 通过世界模型学习策略
每次策略更新时固定世界模型权重 \(\omega\),在 \(H=32\) 步的想象展开上优化 \(\pi_\theta\) 与 \(V_\psi\)。Critic \(V_\psi\) 估计第 \(H\) 步之后的回报,因此模型只需要在这 \(H\) 步内准确。这个想象视界长于拟合模型所用的 \(k\) 步回放窗口(§3.2)。实践中,学得模型在任意长的展开上仍然稳定,因为 \(k\) 步自回归拟合训练它去纠正自己的预测误差。
每次想象展开从回放状态 \(s_0\sim\rho_0\) 及其记录的仿真上下文 \(\xi\) 开始。第 \(t\) 步模型输出 \(\hat{\bar{o}}_t\),我们重新加上传感器噪声,策略再行动:\(a_t=\pi_\theta(\hat{\bar{o}}_t+\eta_t,g_t)\),\(\eta_t\sim\rho_\eta\)。想象展开上的策略目标是
\[ \hat{J}(\theta)=\mathbb{E}_{s_0\sim\rho_0,\pi_\theta}\Big[ \sum_{t=0}^{H-1}\gamma^t\hat{c}_t\hat{r}_{t+1}+\gamma^H\hat{c}_H V_\psi(\hat{s}_H,g_H,\xi) \Big]. \tag{2} \]
动作跟踪时,奖励 \(r_{t+1}\) 是去掉自碰撞惩罚后的 BeyondMimic 动作跟踪奖励(附录 A)。
世界模型可微,因此 BPTT 通过世界模型对 \(\hat{s}_t\) 和 \(a_t\) 的雅可比,计算穿过 \(H\) 步想象的一阶梯度 \(\nabla_\theta\hat{J}\)。对比之下,PPO 把动力学当黑箱:它用采样动作的优势去加权随机策略的得分 \(\nabla_\theta\log\pi_\theta\),这是似然比估计。BPTT 则对每个动作直接对回报求导,短视界上梯度方差低得多。
Critic \(V_\psi\) 拟合只在想象转移上、沿时间反向计算的广义优势估计(GAE)回报:
\[ \mathcal{L}_V(\psi)=\mathbb{E}\sum_{t=0}^{H-1}\big(V_t-\hat{R}_t\big)^2,\qquad \hat{R}_t=\hat{r}_{t+1}+\gamma(1-\hat{d}_{t+1})\big[(1-\lambda)V_{t+1}+\lambda\hat{R}_{t+1}\big], \tag{3} \]
其中 \(V_t=V_\psi(\hat{s}_t,g_t,\xi)\)。递推从 \(\hat{R}_H=V_H\) 开始,即 critic 对视界之外回报的估计。目标 \(\hat{R}_t\) 每个展开算一次,拟合 \(\psi\) 时保持固定。
策略与 critic 的更新合在一起,构成 SHAC 精神下的短视界 actor–critic;SHAC 是对可微仿真器反向传播。SuperMimic 用存活权重 \(\hat{c}_t\) 替换 SHAC 的硬回合终止,并且 critic 没有指数移动平均的目标网络。先前用解析梯度训练的动作跟踪控制器常常不要 critic,只优化 \(H\) 步奖励和。没有 critic 时,训练仍可达到相近的名义跟踪回报,但这个不自举的目标更短视。扰动之后 critic 才重要:恢复或平衡奖励可能落在想象窗口之外(§4.3)。
4 实验结果
我们表明 SuperMimic 相对 PPO 流程缩放得更有利,指出支撑这一缩放的世界模型性质,展示在实机 Unitree G1 上的迁移,并报告下游目标接口的初步研究。仿真器是 MuJoCo Warp,即 MuJoCo 的 GPU 实现。报告的全部成本在 Lambda 按需实例的 NVIDIA H100(80 GB SXM5)上测量。我们跑了多个随机种子,训练非常稳定,归因于动作跟踪在每一步都给出稠密奖励。因此图中不报告种子间变异。归一化回报(下文简称回报)是整回合逐步奖励的无折扣和,除以该和所能取到的最大值。提前终止的策略因此得分低。
4.1 少得多的 GPU 时达到 SONIC 水平的跟踪
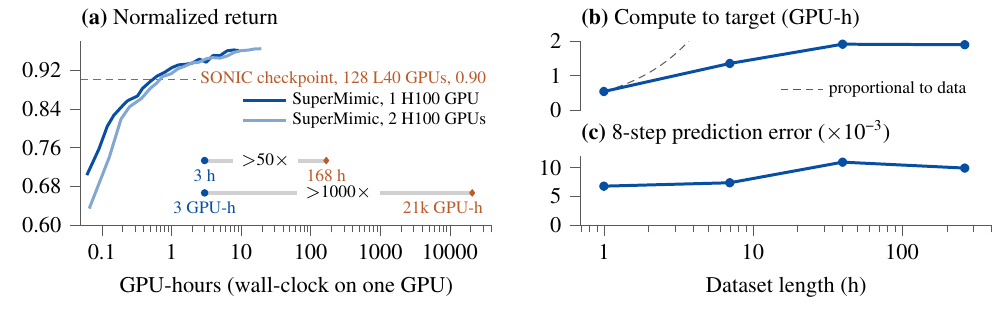
我们与 SONIC 比较。SONIC 是已发表的、在 128 卡集群上训练的 PPO 流程。两种方法都建立在 BeyondMimic 的动作跟踪表述上,因此 SONIC 是目前最接近的已发表对照。单卡 3 小时内,SuperMimic 超过已发布 SONIC 检查点的归一化回报(图 3(a))。在共享的 129,514 条动作基准上,失败也更少:单卡 3 小时 25 条,两卡 9.8 小时 0 条,SONIC 已发布检查点为 179 条(附录 F)。我们对「3 小时」的说法偏保守:从那时起,每个检查点在回报和失败动作数上,都至少领先 SONIC 达「SONIC 与 SuperMimic 最佳结果之差」的一半。于是 SuperMimic 的墙钟时间不到 SONIC 的 1/50,GPU 时不到 1/1000。
算力核算。这些比值比较的是 SONIC 报告的 128 张 NVIDIA L40、7 天(约 21,000 GPU 时),与 1 张 NVIDIA H100 上的 3 小时——在这 3 小时内 SuperMimic 超过 SONIC 已发布检查点的回报。墙钟大约 56×(>50×),GPU 时大约 7200×(>1000×)。这 3 小时覆盖整个训练循环;检查点评估在训练之后,不计入。SuperMimic 在 BONES-SEED 的 264.56 小时动作上训练,这是 SONIC 数据的公开子集,约为 SONIC 611 小时的 1/2.3。GPU 型号也不同:峰值吞吐上,H100 的 fp32 是 L40 的 0.74×,张量核是 5.5×;两边实际用到峰值的多少未知。尽管如此,数据量 2.3×、峰值 GPU 吞吐至多 5.5×,解释不了 GPU 时上 1000× 的差距。
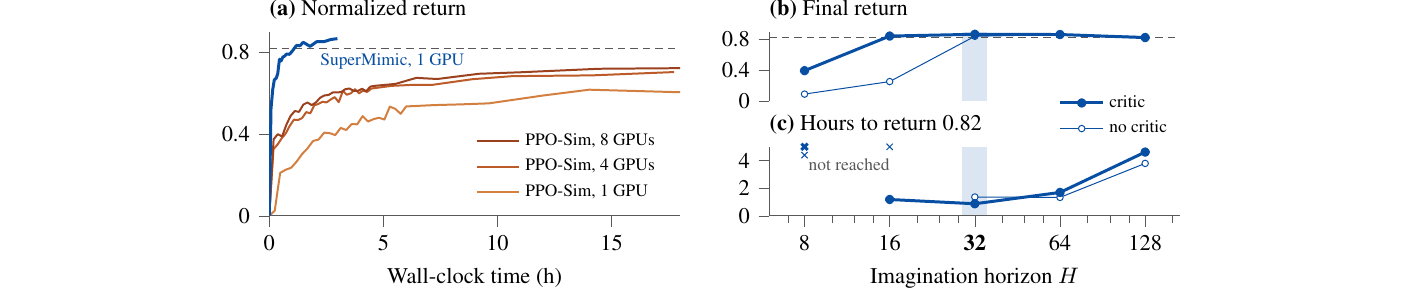
图 4(a) 在 LAFAN1 上给出受控比较。基线 PPO-Sim 是在仿真器里训练的 PPO。它与 SuperMimic 共享动作、观测、奖励、终止、域随机化、actor 与 critic 的网络规模,以及评估协议。它使用 BeyondMimic 的 PPO 超参,每张 GPU 8192 个并行环境,是 SuperMimic 的两倍。PPO-Sim 从采样的仿真展开估计策略梯度;SuperMimic 把想象回报通过世界模型展开反向传播。SuperMimic 在单卡 1.2 小时内于评估中达到回报 0.82。18 小时预算内 PPO-Sim 没有达到。其最终回报在 1 / 4 / 8 张 GPU 上分别为 0.60、0.70、0.72,从 4 卡增到 8 卡几乎没有帮助。
图 3(b, c) 表明:对 SuperMimic,达到目标回报的 GPU 时随数据集时长缓慢增长;同一扫描里世界模型的预测误差保持稳定。§4.2 把两条趋势都追溯到「一个世界模型摊销各动作共享的动力学」。
4.2 学得世界模型的性质
上述结果依赖学得世界模型 \(f_\omega\) 的三个性质:动作库增长时精度仍成立,并且展开既快又可微。
一个模型摊销整个动作库。图 3(c) 中,数据集从 1 小时增到 264 小时,世界模型的 8 步预测误差保持在 0.007 到 0.011。每条动作都由同一个人形执行,新增片段提供的是关于共享身体与接触动力学的更多证据,而不是要求新的容量。这与达到目标回报所需计算的缓慢增长一致(§4.1)。
想象加速展开。策略优化时,展开速度决定更新成本。图 5(a) 表明:在实际使用的批大小上,世界模型比 MuJoCo Warp 快 10× 以上;在 64k 并行环境时最多快 62×。
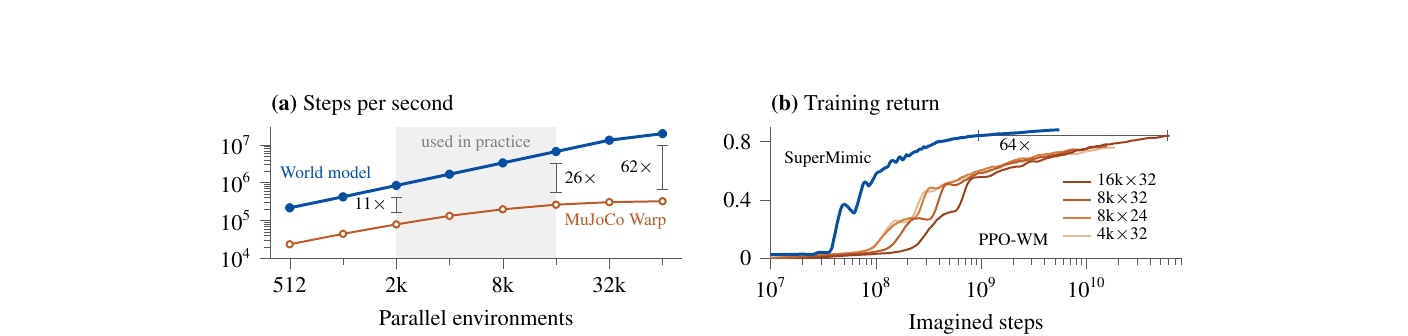
一阶梯度需要更少的想象步。作为机制消融,图 5(b) 分离出一阶策略更新的收益:SuperMimic 用大约少 64× 的想象步数达到 PPO-WM 的最佳回报,因此收益不只是展开更快。
4.3 Critic 使更短视界和推力恢复成为可能
图 4(b, c) 在有无 critic 时扫描 \(H\)。没有 critic 时,\(H\le 16\) 训练失败。有 critic 时,\(H=16\) 与无 critic 的 \(H=32\) 相当,而 \(H=32\) 最快达到回报 0.82。把 \(H\) 从 64 提到 128,达到该回报的时间几乎变为三倍,最终回报也下降;\(H=128\) 是一张 H100 上放得下的最长视界。在匹配的回报上,critic 仍然改变行为。仿真中保持静态 T 姿、施加 0.5–4 m/s 的速度推力时,带 critic 的策略在 0.5–2.4 秒内稳住。无 critic 的策略从不稳住:即使 0.5 m/s 也持续踉跄,4 m/s 时摔倒。
4.4 真机迁移
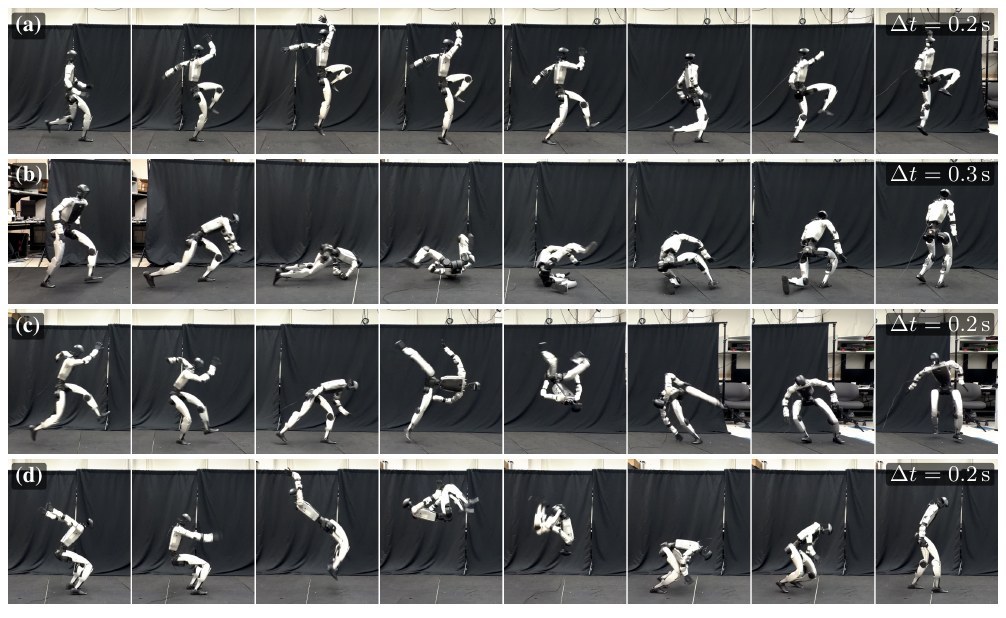
一个通用动作跟踪器部署到实机 Unitree G1,无需按动作调参(图 6)。四条动作覆盖运动(跨步跳)、躯干与肢体着地的接触丰富全身动作(侧滚),以及特技(90° 翻滚和原地 360° 翻滚)。
4.5 下游任务:RL 编码器与蒸馏基线
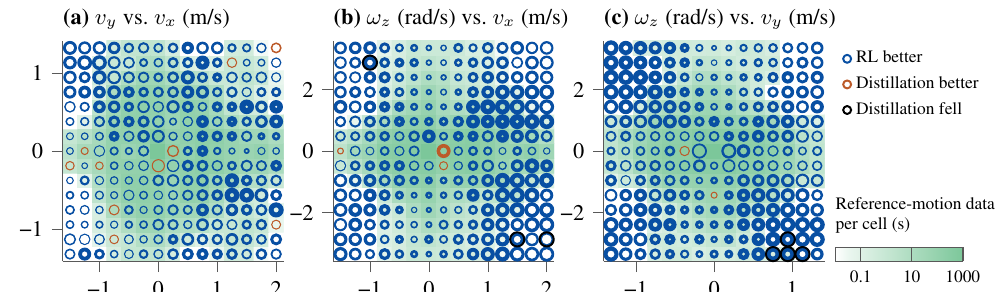
SuperMimic 把下游目标编码器与动作跟踪接口联合训练,共享一个解码器和世界模型(附录 B)。我们对下游接口的研究是初步的。我们在世界模型里、用速度跟踪奖励训练一个速度编码器,并与蒸馏基线比较:蒸馏基线的速度编码器在动作跟踪奖励上训练,指令从参考动作读取。图 7 在覆盖速度空间的 672 个阶跃响应上评估二者(附录 G)。RL 编码器在其中 650 个上稳态误差更低,蒸馏编码器在 15 个上更低。只有蒸馏编码器摔倒,发生在七个几乎没有动作库数据的快速转弯上。
5 结论
SuperMimic 去掉了缩放人形全身控制的算力瓶颈。一个学得的可微世界模型抓住每条动作共享的动力学,通过它做沿时间反向传播,把整个数据集摊销进一条策略。策略在单张 GPU 上训练,超过在 128 卡集群上训练的策略的回报,并迁移到实机 Unitree G1。在受控的数据集时长扫描上,训练成本增长缓慢。同一个模型还能直接在接口自己的任务奖励上训练下游速度接口。测量动作跟踪的缩放律现在负担得起:每次运行一张 GPU。
6 局限与未来工作
- 多接口训练研究不足。我们把速度编码器与动作跟踪器同时训练,但速度跟踪奖励只更新速度编码器,不更新共享解码器(附录 B)。因此同时训练等同于在动作跟踪器之后再训速度编码器,也许并无必要。一旦速度跟踪奖励也更新解码器,同时训练是否有帮助尚未检验。
- 动力学只来自仿真器。世界模型只从仿真转移学习。真机数据可以细化它,其可微性也可以支持系统辨识。
- 没有地形或物体交互。SuperMimic 只在平地上训练。扩展到地形和物体交互是正在进行的工作。
致谢
感谢 Bike Zhang、Sangli Teng、Nima Rahmanian 和 Songbo Hu 的有益讨论和对实验的帮助。本工作部分得到小松(Komatsu)、BAIR 人形智能中心、Apple 和 RAI Institute 的支持。感谢 Lambda 赞助本项目的计算。动作数据来自 Bones Studio(bones.studio)。Pieter Abbeel 与 Koushil Sreenath 同时担任 UC Berkeley 教授和 Amazon Scholar。本文描述在 UC Berkeley 完成的工作,与 Amazon 无关。
参考文献
文献信息保留原文,便于检索。编号与论文一致。
- Z. Luo et al. SONIC: Supersizing motion tracking for natural humanoid whole-body control. Science Robotics, 11(117):eaed4592, 2026. doi:10.1126/scirobotics.aed4592.
- X. B. Peng, P. Abbeel, S. Levine, and M. van de Panne. DeepMimic: Example-guided deep reinforcement learning of physics-based character skills. ACM TOG, 37(4):143:1–143:14, 2018. doi:10.1145/3197517.3201311.
- Q. Liao, T. E. Truong, X. Huang, Y. Gao, G. Tevet, K. Sreenath, and C. K. Liu. BeyondMimic: From motion tracking to versatile humanoid control via guided diffusion. Science Robotics, 11(117):eadx8924, 2026. doi:10.1126/scirobotics.adx8924.
- J. Schulman, F. Wolski, P. Dhariwal, A. Radford, and O. Klimov. Proximal policy optimization algorithms. arXiv:1707.06347, 2017. arxiv.org/abs/1707.06347.
- J. Merel et al. Neural probabilistic motor primitives for humanoid control. ICLR, 2019. OpenReview.
- H. Yao, Z. Song, B. Chen, and L. Liu. ControlVAE: Model-based learning of generative controllers for physics-based characters. ACM TOG, 41(6):1–16, 2022. doi:10.1145/3550454.3555434.
- J. Won, D. Gopinath, and J. Hodgins. Physics-based character controllers using conditional VAEs. ACM TOG, 41(4):1–12, 2022. doi:10.1145/3528223.3530067.
- Z. Luo et al. Universal humanoid motion representations for physics-based control. ICLR, 2024. ICLR 2024.
- C. Tessler, Y. Guo, O. Nabati, G. Chechik, and X. B. Peng. MaskedMimic: Unified physics-based character control through masked motion inpainting. ACM TOG, 43(6):1–21, 2024. doi:10.1145/3687951.
- Z. Zhang et al. Learning athletic humanoid tennis skills from imperfect human motion data. IROS, 2026. arxiv.org/abs/2603.12686.
- Z. Luo, J. Cao, A. Winkler, K. Kitani, and W. Xu. Perpetual humanoid control for real-time simulated avatars. ICCV, 2023. CVF.
- L. Fussell, K. Bergamin, and D. Holden. SuperTrack: Motion tracking for physically simulated characters using supervised learning. ACM TOG, 40(6):1–13, 2021. doi:10.1145/3478513.3480527.
- H. Yao et al. MoConVQ: Unified physics-based motion control via scalable discrete representations. ACM TOG, 43(4):1–21, 2024. doi:10.1145/3658137.
- Y. Lei, Z. Luo, T. He, J. Cao, G. Shi, and K. Kitani. Scalable humanoid whole-body control via differentiable neural network dynamics. ICLR 2025 Workshop on World Models. OpenReview PDF.
- D. Hafner, T. Lillicrap, J. Ba, and M. Norouzi. Dream to control: Learning behaviors by latent imagination. ICLR, 2020. OpenReview.
- D. Hafner, J. Pasukonis, J. Ba, and T. Lillicrap. Mastering diverse control tasks through world models. Nature, 640:647–653, 2025. doi:10.1038/s41586-025-08744-2.
- N. Hansen, X. Wang, and H. Su. Temporal difference learning for model predictive control. ICML, 2022. PMLR.
- P. Wu, A. Escontrela, D. Hafner, K. Goldberg, and P. Abbeel. DayDreamer: World models for physical robot learning. CoRL, 2023. PMLR.
- J. Xu et al. Accelerated policy learning with parallel differentiable simulation. ICLR, 2022. OpenReview.
- Y. Song, S. Kim, and D. Scaramuzza. Learning quadruped locomotion using differentiable simulation. CoRL, 2025. PMLR.
- C. Li, A. Krause, and M. Hutter. Robotic world model: A neural network simulator for robust policy optimization in robotics. arXiv:2501.10100, 2025. arxiv.org/abs/2501.10100. NeurIPS 2025 Workshop on Embodied World Models.
- C. Li, A. Krause, and M. Hutter. Uncertainty-aware robotic world model makes offline model-based reinforcement learning work on real robots. arXiv:2504.16680, 2025. arxiv.org/abs/2504.16680. ICLR 2026 Workshop on World Models.
- R. S. Sutton. Dyna, an integrated architecture for learning, planning, and reacting. ACM SIGART Bulletin, 2(4):160–163, 1991. doi:10.1145/122344.122377.
- M. Janner, J. Fu, M. Zhang, and S. Levine. When to trust your model: Model-based policy optimization. NeurIPS, 2019. NeurIPS.
- J. Schulman, P. Moritz, S. Levine, M. I. Jordan, and P. Abbeel. High-dimensional continuous control using generalized advantage estimation. ICLR, 2016. arxiv.org/abs/1506.02438.
- E. Todorov, T. Erez, and Y. Tassa. MuJoCo: A physics engine for model-based control. IROS, 2012.
- Bones Studio. BONES-SEED: Skeletal everyday embodiment dataset, 2026. huggingface.co/datasets/bones-studio/seed.
- F. G. Harvey, M. Yurick, D. Nowrouzezahrai, and C. Pal. Robust motion in-betweening. ACM TOG (SIGGRAPH), 39(4):60:1–60:12, 2020. doi:10.1145/3386569.3392480.
附录 A 实例化:观测、动作、奖励与仿真上下文
本附录实例化 §3.1 中 POMDP 的共享空间。动作跟踪接口遵循 BeyondMimic;我们所做的改动在行文中注明。
观测。本体感觉观测 \(o_t\) 包括相对默认姿态的关节位置 \(q-q^0\)、关节速度 \(\dot{q}\)、IMU 基座角速度、基座系中的投影重力,以及上一动作 \(a_{t-1}\)(表 A.1)。策略接收最近 10 帧观测。
| 观测项 | 维度 | 噪声 \(\eta_t\) | 单位 |
|---|---|---|---|
| 关节位置 \(q-q^0\) | 29 | \(U[-0.01,0.01]\) | rad |
| 关节速度 \(\dot{q}\) | 29 | \(U[-0.5,0.5]\) | rad/s |
| 基座角速度(IMU) | 3 | \(U[-0.2,0.2]\) | rad/s |
| 投影重力 | 3 | \(U[-0.05,0.05]\) | — |
| 上一动作 \(a_{t-1}\) | 29 | — | — |
目标。动作跟踪接口的目标 \(g_t\) 从参考动作读取。相对 BeyondMimic,我们让编码器条件于 \(K=10\) 帧未来参考序列,而不是单帧目标。其他目标接口把 \(g_t\) 换成各自的指令表示,例如目标速度指令(附录 B)。
动作。动作 \(a_t\) 映射为绕默认姿态 \(q^0\) 的关节设定点 \(q^{\mathrm{sp}}=\alpha a_t+q^0\)。沿用 BeyondMimic,较低的 PD 增益使这个设定点更像关节力矩的代理,而不是期望位置。
奖励。我们使用 BeyondMimic 的动作跟踪奖励(表 A.2),去掉自碰撞惩罚。该惩罚用来防止随机策略钻奖励空子:参考让两个刚体靠近但未接触时,把它们压在一起会抑制动作噪声并抬高速度跟踪奖励。我们的策略在想象展开中是确定性的(§3.3),这个空子没有收益,该项因此不必要。关节限位惩罚从 \(-10\) 降到 \(-2\)。
| 奖励项 | 公式 | 权重 |
|---|---|---|
| 刚体位置 | \(\exp\big(-\frac{1}{|\mathcal{T}|}\sum_{b\in\mathcal{T}}\lVert p_b^{\mathrm{des}}-p_b\rVert^2/0.3^2\big)\) | 1.0 |
| 刚体朝向 | \(\exp\big(-\frac{1}{|\mathcal{T}|}\sum_{b\in\mathcal{T}}\lVert\log(R_b^{\mathrm{des}} R_b^\top)\rVert^2/0.4^2\big)\) | 1.0 |
| 刚体线速度 | \(\exp\big(-\frac{1}{|\mathcal{T}|}\sum_{b\in\mathcal{T}}\lVert v_b^{\mathrm{des}}-v_b\rVert^2/1.0^2\big)\) | 1.0 |
| 刚体角速度 | \(\exp\big(-\frac{1}{|\mathcal{T}|}\sum_{b\in\mathcal{T}}\lVert\omega_b^{\mathrm{des}}-\omega_b\rVert^2/3.14^2\big)\) | 1.0 |
| 根位置 | \(\exp\big(-\lVert p_{\mathrm{root}}^{\mathrm{des}}-p_{\mathrm{root}}\rVert^2/0.3^2\big)\) | 0.5 |
| 根朝向 | \(\exp\big(-\lVert\log(R_{\mathrm{root}}^{\mathrm{des}} R_{\mathrm{root}}^\top)\rVert^2/0.4^2\big)\) | 0.5 |
| 动作平滑 | \(\lVert a_t-a_{t-1}\rVert^2\) | \(-0.1\) |
| 关节限位 | \(\sum_j\big[\max(0,q_j-q_j^{\max})+\max(0,q_j^{\min}-q_j)\big]\) | \(-2\) |
终止。根刚体相对参考的高度或倾斜超过阈值时回合终止(\(|e_{p,z}|\gt 0.25\,\mathrm{m}\) 或 \(e_{\mathrm{tilt}}\gt 0.8\))。倾斜误差 \(e_{\mathrm{tilt}}\) 是重力方向在参考根(骨盆)系与机器人根系中 \(z\) 分量之差的绝对值。对直立参考,\(e_{\mathrm{tilt}}\) 在倾斜约 \(78^\circ\) 时达到 0.8。与 BeyondMimic 不同,我们不因末端执行器偏差而终止。
仿真上下文与域随机化。每回合仿真上下文 \(\xi\) 收集喂给世界模型的域随机化参数(§3.2);表 A.3 列出它们。我们去掉 BeyondMimic 的根速度扰动:这类推力注入确定性世界模型无法刻画的状态不连续,并且我们发现只随机化物理参数就足以迁移到硬件。
| 域随机化 | 采样分布 |
|---|---|
| 摩擦系数 | \(\mu\sim U[0.3,1.2]\) |
| 关节标定偏移(rad) | \(\Delta q_j^0\sim U[-0.01,0.01]\) |
| 躯干质心偏移(m) | \(\Delta x\sim U[-0.025,0.025]\),\(\Delta y\sim U[-0.05,0.05]\),\(\Delta z\sim U[-0.05,0.05]\) |
附录 B 跨目标接口的联合训练
在 §3 中,目标 \(g_t\) 从完整参考动作读取。下游目标接口只部分指定动作,或用另一种形式指定。同一动力学模型可以训练多个目标接口,因为身体物理是共享的。我们为每个目标接口实例化一个 POMDP \(\mathcal{M}_i\)(例如全参考动作目标、速度指令、末端位姿,或 SMPL 身体姿态目标),各自有目标空间 \(\mathcal{G}_i\)、奖励 \(r_i\) 和终止 \(d_i\),并用自己的 critic \(V_{\psi_i}\) 训练。单个策略网络使用按接口的目标编码器 \(\mathrm{enc}_{\theta,i}\) 和共享解码器 \(\mathrm{dec}_\theta\):
\[ z=\mathrm{enc}_{\theta,i}(g)\in\mathcal{Z},\qquad a=\mathrm{dec}_\theta(z,o),\qquad g\in\mathcal{G}_i. \tag{A.1} \]
训练优化提升后的目标 \(\max_\theta \mathbb{E}_{i\sim p(I)}[\hat{J}_i(\theta)]\),其中 \(p(I)\) 是目标接口集合 \(I\) 上的分布。于是每个接口 \(i\) 有自己的策略 \(a=\pi_i(o,g):=\mathrm{dec}_\theta(\mathrm{enc}_{\theta,i}(g),o)\);速度编码器还接收观测历史的一个特征(表 A.4)。每个 \(\hat{J}_i\) 是把式 (2) 中的 \(\pi_\theta\) 换成 \(\pi_i\)、使用 \(\mathcal{M}_i\) 的奖励与终止以及 critic \(V_{\psi_i}\) 后的目标。每个接口都通过同一个动力学模型 \(f_\omega\) 训练,不按接口重新训练该模型。
下游接口按奖励不同,用蒸馏或 RL 训练。蒸馏使用动作跟踪奖励(§3.3),指令从参考动作读取。奖励梯度于是训练该接口从这条指令复现参考动作。RL 直接通过世界模型优化接口自己的任务奖励,例如速度跟踪。在下游接口的展开上,回报梯度穿过共享解码器到达该接口的编码器,并对解码器权重做 stop-gradient;解码器仍由动作跟踪目标训练。§4.5 中 RL 训练的速度编码器还有一项潜变量对齐损失:在带参考指令的展开上,把它的潜变量拉向动作编码器的潜变量(附录 G)。
附录 C 网络结构
表 A.4 列出 §3.2 的世界模型动力学网络,以及附录 B 的策略与 critic 网络。
| 网络 | 输入 | 输出 | 结构 |
|---|---|---|---|
| 动力学 \(f_\omega\) | \(\hat{s}_t, a_t, \xi\) | \(\hat{s}_{t+1}\) | MLP (2048, 2048, 2048) |
| 动作编码器 \(\mathrm{enc}_{\theta,\mathrm{motion}}\) | \(K=10\) 帧未来参考 | \(z\) | MLP (2048, 1024, 512, 256) |
| 速度编码器 \(\mathrm{enc}_{\theta,\mathrm{vel}}\)(附录 G) | 归一化指令 \((v_x,v_y,\omega_z)\),以及 \(o\) 最近 10 帧的特征 | \(z\) | MLP (256, 256) |
| 共享解码器 \(\mathrm{dec}_\theta\) | \(z\),\(o\) 的最近 10 帧 | \(a_t\) | MLP (2048, 1024, 512, 256) |
| Critic \(V_{\psi_i}\) | \(\hat{s}_t, g_t, \xi\) | 标量 | MLP (256, 128);每个接口一个 critic |
算法 A.1 SuperMimic 训练
每次迭代都更新 \(\omega\) 和 \(\theta\);\(\omega\) 只在策略的反向传播内部保持固定(stop-gradient)。对下游接口,\(\hat{J}_i\) 只更新它自己的编码器 \(\mathrm{enc}_{\theta,i}\)。
要求:世界模型 f_ω;跨接口 {M_i}_{i∈I} 共享的策略 π_θ;回放缓冲区 B
对每次迭代:
  ▷ 采集。在仿真中带动作噪声展开 π_θ;把转移写入 B,替换最旧的
  按基于回报的采样抽取复位起点                          ▷ 附录 D.1
  ▷ 拟合世界模型。从 B 采样一段记录的 k 步窗口,
    用记录动作自回归展开 f_ω,并更新
    ω ← ω − α_ω ∇_ω L_WM                                ▷ 式 (1)
  ▷ 改进策略。采样接口 i ∼ p(I),以及 B 中的一个起始状态
  在固定的 f_ω 上做 H 步同策略想象:
    ŝ_{t+1} = f_ω( ŝ_t , π_i(ô̄_t + η_t , g_t) , ξ )
  更新 θ ← θ + α_θ ∇_θ Ĵ_i                              ▷ 式 (2);解析梯度穿过 f_ω;critic V_ψi
  把 critic V_ψi 拟合到该想象展开的 GAE 目标            ▷ 式 (3)
附录 D 训练循环与超参数
D.1 算法
算法 A.1 概括 §3.1 的 SuperMimic 训练循环;它的三步与图 2 的三个面板一一对应。
基于回报的复位采样。仿真回合复位到动作库中的点,偏向策略当前回报低的位置。动作时间线分成 1 秒的箱子,每个箱子 \(b\) 维护从该处出发的折扣回报的运行估计 \(G_b\),用策略自己的展开更新。复位混合三种分布:50% 在箱子上均匀;40% 来自 \(\mathrm{softmax}_b(-25 G_b/G_{\max})\),其中 \(G_{\max}\) 是可达到的最大折扣回报;10% 正比于每个箱子过去的 softmax 权重,使一条难动作在学会之后仍保留一些练习。
D.2 超参数
表 A.5 列出超参数。有差异处,分别给出表 A.8 中单卡与双卡运行的取值。
| 超参数 | 符号 | 取值 |
|---|---|---|
| 世界模型 | ||
| 窗口长度 | \(k\) | 8 |
| 优化器 | Adam | |
| 学习率 | \(\alpha_\omega\) | 1 GPU:\(2\times 10^{-4}\);2 GPU:\(\sqrt{2}\times 2\times 10^{-4}\) |
| 批大小 | 每次更新 10 个批,每批 2048 个窗口 | |
| 梯度裁剪 | 全局范数 1.0 | |
| 想象与策略 | ||
| 想象视界 | \(H\) | 32 |
| 优化器 | Adam,\(\beta=(0.9, 0.95)\) | |
| 学习率 | \(\alpha_\theta\) | 与 \(\alpha_\omega\) 相同 |
| 批大小 | 每次更新 4096 条想象展开 | |
| 梯度裁剪 | 先全局范数 1.0,再逐元素 0.1 | |
| 折扣 | \(\gamma\) | 0.99 |
| 传感器噪声 | \(\eta_t\sim\rho_\eta\) | 表 A.1 |
| Critic | ||
| GAE 参数 | \(\lambda\) | 0.95 |
| 优化器 | Adam | |
| 学习率 | 与 \(\alpha_\omega\) 相同 | |
| 梯度裁剪 | 全局范数 1.0 | |
| 每次更新的 critic 轮数 | 5 轮,每轮 4 个打乱的小批 | |
| 数据采集 | ||
| 每张 GPU 的仿真环境数 | 4096 | |
| 动作噪声 | \(\epsilon_t\sim\rho_\epsilon\) | 每个动作维 \(\mathcal{N}(0, 0.1^2)\) |
| 回放缓冲区大小 | 每个环境 1000 步 | |
| 日程 | ||
| 更新 / 数据比 | 0.4 | |
| 每次世界模型更新对应的策略更新 | 1 | |
| 学习率日程 | 余弦衰减,250,000 次迭代降到 0.03×,之后恒定 | |
| 训练长度 | 320,000 次迭代 | |
| 多 GPU | 数据并行;梯度在 GPU 间平均 | |
附录 E 动作数据过滤
我们在公开的、已重定向到 G1 的 BONES-SEED 动作集上训练。原始发布含 142,220 条片段,但许多与机器人用不上的地形或物体交互(楼梯、箱子、梯子、椅子),或带有重定向伪影,使自由站立在平地上的人形无法执行。我们用两遍过滤去掉这些,保留 129,514 条(表 A.7)。
| 阶段 | 片段数 |
|---|---|
| 原始 BONES-SEED(G1 重定向) | 142,220 |
| 名称过滤之后 | 129,667 |
| 可行性过滤之后 | 129,514 |
名称过滤。每条片段以其动作命名。我们丢掉名称中含有「与机器人用不上的地形或物体接触」之词的片段,例如 stair、ladder、box、chair、sit、climb、jump off 50cm、look over fence。这一遍改编自 SONIC 发布的数据处理代码中的关键词表,并加上它漏掉的若干词,去掉 12,553 条。
可行性过滤。名称过滤会漏掉名字不暴露问题的片段(例如走上箱子的常规动作)。我们把每条动作送进 MuJoCo 正运动学,根据得到的连杆与足部几何轨迹打标,记 \(z_{\min}(t)=\min_b z_b(t)\) 为时刻 \(t\) 最低连杆的高度,地面在 \(z=0\):
- 抬高的支撑。\(z_{\min}\) 连续至少 0.6 秒高于 0.20 m(站在或爬在箱子上)。
- 穿地。\(z_{\min}\) 低于 \(-0.12\) m,或在片段 80% 以上的时间低于 \(-0.08\) m(错误重定向把腿驱进地板)。
-
双脚离地。至少 0.5 秒内双脚都高于地面 0.02 m 以上——用 MuJoCo 从足部碰撞几何到平面的精确距离(
mj_geomDistance),不是连杆原点代理——同时骨盆直立、处于站立高度,且身体近乎静止。自由站立的人形不能在站着不动时双脚离地,因此无论原因(低平台、重定向漂浮,或缓慢升起;弹道跳跃被「静止」门排除)这在平地上都不可行。干净的地面站姿在 \(-0.004\pm 0.004\) m,所以 0.02 m 门槛离地面有数个标准差。
这一遍再去掉 153 条。所有阈值按 50 Hz 的 G1 重定向调节。
附录 F 评估
F.1 基准指标
我们在同一个过滤后的 BONES-SEED 训练集基准上评估 SONIC 与 SuperMimic,共 129,514 条被评估动作。对 SONIC,我们评估其已发布检查点和 v1.1 检查点。每条动作从第一帧播放一次,所有策略用同一仿真:足部摩擦 1.0,无域随机化、无观测噪声,物理确定性。每条策略使用自己的执行器增益和动作缩放,并按自己的训练环境构造观测。若展开触发 SuperMimic 的训练终止(附录 A),该动作记为失败。SONIC 自己的成功标准是:根与末端执行器高度偏差超过 0.25 m 即失败,且没有朝向项。
F.2 失败动作
表 A.8 按动作组统计失败数。SONIC 整组失败(全部 44 个翻滚、全部 22 个侧滚,以及某套舞蹈的全部 8 条),并在 24 个远跳中失败 15 个。其 v1.1 检查点失败 239 条,其中包括同样的翻滚和舞蹈,以及 22 个侧滚中的 19 个。单卡 3 小时后,SuperMimic 的失败集中在少数几组难动作:表 A.8 的前五组共 195 条动作,装下了它 25 次失败中的 14 次。没有任何一组里它失败得比 SONIC 更多。两卡 9.8 小时后,SuperMimic 失败数为 0。图 A.1 给出训练过程中的计数。基准动作对两种方法都是训练动作,因此这些计数衡量的是每条策略对训练动作的覆盖有多全,而不是对新动作的泛化。
| 动作组(条数) | SONIC | SuperMimic | |
|---|---|---|---|
| 1 GPU × 3 h | 2 GPU × 9.8 h | ||
| 侧滚(22) | 22 | 2 | 0 |
| 翻滚:360°、180°、90°(44) | 44 | 1 | 0 |
| fire-in-the-hole 转身(20) | 3 | 3 | 0 |
| 交叉腿(10) | 9 | 0 | 0 |
| 躺、歇与站起(99) | 28 | 8 | 0 |
| 远跳(24) | 15 | 0 | 0 |
| 舞蹈套路(8) | 8 | 0 | 0 |
| 其余动作(129,287) | 50 | 11 | 0 |
| 合计(129,514) | 179 | 25 | 0 |
F.3 实验协议
图 3。SuperMimic 在过滤后的 BONES-SEED 集上训练(附录 E)。(b, c) 的数据集时长扫描使用 1、7、40 和 264 小时的子集。
附录 G 速度指令任务
G.1 训练设置
§4.5 的速度编码器把指令 \((v_x, v_y, \omega_z)\) 和 \(o\) 最近 10 帧的一个特征映射到共享潜变量。每个编码器在各自的运行里从头训练,并与动作跟踪接口联合训练 100,000 次迭代。两次运行都使用从 LAFAN1 与 BONES-SEED 滤出的走、跑库。4096 个仿真环境的一半,以及每个想象批的一半,使用速度接口,因此 \(p(I)\) 均匀;与算法 A.1(每次更新采样一个接口)不同,每个想象批混合两种接口。
指令。指令 \(g_t=(v_x, v_y, \omega_z)\) 把航向(仅偏航)系中的目标平面根速度,与世界系目标偏航角速度叠在一起。参考指令是参考根速度在参考航向系中、居中 25 帧的均值。对 RL 编码器,每个环境在每次复位以及每 250 个控制步(5 秒)重采样指令来源:以概率 0.5 每步从参考片段读取指令,否则保持一条均匀抽取的指令,范围 \(v_x\in[-1.5, 2]\) m/s、\(v_y\in[-1.32, 1.32]\) m/s、\(\omega_z\in[-3.35, 3.35]\) rad/s,并以概率 0.1 置零(站立)。
编码器。在带参考指令的展开上,权重 0.1 的均方损失把速度潜变量拉向同一时刻动作编码器的潜变量,并对动作潜变量做 stop-gradient。
展开、奖励与终止。每个接口的想象展开从它自己的仿真环境记录的状态起步。RL 编码器的速度展开使用速度跟踪奖励和仅摔倒终止(表 A.6);蒸馏基线使用附录 A 的动作跟踪奖励与终止。
| 奖励项 | 公式 | 权重 |
|---|---|---|
| 线速度 | \(\exp\big(-\lVert v_{xy}-v_{xy}^{\mathrm{cmd}}\rVert^2/0.5^2\big)\) | 2.0 |
| 偏航角速度 | \(\exp\big(-(\omega_z-\omega_z^{\mathrm{cmd}})^2/0.5\big)\) | 2.0 |
| 动作平滑 | \(\lVert a_t-a_{t-1}\rVert^2\) | \(-0.3\) |
| 关节限位 | \(\sum_j\big[\max(0,q_j-q_j^{\max})+\max(0,q_j^{\min}-q_j)\big]\) | \(-2\) |
| 躯干侧倾 | \(\sin^2\phi_{\mathrm{torso}}\) | \(-4\) |
| 躯干滚转与俯仰角速度 | \(\omega_{\mathrm{roll}}^2+\omega_{\mathrm{pitch}}^2\) | \(-0.05\) |
| 终止(摔倒) | \(h_{\mathrm{root}}\lt 0.35\,\mathrm{m}\) 或 \(1+u_z\gt 0.7\) | |
G.2 阶跃测试
协议。从站立开始,策略接收一条固定指令 5 秒;每条指令测四次。相对稳态误差是最后 2 秒平均速度误差的范数,除以指令范数;根速度在航向系中测量。每条指令的取值是未摔倒试验的中位数。672 个阶跃响应是三个平面上各一张 \(15\times 15\) 网格,覆盖上面的均匀指令范围,站立指令除外。图 7 中,误差高于 0.9 的画成 0.9;四次试验全部摔倒的策略画在上限上。
结果。RL 编码器在 672 个阶跃响应中的 650 个上误差更低,蒸馏编码器在 15 个上更低。二者相对误差的中位数分别为 0.16 和 0.49。蒸馏在七条指令的每一次试验中都摔倒,这些指令都是平移加上至少 2.8 rad/s 的转弯,动作库在那里几乎没有数据。每条策略有一个训练种子。