中文译本 · 原文 Data Layout and Its Notation · MLC Community
数据 Layout 与记号
本章要点
- 数据 layout 把 tensor 的逻辑下标映射到物理位置。它不仅决定程序读没读对,还决定全局访存能否 coalesce、共享内存会不会 bank conflict,以及 tile 是否符合某硬件单元要求的格式。
- Shape-Stride 模型用 shape 和一组 stride 定义这份映射。Tiling 只是把原下标再拆成更多坐标。命名轴把物理位置扩展到 TMEM、warp lane 和寄存器;复制与偏移表示副本和固定平移。
- Swizzle 在不改 tile 逻辑形状的前提下重排共享内存地址。元素宽度、对齐和访问模式匹配时,XOR swizzle 可以把访问摊到不同 bank,避开 bank conflict。
同一组数值、同一块 GPU,只因在内存里的物理排布不同,性能就可以差一个数量级。
Tensor 的逻辑下标并不告诉你字节实际存在哪。硬件对放置极其敏感:32 条 lane 的 load 是合成一笔事务,还是拆成最多 32 笔;地址落在不同 bank 还是撞车串行;tile 的字节排布 Tensor Core 能不能读——都取决于访问模式和 layout。
机器学习程序通常只写逻辑 shape。数据 layout 补上物理信息:逻辑下标 (i, j, …) 上的元素住在哪——内存、寄存器,还是别的硬件存储空间。
我们从 Shape-Stride 模型开始,再把同一套记号扩展到 TMEM、寄存器 fragment 和多 GPU layout。章末讲 swizzle:重排地址,让同一块 tile 的行访问和列访问都更好。
Shape-Stride 模型
先不谈 GPU 特有 layout。Shape 给出每个维度的大小;对应的 stride 说明逻辑下标沿该维加一,物理上要跳多少个元素。写成 S[(shape) : (strides)]。逻辑下标的物理位置,就是下标与 stride 的点积。例如行优先的 4×4 矩阵:
S[(4, 4) : (4, 1)]

addr(i, j) = i·4 + j·1
PyTorch 和 NumPy tensor 已经是这套模型:一块平坦存储,外加 shape 与 strides 元数据。
import torch

t = torch.arange(12).reshape(3, 4)
t.shape        # torch.Size([3, 4])
t.stride()     # (4, 1)        ← 正是 S[(3, 4) : (4, 1)]
t 底下的存储仍是一维:
[0, 1, 2, 3, 4, 5, 6, 7, 8, 9, 10, 11]
这里 t 用 S[(3, 4) : (4, 1)]:每行四个连续元素,相邻列在存储里也相邻。很多「出 view」的操作只需改 shape 和 strides,不必搬元素。二维 tensor 上,permute(1, 0) 就等于 t.T:
tt = t.permute(1, 0)               # 或 t.T
tt.shape                           # torch.Size([4, 3])
tt.stride()                        # (1, 4)        ← stride 对调,数据没动
tt.untyped_storage().data_ptr() == t.untyped_storage().data_ptr()
                                   # True,还是同一块底层存储
转置 view 用 S[(4, 3) : (1, 4)],所以 tt[i, j] 的地址偏移是 i·1 + j·4,正好是 t[j, i]。对连续 tensor 调 view,或在现有 layout 兼容时调 reshape,也是同一套。NumPy 一样,只是它的 .strides 以字节计,不是元素。
Tile Layout
GPU kernel 很少一次处理整块矩阵,通常切成更小的 tile。例如把 8×8 矩阵切成 2×4 tile,tile 之间行优先,tile 内部也行优先。
下图先在逻辑矩阵和物理内存里画出这种排布。
点击格子,对照 tile 坐标、物理地址,以及 unflatten 与 fD(x)。
把 Tiling 写成 Layout 函数
要描述上面的排布,既要知道 tile 在矩阵里的位置,也要知道元素在 tile 内的位置。从逻辑坐标 (i, j) 出发,按原来的 8×8 shape 展平:
x = i·8 + j
切成 2×4 tile 后,行坐标拆成 4 个 tile 行、每 tile 2 行;列坐标拆成 2 个 tile 列、每 tile 4 列。用来分解 x 的 shape 因此是 (4, 2, 2, 4)。
(c0, c1, c2, c3) = unflatten(x; 4, 2, 2, 4)

c0 = x // 16
c1 = (x // 8) % 2
c2 = (x // 4) % 2
c3 = x % 4
代入 x = i·8 + j:
c0 = i // 2    = tile_row
c1 = i % 2     = row_in_tile
c2 = j // 4    = tile_col
c3 = j % 4     = col_in_tile
再把四个坐标映到物理地址。每个 tile 有 2×4=8 个元素,每行 tile 有两个 tile,tile 内每行四个连续元素:
fD(x) = (c0·2 + c2)·8 + c1·4 + c3
= c0·16 + c1·4 + c2·8 + c3·1
得到的 layout 是:
S[(4, 2, 2, 4) : (16, 4, 8, 1)]
一般 Layout 函数
同一套计算推广到一般 Shape-Stride layout:
S[(e0, e1, ..., en-1) : (s0, s1, ..., sn-1)]
对平坦逻辑下标 x,先按 shape unflatten:
(c0, …, cn-1) = unflatten(x; e0, …, en-1)
再与 stride 做点积:
fD(x) = Σ ck sk
Shape 决定 x 怎么拆成坐标,stride 决定这些坐标映到哪里。上面的 tile layout,就是选了 shape (4, 2, 2, 4) 和 strides (16, 4, 8, 1)。
命名轴:从线性地址到物理坐标
上面的 layout 把每个元素映到一个线性内存地址。有些 GPU 存储空间要用不止一个坐标才能标出物理位置。TMEM 和寄存器 fragment 就是两个直接例子。
二维 TMEM 地址空间
Blackwell TMEM 天生是二维的。每个 CTA 有 128 条 lane 行、最多 512 个 32-bit 列。TMEM 里的位置因此同时需要 lane 坐标和列坐标。
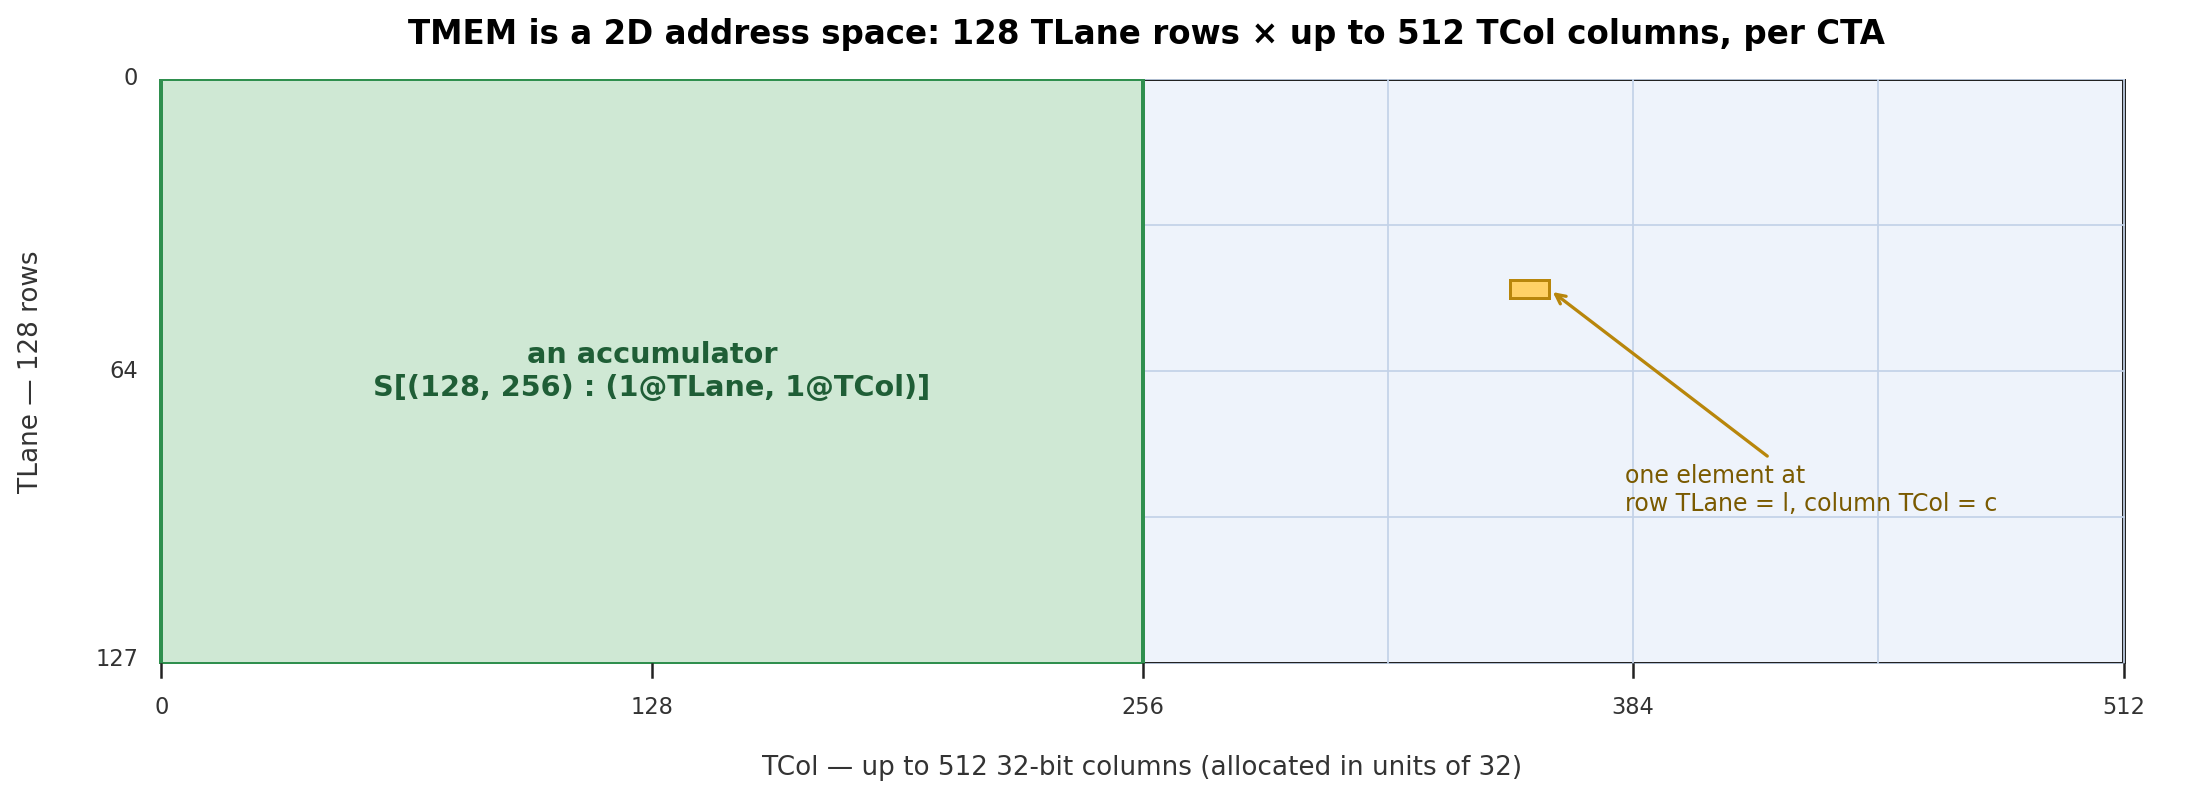
TMEM 使用二维地址空间:128 条 TLane、最多 512 个 TCol;图中累加器占 128×256 区域。
单条线性内存轴分不清这两个维。我们用 @TLane 和 @TCol 表示 TMEM 的 lane 轴和列轴。例如一块 128×256 累加器 tile 可以写成:
S[(128, 256) : (1@TLane, 1@TCol)]

(row, col) = unflatten(x; 128, 256)
f_D(x) = row@TLane + col@TCol
这里 fD(x) 不再返回一个整数地址,而是同时给出 TLane=row 和 TCol=col。普通线性内存只有一条地址轴 @m。把这个标签写出来,行优先的 8×16 内存 tile 是:
S[(8, 16) : (16@m, 1@m)]

(row, col) = unflatten(x; 8, 16)
f_D(x) = (row·16 + col)@m
寄存器 Fragment
Tensor Core 用的寄存器 fragment 也会出现命名轴。考虑 m8n8 风格的 fragment:逻辑上是 64 个元素的 8×8 tile;物理上这些元素摊在 warp 的 32 条 lane 上,每条 lane 两个 fragment slot。
因此单靠 lane ID 不够。物理位置有两部分:哪条 lane 拥有它,以及在该 lane 里占哪个 fragment slot:
laneid = row·4 + col//2
reg    = col%2
下图给出 8×8 tile 如何摊到 warp lane 和寄存器。
在左侧逻辑 8×8 矩阵里点格子(例如 r5、c3 的元素 43):逻辑元素 (5, 3) 由 lane 21 拥有,占该 lane 的 fragment slot 1。
这两个坐标写成 @laneid 和 @reg。@laneid 是 warp 内的 lane ID;@reg 是该 lane 本地的 fragment slot。这里的 @reg 是 layout 里的 lane 本地坐标。某条指令仍可能把多个低精度元素打进同一个 32-bit 硬件寄存器。
S[(8, 4, 2) : (4@laneid, 1@laneid, 1@reg)]

(c0, c1, c2) = unflatten(x; 8, 4, 2)
             = (row, col//2, col%2)

f_D(x) = (c0·4 + c1)@laneid + c2@reg
复制与偏移
在 TMEM 里跨 Warp 广播 Scale Factor
Block-scaled MMA 不是某一种具体 dtype,而是一类用 per-block scale factor 的低精度 MMA。Blackwell 上常见有 MXFP8 和 NVFP4。这里说的 local block scaling:MXFP8 沿 K 每 32 个元素共享一个 E8M0 scale;NVFP4 每 16 个 E2M1 FP4 元素共享一个 E4M3 scale。
核心想法一样:把 A、B 沿 K 切成 scale block,每块一个 scale。若每块沿 K 有 K_blk 个元素,元素 k 所在块是:
sfk = k // K_blk
数学上,block-scaled MMA 等价于先按对应 scale 缩放 A、B,再做乘加:
A_real[m, k] = A_low[m, k] · SFA[m, k // K_blk]
B_real[k, n] = B_low[k, n] · SFB[n, k // K_blk]
D = C + A_real × B_real
SFA[m, sfk] 是 A 第 m 行、K-scale 块 sfk 的 scale;SFB[n, sfk] 对应 B 的第 n 列。
下面用 NVFP4 的 SFA 说明这些 scale 怎么放进 TMEM。取 M = 128、SF_K = 4。每个 scale 一字节,逻辑 128×4 SFA 共:
128 行 × 4 字节/行 = 512 字节
搬这份数据的 tcgen05.cp.32x128b.warpx4,基形状是 .32x128b:32 条 local lane,每 lane 128 bit(16 字节)。基 tile 因此也是:
32 local lane × 16 字节/lane = 512 字节
大小正好对上。但基 tile 只有 32 个 lane 位置,128 个 m 不能各占一条 lane。于是把 m 拆成:
local_lane = m % 32
Mgroup     = m // 32
local_lane 选 32 条 lane 之一,Mgroup 选该 lane 上的一个 TCol。固定 local lane l 时,四组 SFA 行并排放:
TCol 0: SFA[l,      0:4]
TCol 1: SFA[l + 32, 0:4]
TCol 2: SFA[l + 64, 0:4]
TCol 3: SFA[l + 96, 0:4]
每行 SFA 四个一字节 scale,正好填满一个 32-bit TCol 单元。sfk = 0…3 选该单元里的字节。完整打包规则:
local_lane = m % 32
Mgroup     = m // 32
TCol       = Mgroup
byte       = sfk

byte_offset = TCol·4 + byte
例如 SFA[64, 2] 的 local_lane = 0、Mgroup = 2,所以在 local lane 0 的 TCol 2、字节 2。SFA[0, 2]、SFA[32, 2]、SFA[64, 2]、SFA[96, 2] 都用 local lane 0,但分别占 TCol 0、1、2、3,并不共享同一个 TMEM 单元。
到这里,一份完整的 128×4 SFA 已经打进 32-lane 基 tile。Block-scaled tcgen05.mma 通过四个 32-lane 分区读 TMEM,并要求每个分区在相同的 local-lane、TCol、字节位置提供完整的 scale tile。因此 PTX ISA 要求 SFA、SFB 都在四个分区上复制:
partition 0: TLane 0…31
partition 1: TLane 32…63
partition 2: TLane 64…95
partition 3: TLane 96…127
.warpx4 限定符把打好的基 tile 多播进这四个分区。分区下标 p = 0…3 时,物理 Lane 坐标是:
TLane = local_lane + 32·p
TCol 和字节坐标不变。于是 SFA[64, 2] 出现在 (TLane, TCol, byte) 的 (0,2,2)、(32,2,2)、(64,2,2)、(96,2,2)。
这里有两组互不相关的「四」。四个 Mgroup 沿 TCol 打包 128 个逻辑 m 行;四个分区是这份打包 tile 沿 TLane 的物理副本。交互图两个方向都画出来了。
SFB 遵循同一硬件规则,用 B 的列下标 n 替换 A 的行下标 m。例如 N = 128、SF_K = 4 时,基打包用 local_lane = n % 32、TCol = n // 32、byte = sfk;再由 .warpx4 拷进全部四个 32-lane 分区。
用复制表示多个物理位置
上面的 fD(x) 对逻辑元素 x 只返回一个位置,表示不了 .warpx4 造出的额外副本。因此在基 layout 后面追加 R[shape : strides]。例如 R[n : s@axis] 引入独立的副本坐标 r = 0…n-1,产生偏移 r·s@axis。
TMEM 例子里,沿 TLane 的四份拷贝写成:
S[(32, …) : (1@TLane, …)] + R[4 : 32@TLane]
R[4 : 32@TLane] 里 r 取 0、1、2、3,TLane 偏移为 0、32、64、96。复制项不增加逻辑数据,只记录副本的物理位置。
点击任意 SFA 格子,查看它在 32-lane 基 tile 中的位置,以及 .warpx4 之后在四个 TMEM 分区里的位置。
GPU Mesh 上的复制与偏移
同一套复制结构也能描述多 GPU layout。GPU mesh 把多块 GPU 沿一条或多条逻辑设备轴排开。2×2 mesh 有四块 GPU,坐标为 (@gpuid_x, @gpuid_y)。
先定义沿 @gpuid_y 切分的基 layout:
base = S[(2, 4, 8) : (1@gpuid_y, 8@m, 1@m)]
三个逻辑坐标叫 (y, row, col)。基 layout 里,元素 (1, 2, 3) 映到:
gpuid_y = 1
m = 2·8 + 3 = 19
加上复制:
base + R[2 : 1@gpuid_x]

元素 (1, 2, 3) → 设备 {(0, 1), (1, 1)},本地偏移 = 19
R[2 : 1@gpuid_x] 把元素同时放在 gpuid_x = 0 和 1。固定偏移则不同:
base + O[1@gpuid_x]

元素 (1, 2, 3) → 设备 (1, 1),本地偏移 = 19
这个偏移只沿 @gpuid_x 把基位置平移一格,不造副本。下图对比完全切分、切分+复制、切分+偏移。用控件切换。
点击格子,看对应逻辑元素落在哪些设备上。
Swizzle Layout
本章最后一个 layout,用来对付共享内存的 bank conflict。
现代 NVIDIA GPU 把共享内存分成 32 个 bank。连续的 32-bit word 依次映到连续 bank。按本章用的 bank 宽度,字节地址 addr 的 bank 是:
bank = (addr // 4) % 32
同一处理批次里,若多次访问打到同一 bank 的不同地址,硬件必须串行,这就是 bank conflict。多条 lane 读同一地址时,硬件可以把这个 word broadcast 给它们,不算 conflict。
一条 warp 指令可按访问宽度拆成若干处理批次。Nsight Compute 把每批叫 wavefront。连续且对齐的访问,一个 wavefront 最多搬 128 字节:32 个 bank 各 4 字节。每 lane 访问 4 字节时,32 条 lane 同属一个 wavefront;8 字节则按 16 条一组,16 字节按 8 条一组。Bank conflict 只在同一个 wavefront 内判定。例如 8 字节访问时,lane 0 和 16 即使打同一 bank 也不互相冲突,因为它们属于不同 wavefront。
Tensor 程序常常从不止一个方向访问同一块 tile。矩阵代码可能先读连续行,再抽一列。朴素 layout 通常只照顾其中一种。行优先 tile 里,行内相邻元素地址连续,通常摊到不同 bank;列内相邻元素隔一个行 stride。若 stride 刚好等于 bank 映射周期,多条 lane 的访问会挤进同一 bank。列优先则相反。
Swizzle 在保持 tile 逻辑形状的前提下改物理地址排布。常见手法是把行下标的一部分 XOR 进列下标,让目标访问模式更均匀地摊到各 bank。
下面的 8×8 交互例子把 32 个物理 bank 缩成 8 个。左边朴素行优先里,一列的八个元素占同一 bank 的不同地址:
bank = logical_col
选中第 3 列,八次访问全打到 bank 3,形成 8-way bank conflict。
右边施加 XOR swizzle:
mapped_col = logical_col XOR row
bank       = mapped_col
XOR 是按位异或。它把同一逻辑列映到不同行的不同 bank。例如读 logical_col = 0 时,行 0…7 映到 bank 0…7,八次访问可以并行。
点击列下标,对比朴素行优先与 XOR swizzle 的 bank 映射。前者要八拍,后者一拍。
对照下面 NVIDIA PTX ISA 官方图:K-major 128B swizzle layout。它直接对应上图右侧「有 Swizzle(XOR)」:两边用同一条 XOR 规则重排每行的八个位置。
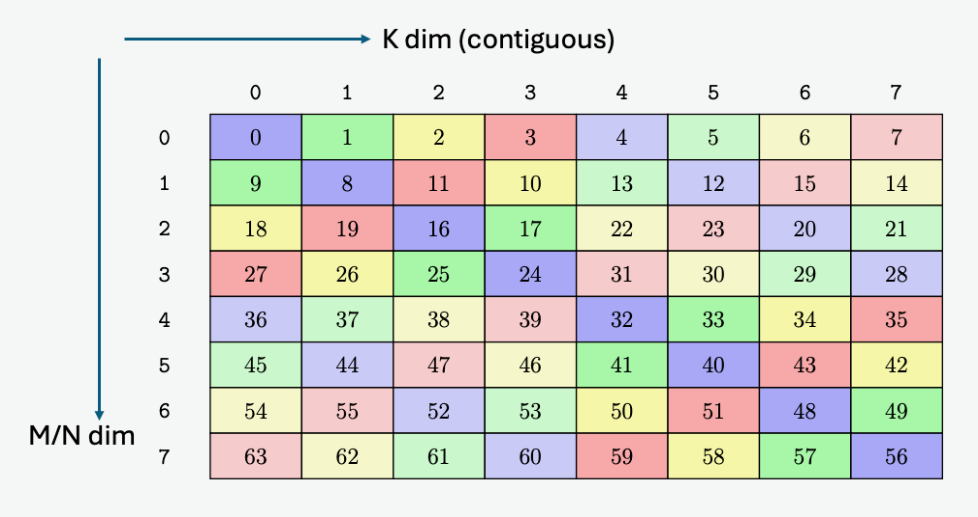
K-major 128B swizzle layout(NVIDIA PTX ISA)。每个格子是一个 128-bit 元素。
数字看起来不同,只因为标注方式不同。我们 demo 每行用 0–7 标元素原来的逻辑列;官方图把整个 8×8 从 0 编到 63。
例如 demo 第 1 行的逻辑列标签是 1, 0, 3, 2, 5, 4, 7, 6。官方图给这一行加上行偏移 8,得到 9, 8, 11, 10, 13, 12, 15, 14。
我们把图里每个 128-bit 格子叫 16 B sector。SWIZZLE_128B 里,atom 的每一行有八个 sector,总宽 128 B。按常见的 4 字节 bank 粒度,一个 sector 里四个 32-bit word 映到四个相邻 bank,一整行就盖满 32 个 bank。Swizzle 用行坐标对这一行里的八个 sector 做 XOR 重排。
一个 SWIZZLE_128B atom 有八行,总大小 8 × 128 B = 1024 B。这里的 128 B 是 atom 沿连续维的行宽,不是 atom 总大小。Atom 是地址置换的最小重复块;更大的 tile 由多个 atom 拼成。
每个格子是一个 16 B sector。逐步看读周期,XOR 如何把列访问摊到不同 bank。
其他 swizzle 模式层级相同,只是行宽不同。SWIZZLE_64B 和 SWIZZLE_32B 的 atom 分别是 8 × 64 B 和 8 × 32 B。
选择 swizzle 格式和数据类型,查看对应 atom 形状(8 × N B)。悬停格子可看该元素在 atom 内被映到哪。
选哪种 swizzle?实用规则是:用 tile 能撑住的最大行宽 atom。行宽 N 字节的 atom,要求 tile 的连续维至少 N 字节,最好能被 N 整除。
行宽至少 128 字节(或 64 个 float16)时,通常优先 SWIZZLE_128B。连续维窄于 128 字节,就用能支持的最大替代:SWIZZLE_64B 或 SWIZZLE_32B。
对上面展示的 fp16 访问模式,SWIZZLE_128B 能让连续行读、以及跨八行的列读都无 conflict。这只在元素宽度、swizzle 模式和访问模式与硬件 descriptor 匹配时成立。改元素宽度、对齐或访问模式,冲突可能再出现。
实践里程序员不会手算 swizzle 地址。完整映射可以看成两步:S[...] 先把逻辑元素映到 @m 上的线性地址,swizzle 再重排这个地址。XOR 置换不是仿射的,所以 swizzle 不是仿射 layout 的一部分,而是叠在 layout 上的另一次地址变换。
访问同一块 tile 的所有操作必须用同一 swizzle 模式。真正做地址变换的是组合后的 layout。不同硬件单元对 swizzle 的要求不同,而且会随 GPU 代数变化。下一章讨论这些约束。