中文译本 · 原文 What Makes a Kernel Fast · MLC Community
什么样的 Kernel 才快
本章要点
- Roofline 用显存带宽和计算吞吐给 kernel 画一条性能天花板;算术强度决定碰的是哪一条。
- 算术强度低,通常是 memory-bound:优化重点是少走 HBM、提高复用、融合算子,尽量贴到带宽屋顶。
- 算术强度高,通常是 compute-bound:优化重点是让 Tensor Core 一直忙,用 overlap 减少计算路径上空闲。
Kernel 快不快,要相对一条天花板来说。单独看 330 TFLOP/s 好像很大,但在一块密集 fp16/bf16 Tensor Core 能到约 2 PFLOP/s 的 GPU 上,含义完全不同。没有天花板,就分不清实现已经贴硬件极限,还是芯片大半时间在闲着。
本章用 roofline 模型给出这个参照,并以 NVIDIA B200 为例。计算里用两个取整数字:密集 fp16/bf16 Tensor Core 约 2 PFLOP/s,HBM3e 带宽约 8 TB/s。真实成绩还受配置、频率、功耗墙和测量环境约束,所以这是方便演算的近似,不是规格书上的精确上限。
Roofline 模型
从性能分析看,kernel 的时间主要花在两件事:搬数据和做算术。Roofline 把天花板写成两者的下界:计算吞吐屋顶与显存带宽屋顶,取更低的那条。
计算屋顶是当前 kernel 所用计算路径能提供的最大 FLOP/s。B200 上密集 FP16/BF16 Tensor Core GEMM 通常由 Tensor Core 吞吐决定;标量或逐元素 kernel 则可能来自 CUDA core、特殊函数单元或其他执行单元。
带宽是某一级存储单位时间能传输的数据量,常用 GB/s 或 TB/s。上面的 8 TB/s 表示理想情况下 HBM 接口大约每秒搬 8 TB。带宽数字永远对应层级:HBM、L2、共享内存各不相同。除非另说,本章的「带宽」指 HBM 带宽。
有了带宽屋顶,访存侧天花板 ≈ HBM 带宽 × 算术强度。每个搬过的字节只做很少计算时,性能通常被 HBM 带宽卡住;每个字节能支撑很多运算时,才更可能走进 compute-bound 区,天花板改由计算吞吐决定。
以 FLOP/s 计,基本 bound 是:
可达性能 ≤ min(峰值算力, 带宽 × 算术强度)
算术强度是:
算术强度 = 计算量 / 搬过的数据量
「计算量」指算法需要的数学运算,通常用 FLOP 计,不是 kernel 执行的指令条数。约定:一次浮点加或乘算 1 FLOP;一次融合乘加 a * b + c 算 2 FLOP。
GEMM C = A @ B,若 A 为 M × K、B 为 K × N,计算量通常写成:
2 × M × N × K
必须指明存储层级。HBM roofline 数 HBM 字节,L2 数 L2 字节,SMEM 数共享内存字节。本章默认是 HBM roofline。
图上横轴是算术强度(FLOP/byte),纵轴是能达到的性能。带宽屋顶是斜线:
性能 = 带宽 × 算术强度
计算屋顶是水平线:
性能 = 峰值算力
两条线的交点叫 ridge point,是 memory-bound 与 compute-bound 的分界:
ridge point = 峰值算力 / 带宽
用本章 B200 取整数字(2 PFLOP/s = 2000 TFLOP/s,8 TB/s):
ridge point ≈ 2000 / 8 ≈ 250 FLOP/byte
粗分类时,把 kernel 的算术强度和 ridge point 比一下:
- 低于 ridge point:带宽斜线封顶,更可能 memory-bound。
- 高于 ridge point:计算水平线封顶,更可能 compute-bound。
- 靠近 ridge point:两条天花板接近,两边都可能要紧。
这只是初步分类,不能代替测量和 profiling。但它指出优化方向:memory-bound 时少做几条算术指令几乎没用;compute-bound 时抠一点访存也改变不了主瓶颈。
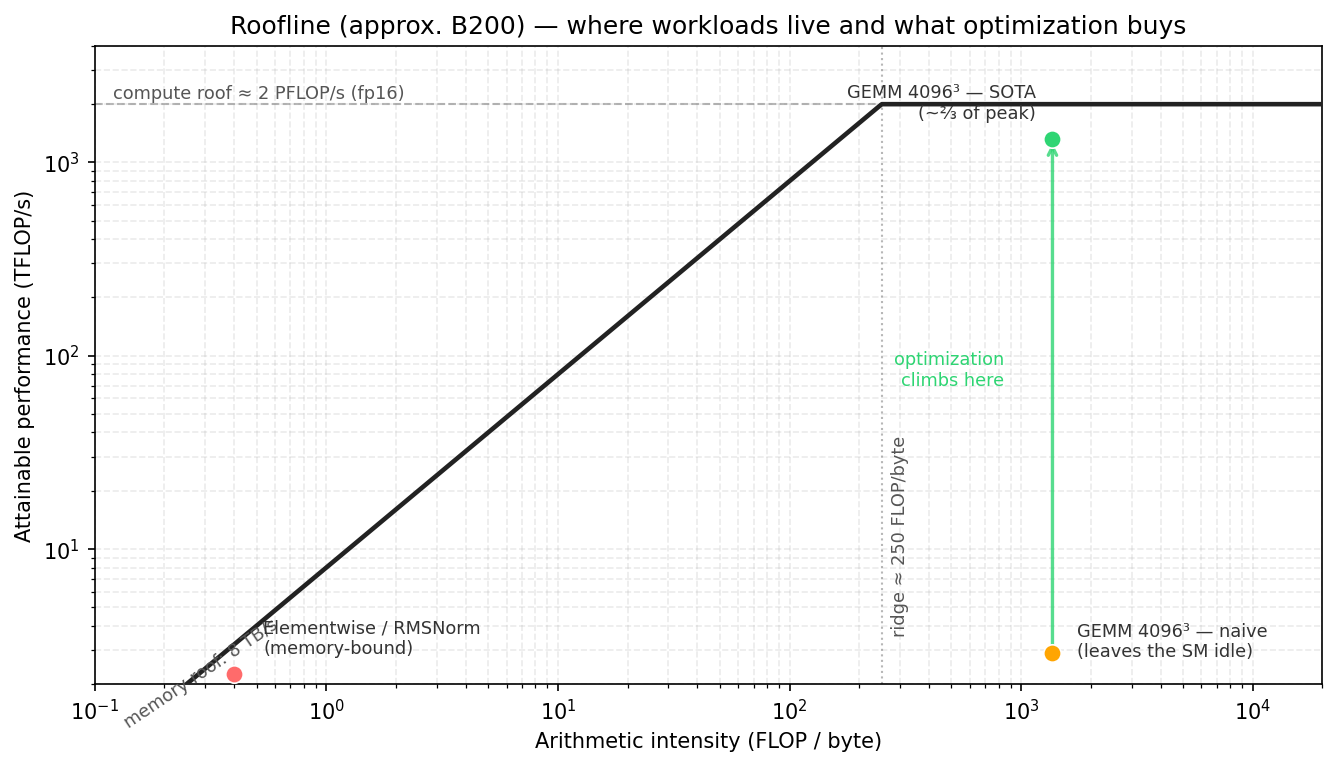
B200 roofline 与若干负载示例:带宽屋顶、计算屋顶,以及 ridge point。
常见负载的算术强度
算术强度首先取决于算法怎么复用数据。写 kernel 之前,往往就能对瓶颈做初步判断。
逐元素与 Reduction
GELU 这类逐元素核、RMSNorm 这类 reduction,通常要读写很大的 tensor,每个元素算得不多。算术强度低,落在 ridge point 左侧,性能主要受带宽限制。
GEMM
GEMM 正好相反。问题规模变大,算术强度跟着涨:装进来的 tile 可以复用很多次乘加。
方形 fp16 matmul,M = N = K 时,理想算术强度大约是:
AI ≈ 2N³ / (3 · 2N²) = N / 3 (FLOP/byte)
假设 A、B 各从 HBM 读一次,C 写一次,且 beta = 0(不必读旧 C);片上复用完美,没有额外 metadata、padding 或多余流量。Metadata 包括低精度格式的 scale 等辅助量。真实 kernel 通常搬得更多,但这个估计仍能看趋势。
Attention
Attention 介于两者之间。算术强度取决于序列长度、head 维、tiling、mask,以及中间 tensor 会不会落盘。
标准 attention 的大头之一是 QKᵀ 得到的 score 矩阵。把它写到 HBM 再读回来,访存量很大。Flash Attention(含 FA4)把相关 tile 留在片上,避开这一趟往返,从而提高算术强度。
因此 attention 优化有两层:算法层减少 HBM 流量、抬高算术强度;实现层把剩下的搬数和计算尽量 overlap。
优化 Memory-Bound Kernel
一旦确认是 memory-bound,优化有两条路:减少 HBM 流量以提高算术强度;流量已经减不下去时,让实际传输尽量贴到带宽天花板。
融合往往最直接。算术强度低,常见原因是中间 tensor:一个 kernel 写 HBM,下一个马上读回来。把生产者和消费者融在一起,值可以留在寄存器或片上(SMEM / TMEM),避开 HBM 往返。
- GEMM 与逐元素 epilogue 融合。
- 把归一化融进相邻算子。
- 算 attention 时不物化完整 score 矩阵。
另一条路是用 tiling(也称 blocking)提高复用:大问题切成小 tile,装进片上的数据多用几次。GEMM 里,一个 A 元素贡献同一行很多 C,一个 B 元素贡献同一列很多 C。每次用都从 HBM 重载,流量会很大。
把 A、B tile 留在片上,同样 2MNK 次运算只需更少 HBM 字节,算术强度上升。其他反复复用同一 tile 的负载也一样。
下面这个简化模型把复用写清楚。假设一个 CTA 算 C 的 BM × BN tile。每个 K-stage 装入 A 的 BM × BK 和 B 的 BK × BN,每个元素 s 字节。只数这一 stage 的 A/B 全局访存,忽略 C 的读写:
AI ≈ 2·BM·BN·BK / [s·(BM·BK + BK·BN)] = 2·BM·BN / [s·(BM + BN)]
若 BM = BN = B:
AI ≈ B / s
具体例子:整体 M,N,K 固定,总计算仍是 2MNK,只比较不同 CTA tile 带来的片上复用。dtype 为 FP16/BF16,s = 2 字节,每个 K-stage BK = 64。CTA tile 为 16 × 16 时,一 stage 的计算量:
2 × 16 × 16 × 64 = 32768
从全局内存读的 A/B 数据:
2 × (16×64 + 64×16) = 4096
于是这一 stage 的 A/B 算术强度是 32768 / 4096 = 8 FLOP/byte。CTA tile 改成 64 × 64、BK 仍为 64:
2 × 64 × 64 × 64 = 524288
2 × (64×64 + 64×64) = 16384
算术强度变成 524288 / 16384 = 32 FLOP/byte。更大的 tile 让从全局内存装入的每个 A/B 元素参与更多片上计算,同样工作量需要的搬数更少。
真实 kernel 还要算 C 的读写、L2 复用、occupancy、寄存器压力、SMEM 带宽、Tensor Core issue 率等。这个模型虽然简化,但抓住了 tiling 抬高算术强度的原因:从全局内存装入的一个 A/B 元素,能在 tile 内服务更多乘加。
再一种抬高算术强度的办法是更小的 dtype:fp32 → fp16、fp8、fp4,搬得更少、每字节有效运算更多。若低精度还要 metadata、scale 或转换,收益会小于只看位宽。Scale 用来恢复低精度的数值范围;block-scaled fp8/fp4 就需要它们。即便如此,更小 dtype 仍是直接抬 AI 的手段。
算术强度再也抬不上去时,目标改成有效带宽。纯 copy、简单逐元素、对大 tensor 的单遍 reduction,往往既没有可融的中间值,也没有足够复用。这时:
- 每个字节只搬一次,避免多余读。
- 用 coalesced 或向量化访问。
- 规则的大块 tile 用 TMA。
- 让足够多的访存请求在飞,避免存储流水线空转。
Memory-bound kernel 一旦贴上带宽屋顶,再抠计算也没用。要更快,只能改算法,少搬字节。
优化阶梯
Roofline 指出天花板,但没告诉你怎样实现才能靠近它。
很大的 fp16 GEMM 理论上可以是 compute-bound。这只说明 HBM 级带宽屋顶不是主限制,并不表示随便一个实现就能摸到 Tensor Core 计算屋顶。要把缝补上,需要正确的指令、layout、staging、同步和调度。后面的 GEMM 章节会在 B200 上一步步做:算法不变,改的是 tile 怎么算、怎么排。
GEMM 优化阶梯上,第一次大的实测跳变,是从线程 copy 的 tiled 路径换到 TMA 路径。前者用普通 CTA 线程把 tile 从 GMEM 拷到 SMEM;后者把这种规则搬运交给 TMA。TMA 用硬件 bulk copy 填 SMEM,MMA 再从 SMEM 读。
这一跳之后,后续优化都在问:数据搬运、Tensor Core 计算、epilogue 之间怎样少互相等?软件流水和 warp specialization 重排这些阶段,让不同硬件单元同时干活。下一节看这种调度。
有些结构改动不会立刻变快。例如 warp specialization 可能暂时更吃资源,但它为后面更复杂的 overlap 提供骨架。
下图预览 GEMM 章节里的优化路径。每个点对应一种实现结构;后面会分别讲 TMA、warp specialization、CTA cluster 和 multi-consumer 改了什么。
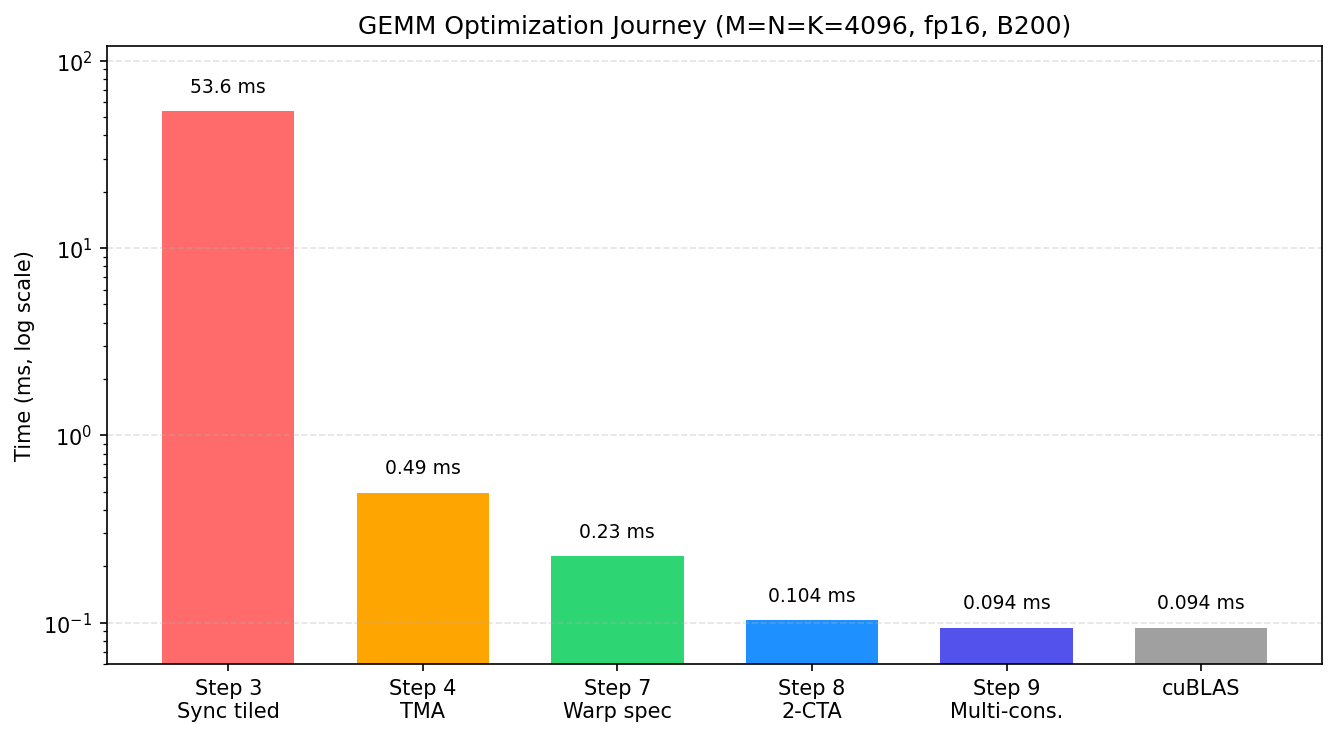
B200 上的 GEMM 优化路径:从同步 tiled 基线,经 TMA、warp specialization、CTA cluster,到 multi-consumer。
用 Overlap 减少空闲
GEMM 已经 compute-bound、也已经在用 Tensor Core 时,剩下的差距通常来自某条执行路径没有打满。
朴素 kernel 可能这样排:
load tile k
compute tile k
store tile k
load tile k + 1
compute tile k + 1
store tile k + 1
硬件单元会轮流闲着:load 时 Tensor Core 等;计算时 copy 引擎闲;store 排空时两边都等。
流水 kernel 则尽量让独立阶段一起跑:
load tile k + 1
compute tile k
store tile k - 1
在 Blackwell 上,这三步主要分别由 TMA、tcgen05.mma 和 epilogue/store 路径执行;mbarrier 协调完成与 buffer 所有权。
Overlap 并不取消依赖。tile k 的 MMA 仍要等它 load 完,epilogue 仍要等 MMA 完。Kernel 能做的是推进独立工作:例如 load k+1,或写回 k-1。
Occupancy 与资源压力
除了 overlap,GPU 还可以通过提高 SM occupancy 来藏延迟。
SM occupancy 描述一个 SM 上能同时驻留多少工作。某个 warp stall 时,调度器可以跑另一个就绪 warp,从而藏住延迟。
限制 occupancy 的是寄存器、共享内存、warp slot 和 CTA slot。后两者规定一个 SM 最多驻留多少 warp / CTA。每线程寄存器太多,或每 CTA 共享内存太大,能塞进去的 CTA/warp 就变少,occupancy 下降。
许多现代 Tensor Core kernel 会故意把资源花在会压低 occupancy 的地方:多级 SMEM 流水吃共享内存;大的寄存器 fragment 吃寄存器;TMEM 分配吃 Tensor Memory;warp specialization 可能整 warp 专门当 producer/consumer。
这是有意的取舍。它们不靠大量驻留 warp 藏延迟,而是在较少的驻留 CTA 里显式 overlap 各阶段。occupancy 低的 kernel 只要流水能让 TMA、Tensor Core、store 路径一直忙,仍然可以很快。
两条路各有场景。访存不规则、不好做显式流水的 kernel,更依赖高 occupancy;深度 staging 加 warp specialization 的 kernel,可能用 occupancy 换更强 overlap。Occupancy 本身不是好坏指标;关键是关键硬件单元是否一直在干活。
用 Roofline 指导优化
实际分析可以分三步:
- 估算算术强度:每个搬走的字节对应多少计算?
- 和 ridge point 比较,判断更可能卡带宽还是卡算力。
- 测量实现离对应屋顶还有多远,再去优化真正卡住的那项资源。
Memory-bound:少搬数据,让传输贴近带宽屋顶。Compute-bound:减少计算单元空闲。Roofline 给不出最终实现,但能避免把力气花在不是瓶颈的资源上。
解释 roofline 之前,测量必须可信。计时、用 Proton 找贵的 launch、用 Nsight Compute 验证硬件假设,这些流程收在附录「测量与分析 GPU Kernel 性能」(尚未译出)。