动作分块流策略的实时执行
中文译本 · 原文 arXiv 2506.07339 · PDF 下载 · 视频与博客 pi.website/research/real_time_chunking · 仿真代码 GitHub · 图表均取自原文 arXiv 源文件
摘要
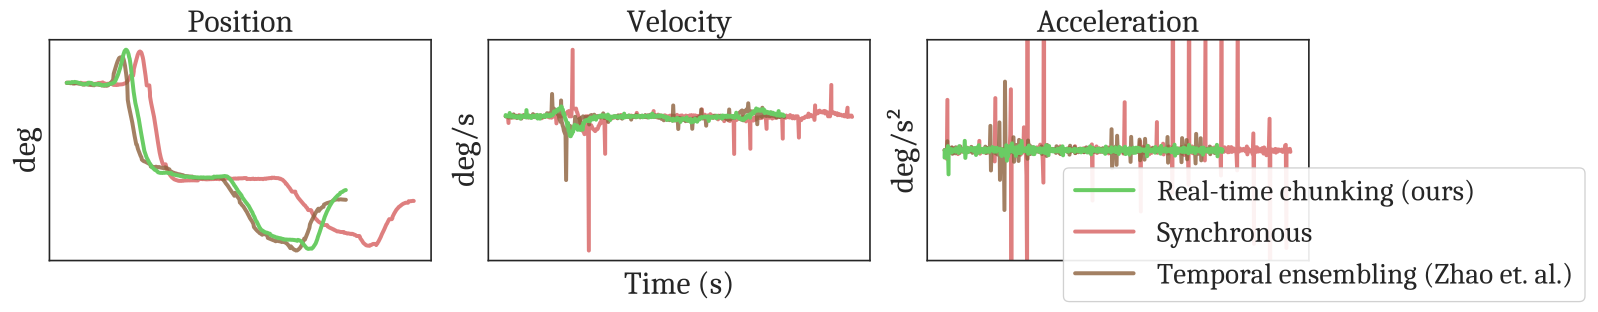
现代 AI 系统,尤其是与物理世界交互的系统,越来越需要实时性能。 然而最先进的通用模型(包括近期的视觉-语言-动作模型,VLA)延迟很高,这带来了很大挑战。 动作分块让高频控制任务获得了时间上的一致性,却没有彻底解决延迟问题, 会在动作块的边界处造成停顿,或出现分布外的抖动动作。 本文提出一种新的推理期算法,使动作分块策略能够平滑地异步执行。 我们的方法称为实时分块(real-time chunking,RTC), 可以直接用于任何基于扩散或流(flow)的 VLA,无需重新训练。 它在执行当前动作块的同时生成下一个动作块:把一定会被执行的动作“冻结”,再对其余部分做“修补”(inpainting)。 为了测试 RTC,我们在 Kinetix 模拟器中构建了一个包含 12 个高动态任务的新基准, 并在 6 个有挑战性的真实双臂操作任务上进行了评估。 结果表明,RTC 速度快、效果好,并且对推理延迟具有独特的鲁棒性:它显著提升了任务吞吐量, 即使存在明显的延迟,也能在点火柴这类精细任务上取得很高的成功率。 视频见 https://pi.website/research/real_time_chunking。
1 引言
随着 AI 系统能力不断增强,它们与环境的交互也越来越直接。无论是执行终端命令 [45]、 在直播中玩宝可梦 [20],还是代替你浏览网页 [65], 近期主要由大规模深度学习驱动的进展,使这些系统越来越多地去控制外部世界的巨大多样性,而不只是处理它。 具身智能体——机器学习模型直接控制真实的物理装置——也许是最典型的例子。 推动语言、视觉智能体发展的同一批进展,也在人形机器人 [4] 到自动驾驶汽车 [60] 等平台上,大幅推进了物理智能。
与聊天机器人和图像生成器不同,信息物理系统总是在实时运行。 机器人在“思考”的时候,周围的世界仍按物理规律演化,因此输入到输出之间的延迟会切实影响表现。 对语言模型来说,生成快慢的区别只是用户满意还是恼火;而对机器人动作模型来说, 这可能就是机器人把热咖啡递给你,还是把它洒在你腿上的区别。
不幸的是,现代大规模机器学习的有效性,不可避免地伴随着高延迟这一副作用。 大语言模型(LLM)、视觉语言模型(VLM)和视觉-语言-动作模型(VLA,指一类为视觉运动控制设计的模型) 都有数十亿参数 [8, 30, 5, 4, 58]。 这些模型不仅运行慢,还需要重型硬件,很难装到移动机器人这样的边缘设备上;改用远程推理又会带来额外开销。 边缘硬件会随时间进步,但随着机器人数据集变大,最好的 VLA 也会跟着变大 [28]。
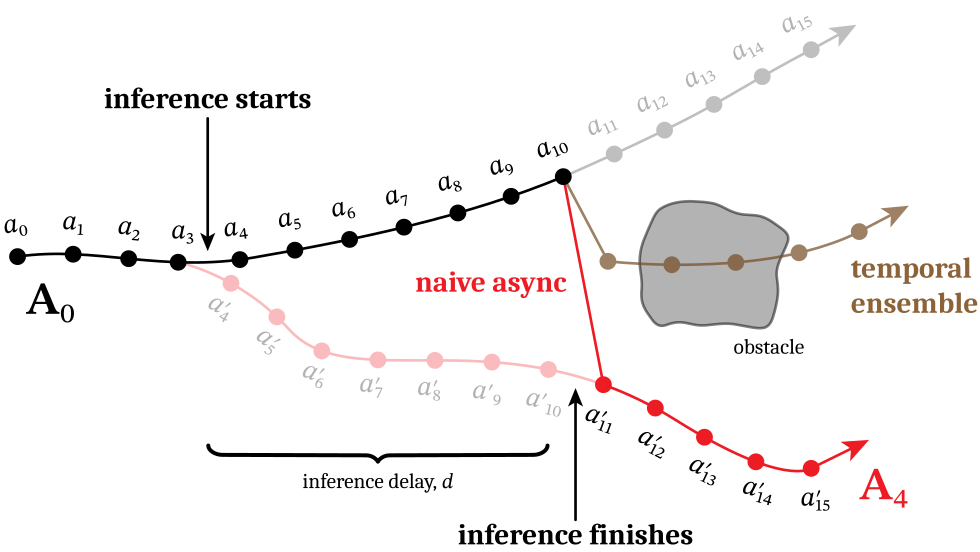
因此,要把大模型有效用于实时控制,就需要某种形式的异步性:模型必须一边执行之前的动作,一边思考未来的动作。 动作分块 [68, 33, 11]——模型每次推理输出并执行一串动作——提供了部分解决方案。 虽然动作分块已在灵巧操作上取得许多最好结果 [5, 4, 58],它仍然受延迟问题困扰。 分块牺牲了系统对外部刺激的反应能力,并且会在块与块的衔接点引入不连续, 因为相邻的块可能会在学到的动作分布的不同模式(或“策略”)之间跳变。 这种异常对基于学习的系统尤其有害:它造成了动力学上的分布偏移,而模型很可能无法应对。 朴素的平滑策略,比如对多个预测取平均 [68],并不能保证产生有效动作,甚至可能让情况更糟(例如见图 2)。
好的实时系统必须产生一致、连续的控制信号,既能纳入最新的观测,又不干扰环境本身的自然动力学,也不损害模型产生正确动作的能力。 本文提出实时分块(RTC),把异步动作分块表述为一个修补问题。 我们的算法在执行上一个动作块的同时生成下一个动作块:把(由于推理延迟)一定会被执行的动作冻结,并“修补”其余部分。 它适用于任何基于扩散 [22] 或流 [36] 的 VLA,并且完全在推理期运行,不需要改动现有训练方法。
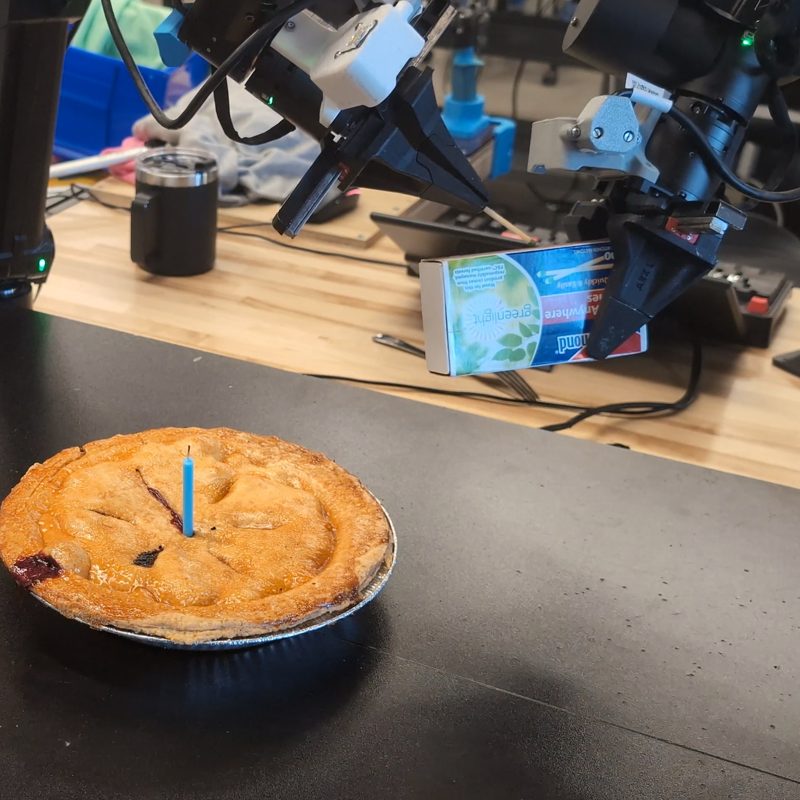
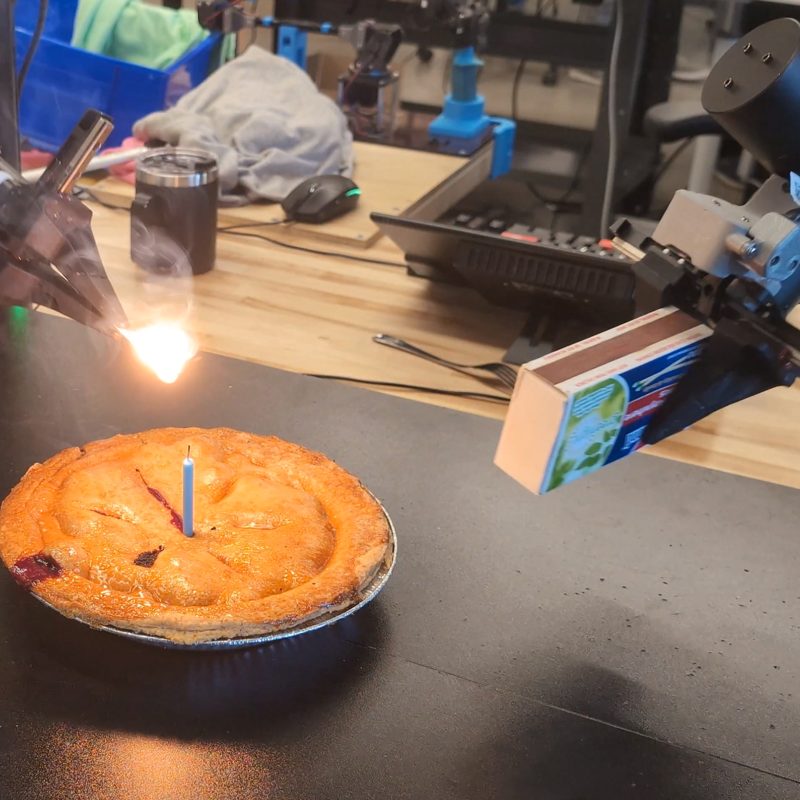
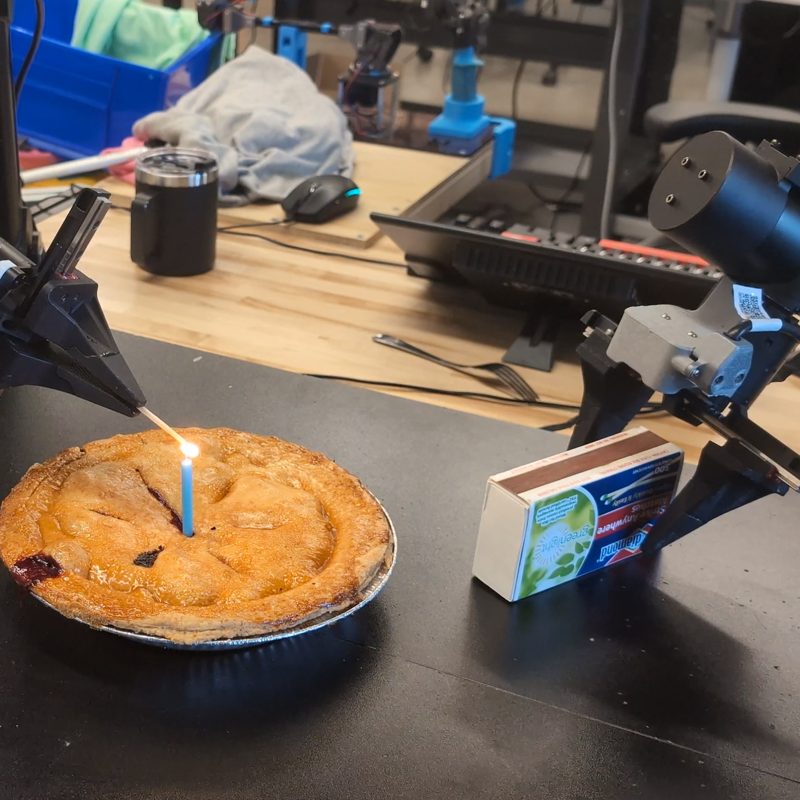
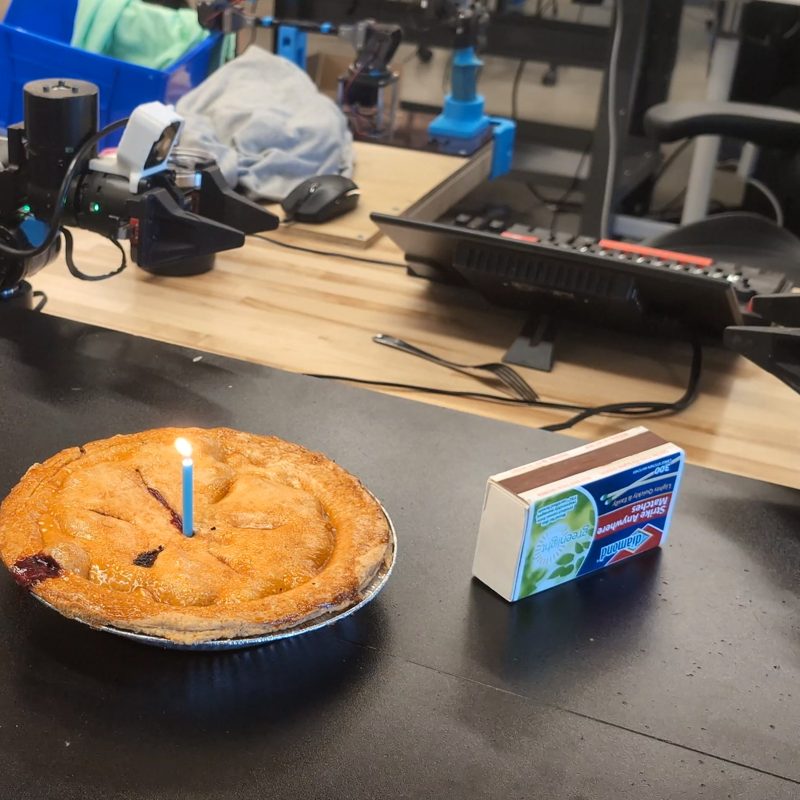
我们的贡献如下。第一,我们提出一个新系统,用于对连续控制中的扩散或流动作分块策略进行异步、实时推理。 由于标准仿真基准大多是准静态的,并且基本已被伪开环推理策略做到饱和 [11], 我们基于 Kinetix 模拟器 [43] 设计了一个新基准,包含 12 个高动态的操作与运动任务。 在真实世界中,我们以 π₀.₅ VLA [24] 为基础策略,在 6 个有挑战性的双臂操作任务上评估 RTC。 在仿真与真实世界中,我们都表明 RTC 速度快、效果好:它对推理延迟具有独特的鲁棒性, 即使在点火柴这类高精度任务上也是如此(图 1),并且在所有真实任务上都大幅提升了任务吞吐量。
2 预备知识与动机
我们从一个动作分块策略 \(\pi(\bA_t \mid \bo_t)\) 开始,其中 \(\bA_t = [\ba_{t}, \ba_{t+1}, \ldots, \ba_{t+H-1}]\) 是未来动作的一个块,\(\bo_t\) 是观测,\(t\) 表示控制器时间步。 我们称 \(H\) 为预测时域。 动作分块策略在执行时,每个块只执行前 \(s \le H\) 个动作。我们称 \(s\) 为执行时域; 它通常比预测时域短,但仍远大于 1(例如 \(s \approx H/2\) [11, 5, 24])。 分块执行以牺牲反应能力为代价保证时间一致性:执行时域长,策略对新信息的响应就差; 执行时域短,则更容易因块间不连续而出现模式跳变和抖动行为。
本文考虑用条件流匹配 [36] 训练的策略,不过通过在推理期把扩散策略转换成流策略 [48, 18],我们的方法也能用于扩散策略。 要从流策略生成一个动作块,先从标准高斯分布采样随机噪声 \(\bA_t^0\), 再用下面的更新规则,把流的速度场 \(\bv_\pi\)(一个学到的神经网络)从 \(\tau = 0\) 积分到 1:
其中 \(\tau \in [0, 1)\) 表示流匹配时间步,\(n\) 决定去噪步数。
现在设 \(\Delta t\) 为控制器的采样周期(即一个控制器时间步的时长),\(\delta\) 为策略生成一个动作块所需的时间。 如果一个系统能保证在固定时间约束(\(\Delta t\))内对一个事件(收到 \(\bo_t\))作出响应(这里是 \(\ba_t\)),我们就称它是实时的。 如果 \(\delta \le \Delta t\),满足实时约束就很简单,因为在两个控制步之间就能生成整个动作块。 但对现代 VLA 来说这几乎不可能做到。例如在 RTX 4090 GPU 上,30 亿参数的 π₀ VLA 光是 KV cache 预填充就要 46ms, 这还没算任何去噪步 [5];而它的目标控制频率是 50Hz(\(\Delta t = 20\)ms)。 用于移动操作的远程推理时,π₀ 报告在有线连接、理想条件下的网络延迟为 13ms;在更现实的场景中,仅网络开销就很容易超过 20ms。 Kim et al. [31] 专门为推理速度优化了 70 亿参数的 OpenVLA 模型 [30], 在服务器级 A100 GPU 上也只能做到 321ms 的延迟。
朴素的同步推理是许多已有工作的默认做法 [5, 30, 8, 24, 31, 59]: 它在执行时域结束时才开始推理,并在策略生成下一个块期间原地等待。 当 \(\delta > \Delta t\) 时,这会在块与块之间引入明显的停顿,不仅拖慢执行,还改变了机器人的动力学, 在训练与评估之间引入分布偏移。为了设计实时策略,我们首先需要引入异步推理:提前开始推理,让推理与执行并发进行。
我们定义 \(d := \lfloor \delta / \Delta t \rfloor\),称之为推理延迟,它对应从收到 \(\bo_t\) 到 \(\bA_t\) 可用之间相隔的控制器时间步数。1 记 \(\ba_{t' \mid t}\) 为动作块 \(\bA_t\)(由观测 \(\bo_t\) 生成)中的第 \((t' - t)\) 个动作。 如果当前正在执行 \(\bA_0\),并希望执行时域为 \(s\),那么异步算法必须在 \(s - d\) 时刻开始推理。 只要 \(d \le H - s\),这种策略就满足实时约束,保证需要动作时总有动作可用。 然而,由于策略在生成 \(\bA_{s-d}\) 时无法知道第 \(s - d\) 步到第 \(s\) 步之间会发生什么, \(\ba_{s - 1 \mid 0}\) 与 \(\ba_{s \mid s-d}\) 之间的衔接点可能任意不连续,并且处于分布之外。 与过短的执行时域类似,这种策略会导致抖动行为,并且延迟越大问题越严重;见图 2。
1 为简化起见,我们不考虑子时间步级别的延迟或同步问题; 假设环境或底层控制器在 \(\ba_{t-1}\) 被消费的同一时刻提供 \(\bo_t\)。
3 基于修补的实时分块
实时执行的关键挑战是保持块与块之间的连续性。新块可用时,上一个块已经执行了一部分,因此新块必须与上一个块“兼容”。 同时,新块仍应纳入新的观测,使策略不失去反应和纠正的能力。
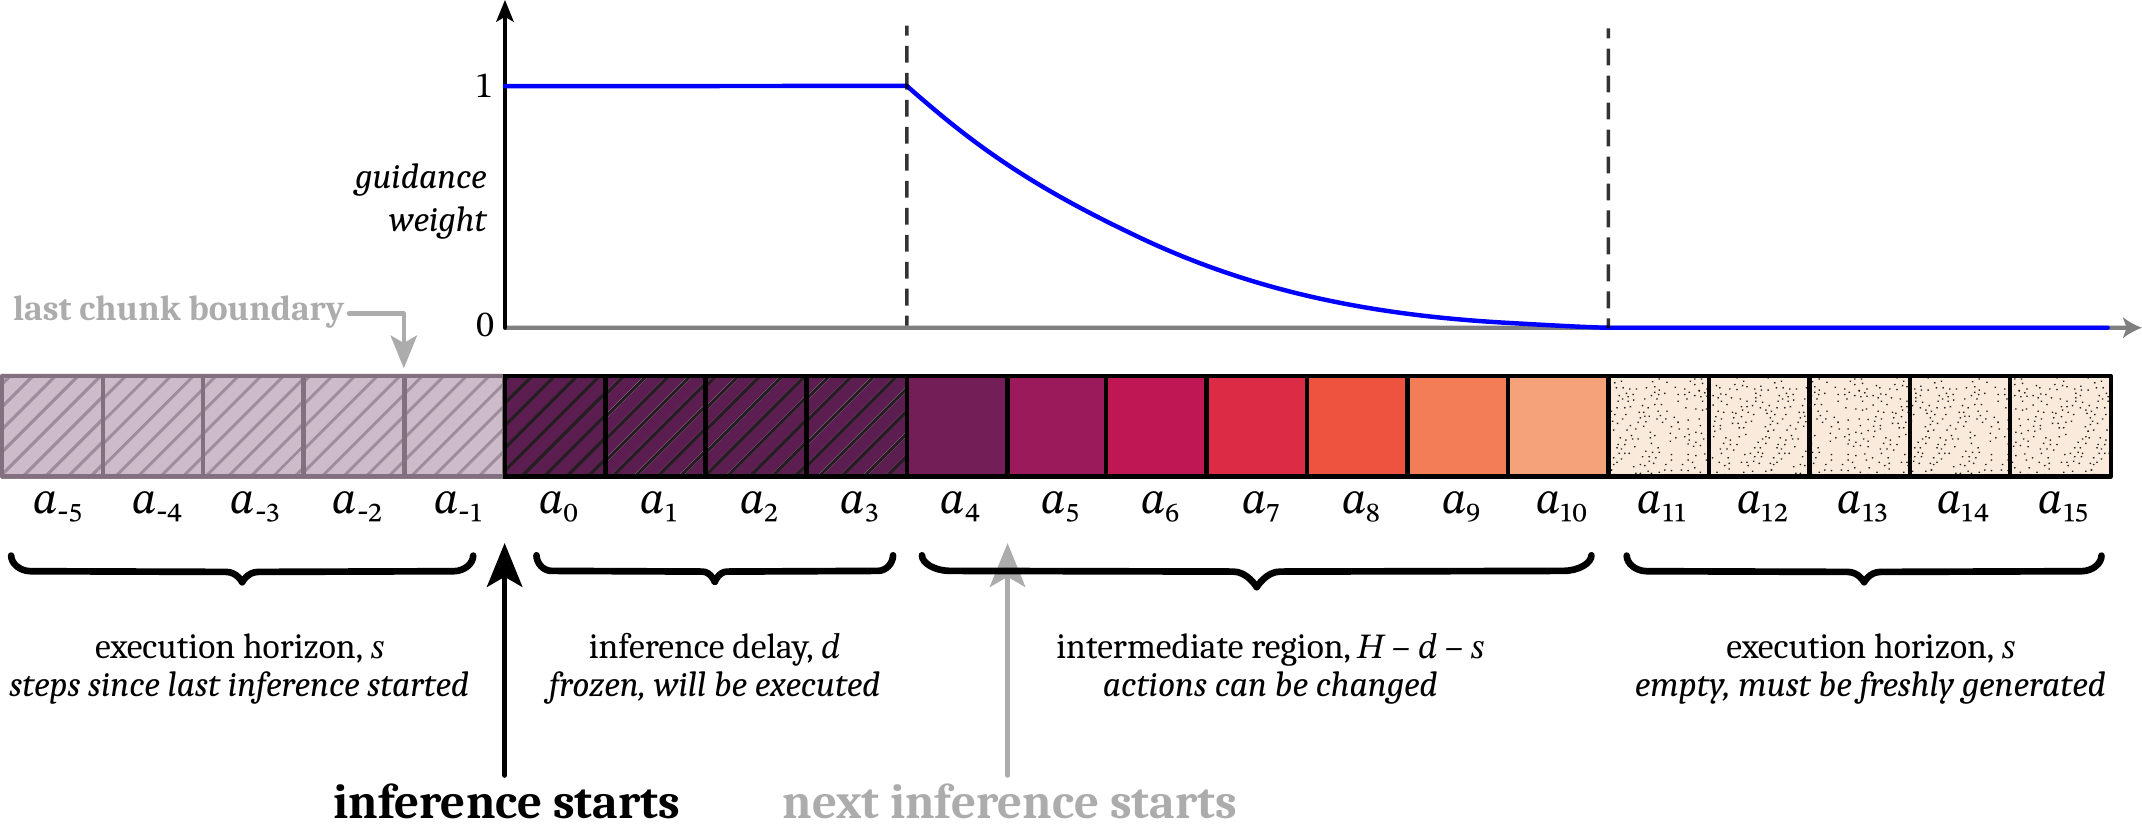
我们的核心洞见是把实时分块表述为一个修补问题。 要让新块“兼容”,就必须利用重叠的时间步——在这些时间步上,我们能拿到上一个块剩余的动作。 新块的前 \(d\) 个动作无法使用,因为新块可用时这些时间步已经过去了。 因此合理的做法是把这些动作“冻结”为我们知道将会被执行的值; 目标就变成以与这个冻结前缀一致的方式填充新块的其余部分(见图 3),这很像修补图像中被抠掉的一块区域。 我们在 3.1 节介绍这一基本修补原理; 在 3.2 节介绍对实现完整跨块连续性至关重要的软掩码扩展; 最后在 3.3 节介绍完整的实时分块系统。
3.1 基于流匹配的推理期修补
修补是扩散、流匹配这类迭代去噪框架的已知长项。我们基于 Pokle et al. [48] 的免训练图像修补算法, 该算法本身基于伪逆引导(ΠGDM;[55])。 算法的做法是在每个去噪步(式 1)给学到的速度场 \(\bv\) 加一个基于梯度的引导项, 促使最终生成结果匹配某个目标值 \(\bY\),而 \(\bY\) 是期望结果的一个被破坏的版本。 对图像修补而言,破坏算子是掩码,\(\bY\) 是被掩码的图像,期望结果是一张在非掩码区域与 \(\bY\) 一致的完整图像。 针对我们的场景,ΠGDM 的梯度修正为:
\(\widehat{\bA^1_t}\) 是对最终完全去噪后动作块的估计,\(\bW\) 是掩码。 这里我们滥用了记号,把 \(\bY\)、\(\bA_t\) 和 \(\bW\) 都当作维度为 \(HM\) 的向量,其中 \(M\) 是每个动作的维度。 因此引导项是一个向量-雅可比积,可以用反向传播计算。 引导权重截断 \(\beta\) 是我们新加的;我们发现,在控制问题常用的少量去噪步下,不加截断算法会变得不稳定 (消融见附录 A.2)。
3.2 用软掩码改善跨块连续性
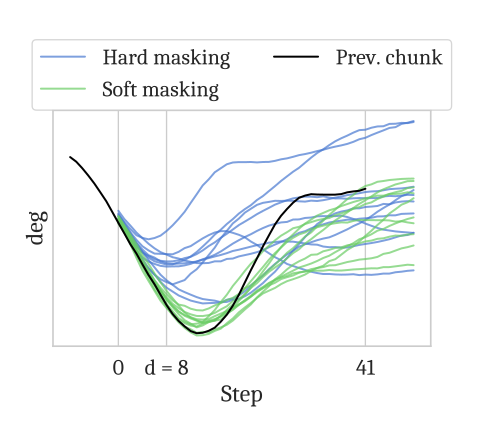
实践中,只用上一个动作块的前 \(d\) 个时间步做朴素修补,往往不足以保证新块采取一致的策略, 在 \(d\) 较小时尤其如此(例如见图 4)。 ΠGDM 修正并不完美,\(d\) 小意味着引导信号弱,新块仍可能切换策略并造成不连续。 我们的解决办法如图 3所示:不只考虑前 \(d\) 个重叠动作,而是考虑全部 \(H - s\) 个重叠动作, 从而给策略更多的跨块连续性。我们通过软掩码做到这一点,即把 \(\bW\) 设为实数权重,而不是 0 和 1。 前 \(d\) 个动作权重为 1;新块的最后 \(s\) 个动作与上一个块没有重叠,权重为 0; 两者之间的动作权重从 1 指数衰减到 0,以体现越远的未来动作越不确定。\(\bW\) 的表达式为:
直观地说,\(\bW\) 调节了对上一个块中各个对应动作的“关注程度”。不同衰减方案的比较见附录 A.4。
3.3 实时分块
我们在算法 1中给出完整的实时分块系统(配合图 3阅读)。
控制器通过 GetAction 与我们的算法交互:每隔 \(\Delta t\) 调用一次,消费一个动作 \(\ba_{t-1}\) 并提供下一个观测 \(\bo_t\)。
InferenceLoop 在后台线程运行,保证始终有动作可用。它通过维护一个过往延迟的缓冲区来预测下一次延迟 \(d\)。
执行时域 \(s\) 可以逐块变化:用户给出期望的最小时域 \(s_\text{min}\),某个块的实际时域为 \(\max(d, s_\text{min})\),
其中 \(d\) 是计算下一个块时遇到的延迟。
最后,算法在 GuidedInference 中描述了带软掩码的修补过程:它显式定义了一个去噪函数(式 3),
并计算向量-雅可比积,这可以通过反向模式自动微分 [2] 完成。
4 实验
实验旨在回答以下问题。第一,在高动态、随机的环境中,以及推理延迟不断增大时,RTC 与现有方法相比如何? 第二,软掩码(3.2 节)对 RTC 有多重要?第三,RTC 如何影响真实灵巧机器人的表现和速度?
我们首先在 Kinetix [43] 模拟器中,用一个包含 12 个高动态、随机环境的基准评估 RTC, 借此在模拟推理延迟下比较 RTC 与其他方法的表现,并研究软掩码的作用。 然后以 π₀.₅ VLA [24] 为基础模型,在 6 个有挑战性的双臂灵巧操作任务(含 2 个移动操作任务)上评估 RTC 的表现和速度。
4.1 仿真基准
大多数仿真模仿学习基准是准静态的,只要执行时域足够长,标准分块执行就能达到接近完美的成功率 [11]。 我们转而在 Kinetix [43] 中构建了一个包含 12 个动态任务的基准。 Kinetix 使用基于力的控制,因此推理延迟必然要求异步执行(不存在“保持位置”的概念)。 我们选取了 10 个已有环境,并新建了 2 个,使所有环境都涉及抛、接、平衡等动态动作。 为了模拟不完美的执行器,我们在动作上加入高斯噪声,使闭环纠正成为成功的关键。
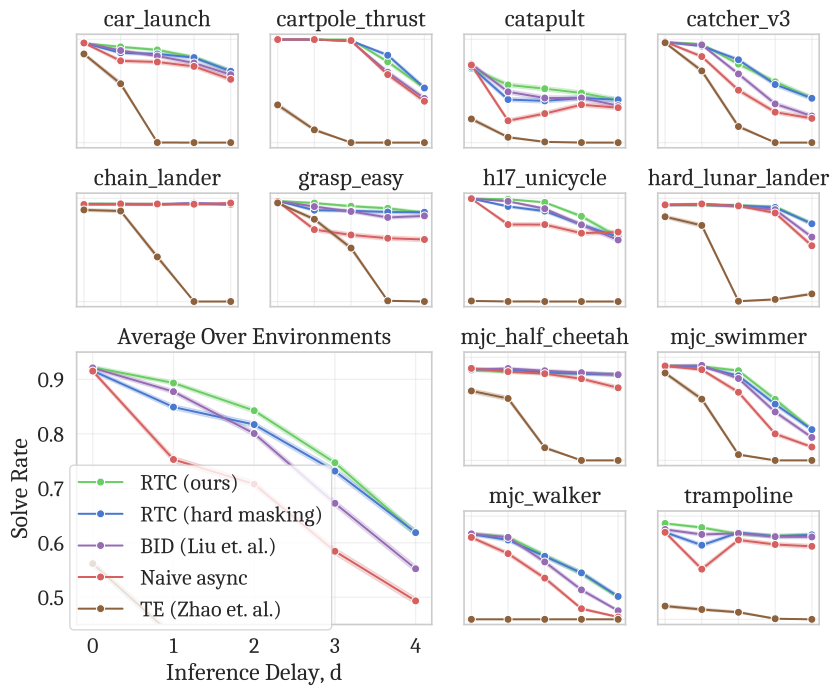
设置。为了生成模仿学习数据,我们先用 RPO [50] 和二值成功奖励训练专家策略。 每个环境用不同随机种子训练 6 个专家策略,再生成 100 万条转移的数据集,每个回合随机选用其中一个策略。 然后训练预测时域 \(H = 8\) 的动作分块流策略,网络为 4 层 MLP-Mixer [61],训练 32 个 epoch。 我们报告二值成功率,每个数据点 2048 次 rollout,模拟的延迟从 0(完全闭环)到 4(\(H = 8\) 时支持的最大值)。
基线。我们与以下基线比较:
- 朴素异步(Naive async)。生成新动作块时完全不关注上一个块,新块一就绪就直接切换。
- 双向解码(BID;[39])。用拒绝采样保持跨块连续性。我们使用批大小 \(N = 32\)、模式大小 \(K = 3\),并用训练了 8 个 epoch 的检查点作为弱策略。
- 时间集成(TE;[68])。维护一个已预测动作块的缓冲区,对某一时间步执行所有预测动作的平均值。
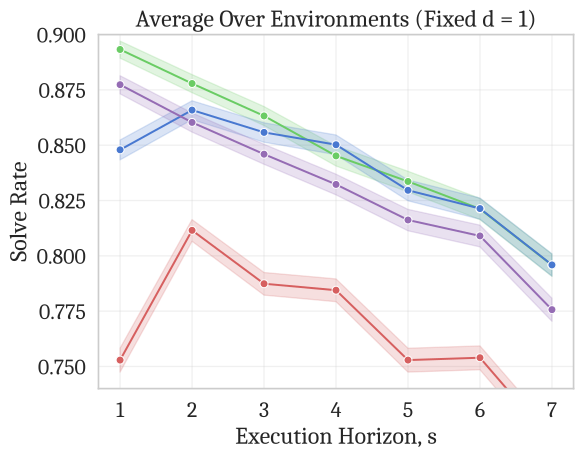
结果。图 5 给出了仿真结果。在延迟曲线(右)中:TE 全面表现很差,即使推理延迟 \(d = 0\) 也是如此, 这说明我们的基准具有多模态性——有效动作的平均值不一定有效。 RTC 对推理延迟最鲁棒,优于 BID,而且延迟越大差距越大;注意 BID 的计算量明显高于 RTC, 它要采样 64 个动作块的批次,其中 32 个来自强模型、32 个来自弱模型。 此外,我们发现硬掩码的表现略逊于软掩码,在 \(d\) 较小时尤其明显,这支持了我们在 3.2 节中的论断。 最后,在执行时域曲线(左)中,得益于跨块连续性,RTC 能更好地利用闭环纠正,执行时域越短表现总是越好。
4.2 真实世界结果
接下来我们把完整的实时分块系统部署到真实世界。我们以 π₀.₅ VLA [24] 为基础策略, 在一个由两只 6 自由度机械臂和平行夹爪组成的双臂系统上评估 RTC。 与仿真基准不同,这里的机器人使用位置控制,因此同步推理——在块之间停下来——是一种合理的默认策略, 许多已有工作都采用它 [5, 24, 31, 47]。 我们的目标是在表现和速度两方面都超越同步推理。
设置。我们使用 π₀.₅(\(H = 50\),\(\Delta t = 20\)ms),去噪步数 \(n = 5\), 基线的模型延迟为 76ms,RTC 为 97ms。我们通过局域网做远程推理,额外增加 10–20ms 延迟, 使 RTC 的初始推理延迟约为 \(d \approx 6\)。不过我们也想了解系统在更高推理延迟下的行为, 以模拟比如模型规模扩大、或在遥远的云服务器上推理的情况。 因此我们还在额外注入 +100ms 和 +200ms 延迟的条件下评估所有方法,分别对应 \(d \approx 11\) 和 \(d \approx 16\)。
任务与评分。每个回合得到一个整数分数,对应成功完成了任务的多少个子步骤。我们评估以下任务:
- 点蜡烛(5 步,限时 40 秒)。拿起火柴和火柴盒,划燃火柴,用它点燃蜡烛,然后把火柴丢进碗里。
- 插网线(6 步,限时 120 秒)。拿起网线的一端,调整朝向,插入服务器机架,然后对另一端重复这一过程。
- 铺床,移动操作(3 步,限时 200 秒)。把毯子的一角和 2 个枕头从床尾移到床头。
- 叠衬衫(1 步,限时 300 秒)。把一件摊平的衬衫叠好。
- 批量叠衣(4 步,限时 300 秒)。从箱子里取出一件款式各异、揉成一团的衣物,摊平、叠好,再整齐地放到一摞衣服上。
- 碗碟入水槽,移动操作(8 步,限时 300 秒)。把台面上 4 件不同物品移入水槽。
各任务的视频见配套博客。每个任务、每种方法评估 10 次,共 480 个回合,纯机器人执行时间合计 28 小时。 我们还事后标注了每个回合的分数,以及每个子步骤完成的时间戳。
基线。我们与以下基线比较:
- 同步(Synchronous)。对应已有工作的默认推理策略 [5, 24, 31, 47]:执行 \(s = 25\) 个动作,然后暂停等待新块生成。
- TE,稀疏(TE, sparse)。类似仿真结果中的朴素异步:每次执行 \(s = 25\) 个动作,同时并行计算下一个块。我们发现再叠加 TE 能显著减少抖动,尽管每个块只有前 \(H - s - 2d\) 个执行步有可用于集成的重叠动作。
- TE,密集(TE, dense)。这是最接近 Zhao et al. [68] 原始 TE 的策略。我们尽可能频繁地推理,使每个块的 \(s = d\)。这样始终至少有 2 个重叠的动作块可以集成,往往更多。
我们没有在真实世界中与 BID [39] 比较,因为在仿真中发现它不如 RTC,且计算量明显更大—— 以批大小 16 应用于 π₀.₅ 时,BID 的延迟是我们方法的 2.3 倍(延迟测量见附录 A.3)。
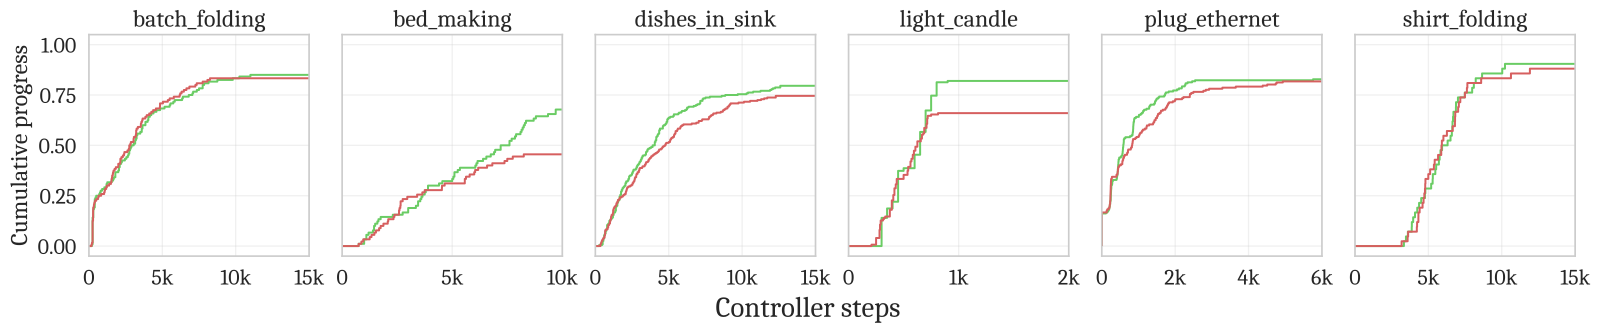
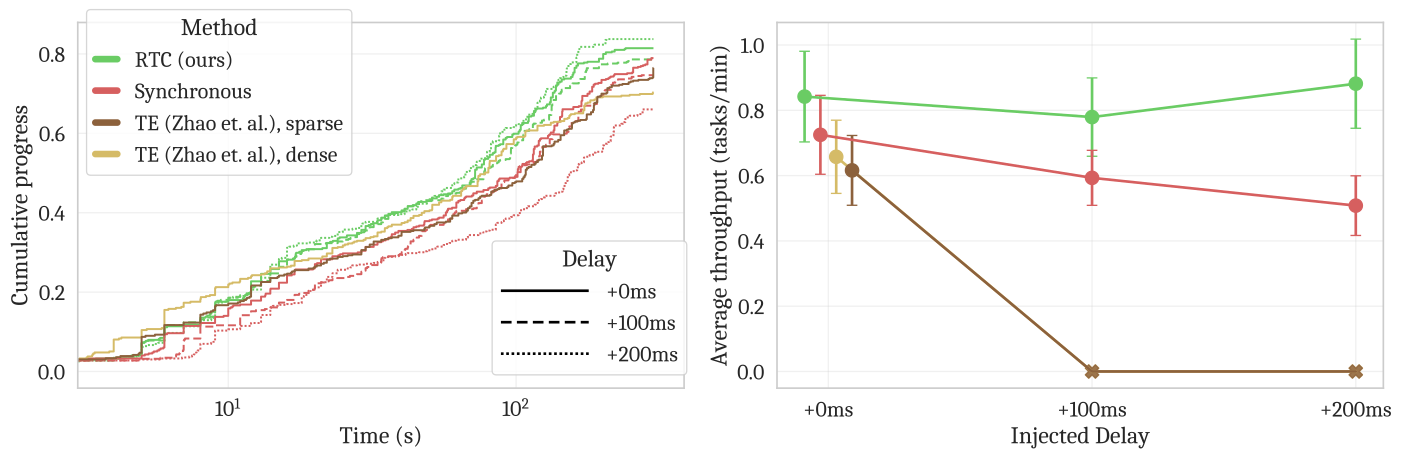
结果。结果见图 6。在同时衡量速度和表现的平均任务吞吐量上, RTC 在所有推理延迟下都取得最好成绩,在 +100ms 和 +200ms 下差异具有统计显著性。 RTC 对注入延迟完全鲁棒,没有任何退化;而同步推理线性退化,两种 TE 变体则因引起剧烈振荡触发了机器人的保护性停机,根本无法运行(见视频)。 查看各任务结果(图 6 上)译注,可以得出结论:RTC 的帮助不只是执行速度—— 即使去掉推理停顿,它完成任务也比同步推理更快。 除了点蜡烛之外,所有任务都允许在时限内重试(π₀.₅ 总体上也表现出稳健的重试行为)。 尽管同步推理常常能达到相近的最终分数,RTC 往往能在回合更早的阶段完成更多任务步骤,说明它犯错和重试更少。 在精度最敏感、也是唯一不允许重试的点蜡烛任务中,RTC 在最终分数上优势很大,体现了更高的整体成功率。 有趣的是,铺床任务也是如此,尽管该任务会引发重试。策略在摆弄枕头时尤其吃力,铺床是整体最难的任务, 这也许是 RTC 在其中效果显著的原因。
译注:原文此处写作 “Figure 5, top”(即仿真结果图),从上下文看应指图 6 上方的各任务结果图,译文据此更正。
5 相关工作
动作分块、VLA 与串级控制。动作分块部分受人类运动控制启发 [33], 近来已成为视觉运动控制模仿学习的事实标准 [68, 11]。 从人类数据学习生成动作块需要表达能力强的统计模型,例如变分推断 [68, 19]、 扩散 [11, 12, 69, 68, 46, 59]、 流匹配 [5, 6]、 向量量化 [34, 3, 44] 或字节对编码 [47]。 最近,其中一些方法被扩展到数十亿参数,催生了 VLA [7, 13, 30, 5, 71, 10, 9, 70, 24, 47, 37]—— 一类构建在预训练视觉语言模型骨干之上的大模型。 凭借拟合不断增长的机器人数据集 [13, 29, 62, 15, 41, 27] 的容量,以及来自视觉语言预训练的互联网知识,VLA 在可泛化的机器人操作上取得了令人印象深刻的结果。 在真实机器人上,动作分块策略通常与一个更底层、更高频的控制环(例如 PID 控制器)配合使用, 由它把策略输出(例如关节位置)转换成硬件相关的控制信号(例如关节力矩)。 这种情况下,动作分块策略可视为一种串级控制 [14],学到的策略充当最外层控制环。 但并非总是如此:例如我们的仿真实验中,学到的策略直接输出力矩和力。 因此,串级控制理论与学习式动作分块策略的交叉研究,我们留待未来工作。
降低推理延迟。提升模型实时能力的一个自然思路是直接让它更快。 例如,一致性策略 [49] 对扩散策略做蒸馏,省掉昂贵的迭代去噪。 流式扩散策略 [23] 提出另一种训练方法,使每个控制步只需极少的去噪步。 Kim et al. [31] 为 OpenVLA [30] 加入并行解码,省掉昂贵的自回归解码。 更广泛地说,无论是扩散模型 [52, 38, 56, 17] 还是一般的大型 Transformer [32, 25, 35],推理速度优化都有丰富的文献。 遗憾的是,这些方向都无法把推理开销降到一次前向传播以下。只要这次前向传播比控制器的采样周期长,实时执行就仍需要其他方法。
修补与引导。利用预训练扩散和流模型做图像修补的文献很多 [48, 55, 40, 42]。 我们把其中一种方法 [48] 纳入新的实时执行框架,并做了我们认为在本场景中必要的修改(即软掩码和引导权重截断)。 在序贯决策领域,Diffuser [26] 开创了用基于扩散的修补在长时规划中遵循状态与动作约束,不过它的修补方法不基于引导 (其修补方法在本场景下的对比见附录 A.4)。 Diffuser 和其他工作 [64, 1] 也用价值函数引导扩散模型来求解强化学习(RL)问题。 我们工作的不同之处在于,这是首次把修补或引导用于实时控制。
实时执行。远在 VLA 出现之前,人们就研究了实时控制。与动作分块类似,模型预测控制(MPC;[51])在滚动时域上生成规划; 与我们的方法一样,它把执行和计算并行起来,并用上一个规划为下一次规划做热启动。 近期一些把学习方法与 MPC 结合的工作在特定领域展示了实时控制能力 [53, 21], 但它们依赖显式的、人工设计的动力学模型和代价函数。这些方法不适用于我们的场景:我们考虑无模型的模仿学习策略,并在非结构化的开放世界操作任务上测试。 另外,在强化学习中,已有多种工作研究了带时延的决策方法 [57, 16, 54, 63, 66, 67]。 但这些方法不一定适用于模仿学习,而且都没有利用动作分块。 最近出现了分层 VLA 设计 [58, 4],把模型分成 System 2(高层规划)和 System 1(底层动作生成)两部分。 System 2 承担 VLA 的大部分容量,以低频运行;System 1 轻量且快速。 这一思路与我们的方法正交,并有其自身的取舍(例如限制了 System 1 的规模,并需要专门的训练方法)。
双向解码。与我们最相关的已有工作是双向解码(BID;[39]), 它通过拒绝采样,让预训练的动作分块策略实现完全闭环控制。 虽然 Liu et al. [39] 没有考虑推理延迟,但 BID 算法可以实现与我们基于引导的修补相同的效果。 我们在仿真基准中与 BID 进行了比较,发现它不如 RTC,且计算量明显更大。
6 讨论与未来工作
实时分块是一种用于异步执行动作分块策略的推理期算法,在仿真和真实世界实验中都展现了速度与表现上的优势,包括在明显推理延迟下。 不过这项工作也有局限:与直接从基础策略采样的方法相比,它增加了可观的计算开销,并且只适用于基于扩散和流的策略。 此外,虽然我们的真实世界实验覆盖了多种有挑战性的操作任务,但还有更动态的场景能从实时执行中获益更多。 一个例子是腿式运动——它在我们的仿真基准中有所体现,但不在真实世界结果中。
致谢
感谢 Charles Xu 和 Kay Ke 设计了插网线任务。感谢 Brian Ichter 建议使用累计进度图,并在后期对图表提出反馈。 感谢 Dibya Ghosh 建议用吞吐量指标综合衡量速度与表现。 感谢 Ury Zhilinsky、Karan Dhabalia、Haohuan Wang 和 Dibya Ghosh 在训练基础设施上的帮助; 感谢 Noah Brown、Szymon Jakubczak、Adnan Esmail、Tim Jones、Mohith Mothukuri、James Darpinian 和 James Tanner 在机器人基础设施上的帮助; 感谢 Adrian Li-Bell 在评估基础设施上的帮助;感谢 Anna Walling、Chelsea Finn 和 Karol Hausman 负责机器人、数据和评估运营; 感谢 Michael Equi、Quan Vuong 和 Jost Tobias Springenberg 训练了真实世界实验中使用的部分 π₀.₅ 策略。 我们还感谢 Claudio Guglieri 和 Alex Krasikov 为博客文章制作可视化,感谢 Jessica Dai 对论文稿件的文字编辑。 最后,感谢 Physical Intelligence 的全体机器人操作员,他们为数据采集和策略评估做出了巨大贡献。
附录
原文正文后附有 NeurIPS 投稿自查清单(Paper Checklist),属于投稿格式要求而非论文内容,此处略去。
A.1 更广泛的影响
我们工作的目标是提升控制任务中学习型策略的速度和表现,实验主要涉及家用机器人。 这项技术有很大潜力改善人们的生活,例如把危险、困难的工作自动化,或帮助残障人士和老年人。 与任何技术一样,它也有造成危害的可能,例如用于军事,或替代体力劳动。
A.2 引导权重截断(\(\beta\))的必要性
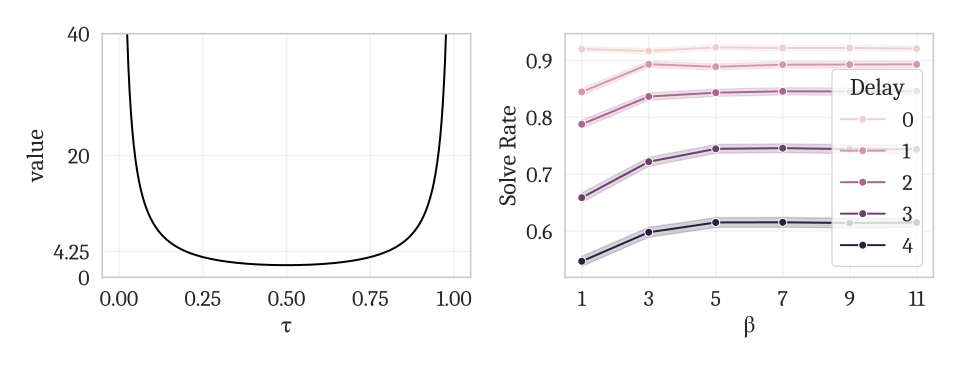
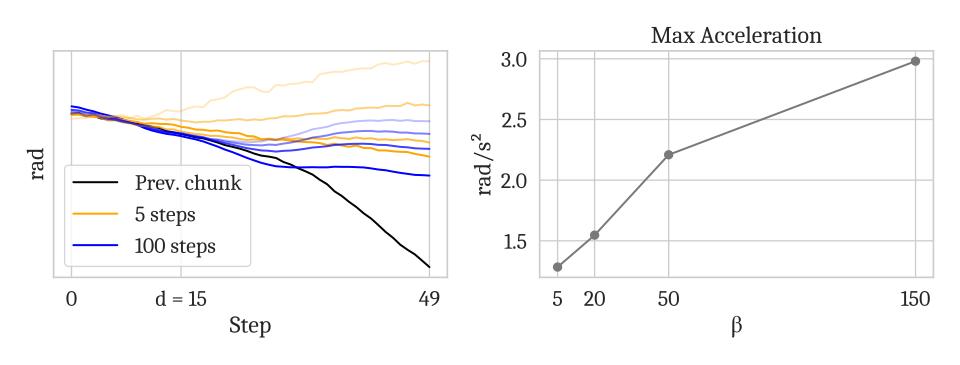
在 3.1 节中,我们介绍了如何把 Pokle et al. [48] 和 Song et al. [55] 的修补算法适配到本场景。 我们做的一个修改是加入截断值 \(\beta\),它限制施加在引导项上的权重(式 2),并且是让 \(\tau = 0\) 处权重有限所必需的。2 图像修补通常使用很多去噪步(例如 [48] 中 \(n = 100\)),而控制问题往往只用很少的步数(例如我们实验中 \(n = 5\))。 这种情况下,我们发现过高的引导权重会导致动作块发散,如图 7 左下所示。 根据仿真消融(图 7 右上),我们把 \(\beta\) 设为保守值 5。
2 避免 \(\tau = 0\) 处权重无穷大的另一种做法是从 \(\tau > 0\) 开始去噪,[48] 采用了这种做法,我们没有尝试。
A.3 延迟测量
| 方法 | 延迟 |
|---|---|
| RTC(本文) | 97ms |
| BID,\(N=16\)(无前向模型) | 115ms |
| BID,\(N=16\)(共享骨干) | 169ms |
| BID,\(N=16\)(完整) | 223ms |
| 原版 π₀.₅ | 76ms |
表 1。应用于 π₀.₅ [24] 的各种推理期方法的延迟测量。 数字只包含 GPU 上的神经网络推理,为 5 次预热调用后 10 次推理调用的平均值。 推理在 NVIDIA RTX 4090 GPU 上运行,使用 bfloat16 精度和 \(n = 5\) 个去噪步。 BID [39] 变慢是因为要采样动作批次,而 RTC 变慢是因为要对每个去噪步做反向传播。 BID(无前向对比)指去掉前向对比损失的 BID 版本,因此不需要第二个模型。 BID(共享骨干)指专门针对 π₀ 架构优化的 BID 版本:强模型和弱模型共享 VLM 骨干(30 亿参数),只需两份动作专家(3 亿参数)。 完整 BID 需要整个模型的两份副本。
| 组成部分 | 耗时(移动) | 耗时(非移动) |
|---|---|---|
| 模型 | 96.89 ± 0.16ms | 97.43 ± 0.28ms |
| 网络 | 21.20 ± 3.12ms | 6.89 ± 2.39ms |
| 图像缩放 | 11.22 ± 5.00ms | 1.44 ± 0.27ms |
| 其他 | 9.67 ± 3.20ms | 3.00 ± 0.68ms |
| 合计 | 138.98 ± 6.71ms | 108.76 ± 2.34ms |
表 2。RTC 总推理延迟按组成部分的拆分。 图像缩放在机器人计算机的 CPU 上进行。移动操作场景下,这台计算机是 Intel NUC 便携电脑,处理器为第 12 代 Intel i7-1260P; 非移动场景下,是一台 AMD Ryzen 9 7950X 处理器的台式工作站。 两种情况下,模型都运行在另一台配备 NVIDIA RTX 4090 GPU 的工作站上; 机器人计算机和推理工作站都通过有线以太网接入同一局域网,通信使用 WebSocket 协议。 模型推理使用 bfloat16 精度和 \(n = 5\) 个去噪步。测量取自一次真实回合中的 50 次推理调用,给出 ± 一个标准差。
| 组成部分 | 耗时(无 RTC) | 耗时(有 RTC) |
|---|---|---|
| 图像编码器(SigLIP) | 18ms | 18ms |
| LLM 预填充(Gemma 2B) | 44ms | 44ms |
| 去噪步(×5) | 14ms | 35ms |
| 合计 | 76ms | 97ms |
表 3。原版 π₀.₅ 与 RTC 的模型推理延迟按组成部分的拆分。 测量取自每种方法的单次 profiling trace,运行在 RTX 4090 GPU 上。RTC 使每个去噪步的延迟增加到 2.5 倍。
A.4 更多仿真消融
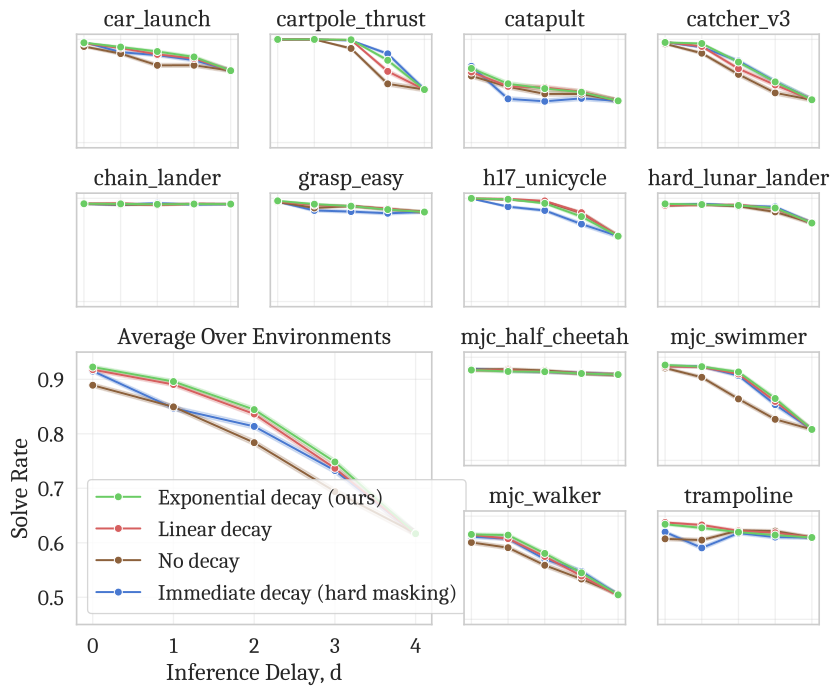
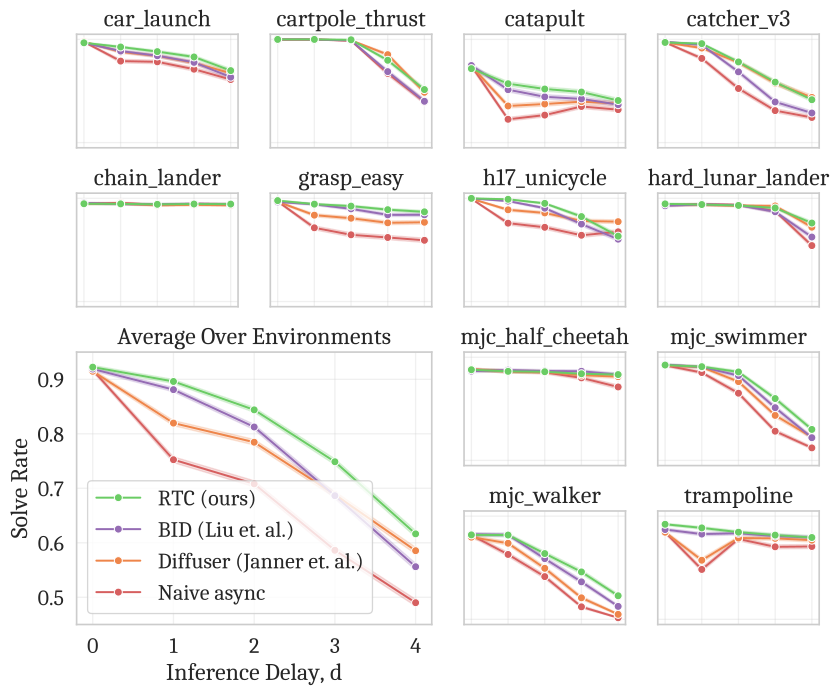
A.5 超参数
| 超参数 | 说明 | 仿真 | 真实世界 |
|---|---|---|---|
| \(n\) | 去噪步数 | 5 | 5 |
| \(H\) | 预测时域 | 8 | 50 |
| \(s_\text{min}\) | 最小执行时域 | – | 25 |
| \(\beta\) | 引导权重截断 | 5 | 5 |
| \(b\) | 延迟缓冲区大小 | – | 10 |
表 4。RTC(算法 1)使用的超参数。仿真中每个实验的 \(d\) 保持不变,因此不需要 \(s_\text{min}\) 和 \(b\)。 仿真实验的其他超参数见代码。
A.6 代码发布
仿真实验的代码见 https://github.com/Physical-Intelligence/real-time-chunking-kinetix。
A.7 计算资源
本文所有实验同一时间使用的 GPU 不超过 8 张 NVIDIA H100(一台 NVIDIA DGX 服务器)。H100 通过云服务商使用。
仿真实验。用 RPO [50] 训练 6 个种子 × 12 个环境的专家策略,在 4 张 H100 上约需 4 小时。 用这些策略生成数据,在 6 张 H100 上约需 20 分钟。为每个环境用流匹配训练模仿学习策略,在 2 张 H100 上约需 1.5 小时。 每个环境评估 2048 次试验,在 6 张 H100 上约需 5 分钟。
真实世界实验。我们使用从 π₀.₅ [24] 基础模型微调得到的策略。 每次微调在 8 张 H100 上约需 24 小时。所有真实世界推理都在与机器人同一栋楼的一台工作站上,用单张 NVIDIA RTX 4090 GPU 完成。
denoise_loop_kv_rtc 时需要实测的重点。
调度分析见 放球任务动态响应优化。
参考文献
按原文顺序保留英文条目,正文中的 [n] 可点击跳转。
- Anurag Ajay, Yilun Du, Abhi Gupta, Joshua Tenenbaum, Tommi Jaakkola, and Pulkit Agrawal. Is conditional generative modeling all you need for decision-making? arXiv preprint arXiv:2211.15657, 2022.
- Atilim Gunes Baydin, Barak A Pearlmutter, Alexey Andreyevich Radul, and Jeffrey Mark Siskind. Automatic differentiation in machine learning: a survey. Journal of machine learning research, 18 (153): 1–43, 2018.
- Suneel Belkhale and Dorsa Sadigh. Minivla: A better vla with a smaller footprint, 2024. URL https://github.com/Stanford-ILIAD/openvla-mini.
- Johan Bjorck, Fernando Castañeda, Nikita Cherniadev, Xingye Da, Runyu Ding, Linxi Fan, Yu Fang, Dieter Fox, Fengyuan Hu, Spencer Huang, et al. Gr00t n1: An open foundation model for generalist humanoid robots. arXiv preprint arXiv:2503.14734, 2025.
- Kevin Black, Noah Brown, Danny Driess, Adnan Esmail, Michael Equi, Chelsea Finn, Niccolo Fusai, Lachy Groom, Karol Hausman, Brian Ichter, et al. π₀: A vision-language-action flow model for general robot control. arXiv preprint arXiv:2410.24164, 2024.
- Max Braun, Noémie Jaquier, Leonel Rozo, and Tamim Asfour. Riemannian flow matching policy for robot motion learning. In 2024 IEEE/RSJ International Conference on Intelligent Robots and Systems (IROS), pages 5144–5151. IEEE, 2024.
- Anthony Brohan, Noah Brown, Justice Carbajal, Yevgen Chebotar, Xi Chen, Krzysztof Choromanski, Tianli Ding, Danny Driess, Avinava Dubey, Chelsea Finn, Pete Florence, Chuyuan Fu, Montse Gonzalez Arenas, Keerthana Gopalakrishnan, Kehang Han, Karol Hausman, Alex Herzog, Jasmine Hsu, Brian Ichter, Alex Irpan, Nikhil Joshi, Ryan Julian, Dmitry Kalashnikov, Yuheng Kuang, Isabel Leal, Lisa Lee, Tsang-Wei Edward Lee, Sergey Levine, Yao Lu, Henryk Michalewski, Igor Mordatch, Karl Pertsch, Kanishka Rao, Krista Reymann, Michael Ryoo, Grecia Salazar, Pannag Sanketi, Pierre Sermanet, Jaspiar Singh, Anikait Singh, Radu Soricut, Huong Tran, Vincent Vanhoucke, Quan Vuong, Ayzaan Wahid, Stefan Welker, Paul Wohlhart, Jialin Wu, Fei Xia, Ted Xiao, Peng Xu, Sichun Xu, Tianhe Yu, and Brianna Zitkovich. Rt-2: Vision-language-action models transfer web knowledge to robotic control. In arXiv preprint arXiv:2307.15818, 2023a.
- Anthony Brohan, Noah Brown, Justice Carbajal, Yevgen Chebotar, Xi Chen, Krzysztof Choromanski, Tianli Ding, Danny Driess, Avinava Dubey, Chelsea Finn, et al. Rt-2: Vision-language-action models transfer web knowledge to robotic control. arXiv preprint arXiv:2307.15818, 2023b.
- Chi-Lam Cheang, Guangzeng Chen, Ya Jing, Tao Kong, Hang Li, Yifeng Li, Yuxiao Liu, Hongtao Wu, Jiafeng Xu, Yichu Yang, Hanbo Zhang, and Minzhao Zhu. Gr-2: A generative video-language-action model with web-scale knowledge for robot manipulation. arXiv preprint arXiv:2410.06158, 2024.
- An-Chieh Cheng, Yandong Ji, Zhaojing Yang, Xueyan Zou, Jan Kautz, Erdem Biyik, Hongxu Yin, Sifei Liu, and Xiaolong Wang. NaVILA: Legged Robot Vision-Language-Action Model for Navigation. arXiv preprint arXiv:2412.04453, 2024.
- Cheng Chi, Zhenjia Xu, Siyuan Feng, Eric Cousineau, Yilun Du, Benjamin Burchfiel, Russ Tedrake, and Shuran Song. Diffusion policy: Visuomotor policy learning via action diffusion. The International Journal of Robotics Research, page 02783649241273668, 2023.
- Cheng Chi, Zhenjia Xu, Chuer Pan, Eric Cousineau, Benjamin Burchfiel, Siyuan Feng, Russ Tedrake, and Shuran Song. Universal manipulation interface: In-the-wild robot teaching without in-the-wild robots. arXiv preprint arXiv:2402.10329, 2024.
- OX-Embodiment Collaboration, A Padalkar, A Pooley, A Jain, A Bewley, A Herzog, A Irpan, A Khazatsky, A Rai, A Singh, et al. Open X-Embodiment: Robotic learning datasets and RT-X models. arXiv preprint arXiv:2310.08864, 1 (2), 2023.
- Donald R. Coughanowr and Steven E. LeBlanc. Process Systems Analysis and Control, chapter 18. McGraw-Hill, New York, 3rd edition, 2009. ISBN 978-0073397894.
- Hao-Shu Fang, Hongjie Fang, Zhenyu Tang, Jirong Liu, Chenxi Wang, Junbo Wang, Haoyi Zhu, and Cewu Lu. Rh20t: A comprehensive robotic dataset for learning diverse skills in one-shot. In 2024 IEEE International Conference on Robotics and Automation (ICRA), pages 653–660. IEEE, 2024.
- Vlad Firoiu, Tina Ju, and Josh Tenenbaum. At human speed: Deep reinforcement learning with action delay. arXiv preprint arXiv:1810.07286, 2018.
- Kevin Frans, Danijar Hafner, Sergey Levine, and Pieter Abbeel. One step diffusion via shortcut models. arXiv preprint arXiv:2410.12557, 2024.
- Ruiqi Gao, Emiel Hoogeboom, Jonathan Heek, Valentin De Bortoli, Kevin P. Murphy, and Tim Salimans. Diffusion meets flow matching: Two sides of the same coin. 2024. URL https://diffusionflow.github.io/.
- Abraham George and Amir Barati Farimani. One act play: Single demonstration behavior cloning with action chunking transformers. arXiv preprint arXiv:2309.10175, 2023.
- Anthony Ha. Google's gemini has beaten pokémon blue (with a little help). https://techcrunch.com/2025/05/03/googles-gemini-has-beaten-pokemon-blue-with-a-little-help/, May 2025. Accessed May 8, 2025.
- Nicklas Hansen, Xiaolong Wang, and Hao Su. Temporal difference learning for model predictive control, 2022. URL https://arxiv.org/abs/2203.04955.
- Jonathan Ho, Ajay Jain, and Pieter Abbeel. Denoising diffusion probabilistic models. Advances in neural information processing systems, 33: 6840–6851, 2020.
- Sigmund H Heg, Yilun Du, and Olav Egeland. Streaming diffusion policy: Fast policy synthesis with variable noise diffusion models. arXiv preprint arXiv:2406.04806, 2024.
- Physical Intelligence, Kevin Black, Noah Brown, James Darpinian, Karan Dhabalia, Danny Driess, Adnan Esmail, Michael Equi, Chelsea Finn, Niccolo Fusai, et al. π₀.₅: A vision-language-action model with open-world generalization. arXiv preprint arXiv:2504.16054, 2025.
- Benoit Jacob, Skirmantas Kligys, Bo Chen, Menglong Zhu, Matthew Tang, Andrew Howard, Hartwig Adam, and Dmitry Kalenichenko. Quantization and training of neural networks for efficient integer-arithmetic-only inference. In Proceedings of the IEEE conference on computer vision and pattern recognition, pages 2704–2713, 2018.
- Michael Janner, Yilun Du, Joshua B Tenenbaum, and Sergey Levine. Planning with diffusion for flexible behavior synthesis. arXiv preprint arXiv:2205.09991, 2022.
- Zhenyu Jiang, Yuqi Xie, Kevin Lin, Zhenjia Xu, Weikang Wan, Ajay Mandlekar, Linxi Fan, and Yuke Zhu. Dexmimicgen: Automated data generation for bimanual dexterous manipulation via imitation learning. arXiv preprint arXiv:2410.24185, 2024.
- Jared Kaplan, Sam McCandlish, Tom Henighan, Tom B Brown, Benjamin Chess, Rewon Child, Scott Gray, Alec Radford, Jeffrey Wu, and Dario Amodei. Scaling laws for neural language models. arXiv preprint arXiv:2001.08361, 2020.
- Alexander Khazatsky, Karl Pertsch, Suraj Nair, Ashwin Balakrishna, Sudeep Dasari, Siddharth Karamcheti, Soroush Nasiriany, Mohan Kumar Srirama, Lawrence Yunliang Chen, Kirsty Ellis, Peter David Fagan, Joey Hejna, Masha Itkina, Marion Lepert, Yecheng Jason Ma, Patrick Tree Miller, Jimmy Wu, Suneel Belkhale, Shivin Dass, Huy Ha, Arhan Jain, Abraham Lee, Youngwoon Lee, Marius Memmel, Sungjae Park, Ilija Radosavovic, Kaiyuan Wang, Albert Zhan, Kevin Black, Cheng Chi, Kyle Beltran Hatch, Shan Lin, Jingpei Lu, Jean Mercat, Abdul Rehman, Pannag R Sanketi, Archit Sharma, Cody Simpson, Quan Vuong, Homer Rich Walke, Blake Wulfe, Ted Xiao, Jonathan Heewon Yang, Arefeh Yavary, Tony Z. Zhao, Christopher Agia, Rohan Baijal, Mateo Guaman Castro, Daphne Chen, Qiuyu Chen, Trinity Chung, Jaimyn Drake, Ethan Paul Foster, Jensen Gao, David Antonio Herrera, Minho Heo, Kyle Hsu, Jiaheng Hu, Donovon Jackson, Charlotte Le, Yunshuang Li, Kevin Lin, Roy Lin, Zehan Ma, Abhiram Maddukuri, Suvir Mirchandani, Daniel Morton, Tony Nguyen, Abigail O'Neill, Rosario Scalise, Derick Seale, Victor Son, Stephen Tian, Emi Tran, Andrew E. Wang, Yilin Wu, Annie Xie, Jingyun Yang, Patrick Yin, Yunchu Zhang, Osbert Bastani, Glen Berseth, Jeannette Bohg, Ken Goldberg, Abhinav Gupta, Abhishek Gupta, Dinesh Jayaraman, Joseph J Lim, Jitendra Malik, Roberto Martín-Martín, Subramanian Ramamoorthy, Dorsa Sadigh, Shuran Song, Jiajun Wu, Michael C. Yip, Yuke Zhu, Thomas Kollar, Sergey Levine, and Chelsea Finn. Droid: A large-scale in-the-wild robot manipulation dataset. In Proceedings of Robotics: Science and Systems, 2024.
- Moo Jin Kim, Karl Pertsch, Siddharth Karamcheti, Ted Xiao, Ashwin Balakrishna, Suraj Nair, Rafael Rafailov, Ethan Foster, Grace Lam, Pannag Sanketi, et al. Openvla: An open-source vision-language-action model. arXiv preprint arXiv:2406.09246, 2024.
- Moo Jin Kim, Chelsea Finn, and Percy Liang. Fine-tuning vision-language-action models: Optimizing speed and success. arXiv preprint arXiv:2502.19645, 2025.
- Woosuk Kwon, Zhuohan Li, Siyuan Zhuang, Ying Sheng, Lianmin Zheng, Cody Hao Yu, Joseph Gonzalez, Hao Zhang, and Ion Stoica. Efficient memory management for large language model serving with pagedattention. In Proceedings of the 29th Symposium on Operating Systems Principles, pages 611–626, 2023.
- Lucy Lai, Ann Zixiang Huang, and Samuel J Gershman. Action chunking as policy compression. 2022.
- Seungjae Lee, Yibin Wang, Haritheja Etukuru, H Jin Kim, Nur Muhammad Mahi Shafiullah, and Lerrel Pinto. Behavior generation with latent actions. arXiv preprint arXiv:2403.03181, 2024.
- Ji Lin, Jiaming Tang, Haotian Tang, Shang Yang, Wei-Ming Chen, Wei-Chen Wang, Guangxuan Xiao, Xingyu Dang, Chuang Gan, and Song Han. Awq: Activation-aware weight quantization for on-device llm compression and acceleration. Proceedings of Machine Learning and Systems, 6: 87–100, 2024.
- Yaron Lipman, Ricky TQ Chen, Heli Ben-Hamu, Maximilian Nickel, and Matt Le. Flow matching for generative modeling. arXiv preprint arXiv:2210.02747, 2022.
- Songming Liu, Lingxuan Wu, Bangguo Li, Hengkai Tan, Huayu Chen, Zhengyi Wang, Ke Xu, Hang Su, and Jun Zhu. Rdt-1b: a diffusion foundation model for bimanual manipulation. arXiv preprint arXiv:2410.07864, 2024a.
- Xingchao Liu, Chengyue Gong, and Qiang Liu. Flow straight and fast: Learning to generate and transfer data with rectified flow. arXiv preprint arXiv:2209.03003, 2022.
- Yuejiang Liu, Jubayer Ibn Hamid, Annie Xie, Yoonho Lee, Maximilian Du, and Chelsea Finn. Bidirectional decoding: Improving action chunking via closed-loop resampling. arXiv preprint arXiv:2408.17355, 2024b.
- Andreas Lugmayr, Martin Danelljan, Andres Romero, Fisher Yu, Radu Timofte, and Luc Van Gool. Repaint: Inpainting using denoising diffusion probabilistic models. In Proceedings of the IEEE/CVF conference on computer vision and pattern recognition, pages 11461–11471, 2022.
- Ajay Mandlekar, Yuke Zhu, Animesh Garg, Jonathan Booher, Max Spero, Albert Tung, Julian Gao, John Emmons, Anchit Gupta, Emre Orbay, et al. Roboturk: A crowdsourcing platform for robotic skill learning through imitation. In Conference on Robot Learning, pages 879–893. PMLR, 2018.
- Morteza Mardani, Jiaming Song, Jan Kautz, and Arash Vahdat. A variational perspective on solving inverse problems with diffusion models. arXiv preprint arXiv:2305.04391, 2023.
- Michael Matthews, Michael Beukman, Chris Lu, and Jakob Foerster. Kinetix: Investigating the training of general agents through open-ended physics-based control tasks. arXiv preprint arXiv:2410.23208, 2024.
- Atharva Mete, Haotian Xue, Albert Wilcox, Yongxin Chen, and Animesh Garg. Quest: Self-supervised skill abstractions for learning continuous control, 2024. URL https://arxiv.org/abs/2407.15840.
- OpenAI. Introducing openai codex, August 2021. URL https://openai.com/index/introducing-codex/. Accessed on May 27, 2025.
- Tim Pearce, Tabish Rashid, Anssi Kanervisto, Dave Bignell, Mingfei Sun, Raluca Georgescu, Sergio Valcarcel Macua, Shan Zheng Tan, Ida Momennejad, Katja Hofmann, et al. Imitating human behaviour with diffusion models. arXiv preprint arXiv:2301.10677, 2023.
- Karl Pertsch, Kyle Stachowicz, Brian Ichter, Danny Driess, Suraj Nair, Quan Vuong, Oier Mees, Chelsea Finn, and Sergey Levine. Fast: Efficient action tokenization for vision-language-action models. arXiv preprint arXiv:2501.09747, 2025.
- Ashwini Pokle, Matthew J Muckley, Ricky TQ Chen, and Brian Karrer. Training-free linear image inverses via flows. arXiv preprint arXiv:2310.04432, 2023.
- Aaditya Prasad, Kevin Lin, Jimmy Wu, Linqi Zhou, and Jeannette Bohg. Consistency policy: Accelerated visuomotor policies via consistency distillation. arXiv preprint arXiv:2405.07503, 2024.
- Md Masudur Rahman and Yexiang Xue. Robust policy optimization in deep reinforcement learning. arXiv preprint arXiv:2212.07536, 2022.
- J.B. Rawlings, D.Q. Mayne, and M. Diehl. Model Predictive Control: Theory, Computation, and Design. Nob Hill Publishing, 2017. ISBN 9780975937730. URL https://books.google.ch/books?id=MrJctAEACAAJ.
- Tim Salimans and Jonathan Ho. Progressive distillation for fast sampling of diffusion models. arXiv preprint arXiv:2202.00512, 2022.
- Tim Salzmann, Elia Kaufmann, Jon Arrizabalaga, Marco Pavone, Davide Scaramuzza, and Markus Ryll. Real-time neural mpc: Deep learning model predictive control for quadrotors and agile robotic platforms. IEEE Robotics and Automation Letters, 8 (4): 2397–2404, 2023.
- Erik Schuitema, Lucian Busoniu, Robert Babuška, and Pieter Jonker. Control delay in reinforcement learning for real-time dynamic systems: A memoryless approach. In 2010 IEEE/RSJ international conference on intelligent robots and systems, pages 3226–3231. IEEE, 2010.
- Jiaming Song, Arash Vahdat, Morteza Mardani, and Jan Kautz. Pseudoinverse-guided diffusion models for inverse problems. In International Conference on Learning Representations, 2023a.
- Yang Song, Prafulla Dhariwal, Mark Chen, and Ilya Sutskever. Consistency models. 2023b.
- Jie Tan, Tingnan Zhang, Erwin Coumans, Atil Iscen, Yunfei Bai, Danijar Hafner, Steven Bohez, and Vincent Vanhoucke. Sim-to-real: Learning agile locomotion for quadruped robots. arXiv preprint arXiv:1804.10332, 2018.
- Gemini Robotics Team, Saminda Abeyruwan, Joshua Ainslie, Jean-Baptiste Alayrac, Montserrat Gonzalez Arenas, Travis Armstrong, Ashwin Balakrishna, Robert Baruch, Maria Bauza, Michiel Blokzijl, et al. Gemini robotics: Bringing ai into the physical world. arXiv preprint arXiv:2503.20020, 2025.
- Octo Model Team, Dibya Ghosh, Homer Walke, Karl Pertsch, Kevin Black, Oier Mees, Sudeep Dasari, Joey Hejna, Tobias Kreiman, Charles Xu, et al. Octo: An open-source generalist robot policy. arXiv preprint arXiv:2405.12213, 2024a.
- Waywe Research Team et al. Lingo-2: Driving with natural language, 2024b.
- Ilya O Tolstikhin, Neil Houlsby, Alexander Kolesnikov, Lucas Beyer, Xiaohua Zhai, Thomas Unterthiner, Jessica Yung, Andreas Steiner, Daniel Keysers, Jakob Uszkoreit, et al. Mlp-mixer: An all-mlp architecture for vision. Advances in neural information processing systems, 34: 24261–24272, 2021.
- Homer Rich Walke, Kevin Black, Tony Z Zhao, Quan Vuong, Chongyi Zheng, Philippe Hansen-Estruch, Andre Wang He, Vivek Myers, Moo Jin Kim, Max Du, et al. BridgeData v2: A dataset for robot learning at scale. In Conference on Robot Learning, pages 1723–1736. PMLR, 2023.
- Thomas J Walsh, Ali Nouri, Lihong Li, and Michael L Littman. Planning and learning in environments with delayed feedback. In Machine Learning: ECML 2007: 18th European Conference on Machine Learning, Warsaw, Poland, September 17-21, 2007. Proceedings 18, pages 442–453. Springer, 2007.
- Zhendong Wang, Jonathan J Hunt, and Mingyuan Zhou. Diffusion policies as an expressive policy class for offline reinforcement learning. arXiv preprint arXiv:2208.06193, 2022.
- Jason Wei, Zhiqing Sun, Spencer Papay, Scott McKinney, Jeffrey Han, Isa Fulford, Hyung Won Chung, Alex Tachard Passos, William Fedus, and Amelia Glaese. Browsecomp: A simple yet challenging benchmark for browsing agents. arXiv preprint arXiv:2504.12516, 2025.
- Ted Xiao, Eric Jang, Dmitry Kalashnikov, Sergey Levine, Julian Ibarz, Karol Hausman, and Alexander Herzog. Thinking while moving: Deep reinforcement learning with concurrent control. arXiv preprint arXiv:2004.06089, 2020.
- Bin Xu, Farzam Malmir, Dhruvang Rathod, and Zoran Filipi. Real-time reinforcement learning optimized energy management for a 48v mild hybrid electric vehicle. Technical report, SAE Technical Paper, 2019.
- Tony Z Zhao, Vikash Kumar, Sergey Levine, and Chelsea Finn. Learning fine-grained bimanual manipulation with low-cost hardware. arXiv preprint arXiv:2304.13705, 2023.
- Tony Z Zhao, Jonathan Tompson, Danny Driess, Pete Florence, Kamyar Ghasemipour, Chelsea Finn, and Ayzaan Wahid. Aloha unleashed: A simple recipe for robot dexterity. arXiv preprint arXiv:2410.13126, 2024.
- Haoyu Zhen, Xiaowen Qiu, Peihao Chen, Jincheng Yang, Xin Yan, Yilun Du, Yining Hong, and Chuang Gan. 3d-vla: 3d vision-language-action generative world model. arXiv preprint arXiv:2403.09631, 2024.
- Ruijie Zheng, Yongyuan Liang, Shuaiyi Huang, Jianfeng Gao, Hal Daumé III, Andrey Kolobov, Furong Huang, and Jianwei Yang. Tracevla: Visual trace prompting enhances spatial-temporal awareness for generalist robotic policies. arXiv preprint arXiv:2412.10345, 2024.