CHASE-VLA:面向视觉—语言—动作模型的块感知训练后量化
中文译文,原文 CHASE-VLA: Post-Training Quantization Framework for Vision-Language-Action Models with Chunk-Aware Scale Estimation (arXiv:2610.02666v1,2026-10-02)。图、表链回 arXiv HTML 与 PDF。 关键词:Vision-Language-Action · Post-training quantization。
1. 引言
VLA 把视觉—语言理解接到可执行的机器人控制上,成为具身智能的一类基础模型 [2] [4] [5] [6] [14] [15]。 早期系统常把动作离散成语言兼容的 token,由视觉—语言模型(VLM)的输出头直接预测,动作生成只是一层很轻的接口。 近期架构则保留 VLM 分支的感知和推理,另加一个专门的扩散动作专家来生成连续轨迹。AE 直接决定轨迹平滑、时间一致性和控制鲁棒性,因此成为现代 VLA 策略的中心部件。图 1 概括了这个结构:VLM 负责视觉—语言落地,独立的扩散 AE 反复细化连续动作块。
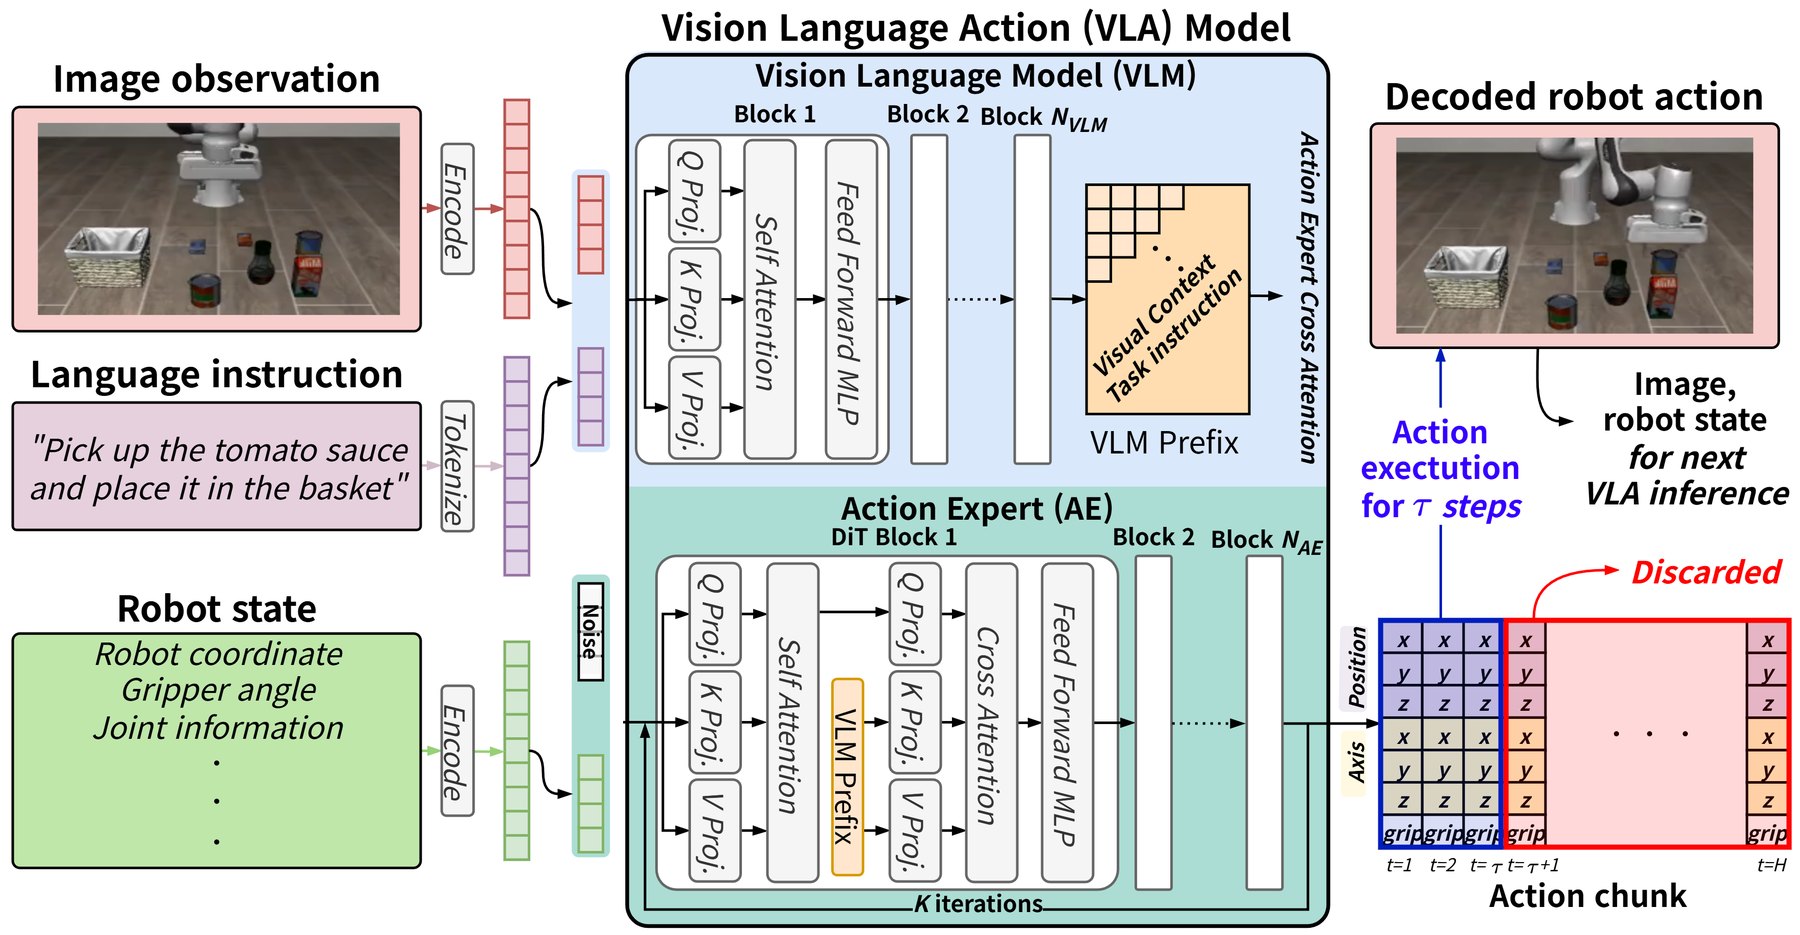
和动作 token 解码器不同,扩散 AE 通过迭代细化生成动作块,在多个去噪步上反复跑 Transformer 块。每次重规划都会再来一遍,因此权重读取和激活搬运会沿整条轨迹累积。AE 同时影响访存和控制保真度,是面向部署的量化首选对象。PTQ 不必重新采机器人数据、做 rollout 验证或迭代生成动作,适合已经训好的策略。但量化后的 AE 仍须在整段执行轨迹的反复去噪和重规划中保住连续控制精度。
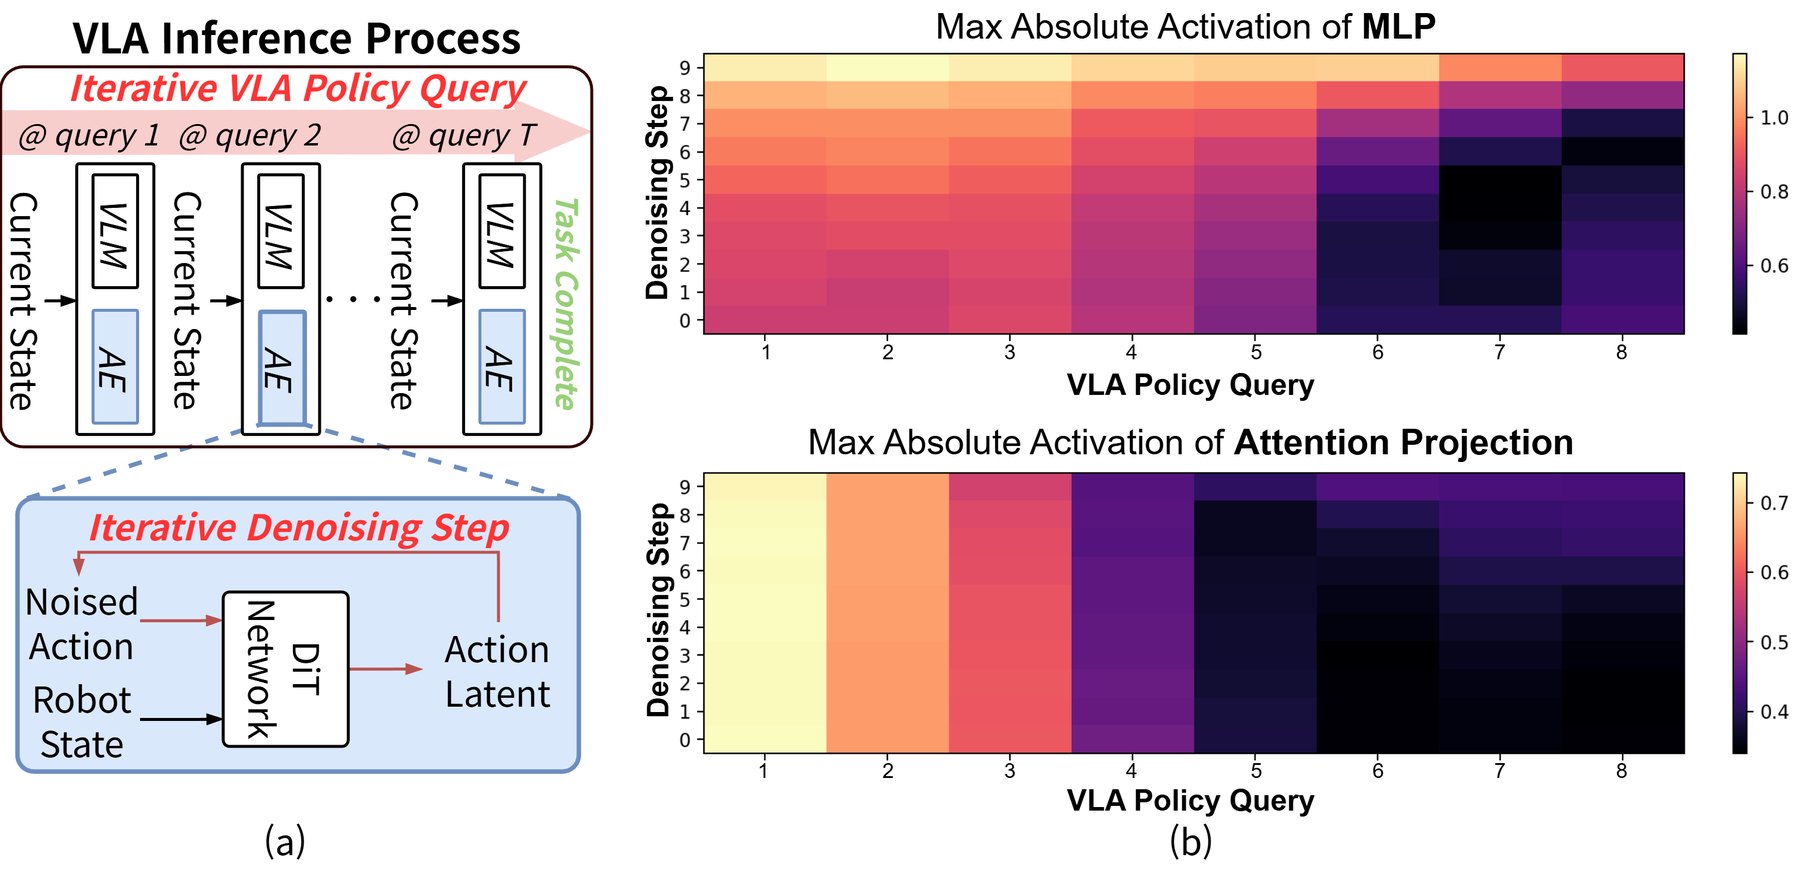
AE 的低比特 PTQ 在敏感性和执行形态上都不同于语言模型量化。已有 VLA PTQ 通常把敏感的注意力投影留在浮点,只量化 MLP 投影,反复执行的 AE 里仍有一大块代价没有量化。原因是静态校准 scale 和反复执行时的动态激活对不上。如图 2(a),AE 处在两层循环里:每个动作块要经多步去噪,整段 rollout 的每次重规划又要生成新块。去噪过程中激活随步数变化,而不是服从一次前向的固定分布。每个策略查询的观测、指令和机器人状态也不同,生成的运动以及所需的激活 scale 会从一块变到下一块。图 2(b) 显示同一线性层上,最大绝对值既随去噪步变,也随动作上下文变。单一校准 scale 要么裁掉大激活,要么让细控制损失分辨率。局部误差在反复去噪和重规划中会堆成轨迹级控制误差。要补上这个缺口,激活 scale 必须同时依赖去噪步和正在生成的运动。但当前块的动作上下文在 AE 产出这块之前因果上不可用,没法直接按当前块选 scale。
按块执行的 VLA 提供了一个因果上可用的动作上下文。现代策略每次查询预测一小段动作块,而不是只预测下一步。机器人只执行块的前缀,拿到新观测后再重规划。剩下的后缀不会被执行,但它仍是同一条轨迹上、策略自己预测的延续,因此能表示近期意图,而不需要额外 rollout 或任务标注。
CHASE-VLA 是面向扩散 VLA 动作专家的块感知 PTQ。它不用固定校准 scale,而是用动作条件因子去调制校准得到的激活 scale,这些因子在一组去噪步内共享。条件信号是上一块已经生成的动作,它压缩地概括了近期意图,使选 scale 同时反映动作上下文和去噪进度,且不改 AE 结构。自适应缩放支持 4 比特权重和激活(W4A4),减轻静态 PTQ 常见的 scale 失配。与以往把注意力投影留在浮点的 VLA PTQ 不同,CHASE-VLA 把 W4A4 从 MLP 扩到反复执行的 AE 里的注意力投影,从而进一步降低访存。
贡献如下:
- 指出去噪步和动作上下文上的激活 scale 失配,是扩散 VLA 动作专家低比特 PTQ 的核心障碍。
- CHASE-VLA 用上一动作块估计激活 scale,并在去噪步分组上使用。
- 在不改预训练策略和 AE 结构的前提下,把 W4A4 目标从 MLP 扩到 MLP 加注意力投影。
- 在 LIBERO 上对 π₀.₅、GR00T N1.6、CogACT 做了实验;在 π₀.₅ 和 GR00T N1.6 上量化了权重存储、单块访存和预测器开销。
2. 相关工作
2.1 视觉—语言—动作模型
近期 VLA 从离散动作预测转到扩散 AE 生成的连续轨迹。 Diffusion Policy 表明把机器人动作建成条件去噪过程,能生成平滑且多模态的轨迹。CogACT、π₀.₅、GR00T、RDT 沿这个方向,用扩散动作模块把高层视觉—语言推理和低层连续控制接在一起。按块预测让时间上相关的未来控制成为一条连贯轨迹,有利于接触丰富操作和长程任务。代价是 AE 要在多个去噪步上反复评估动作块,连续控制质量和低比特部署都绕不开它。
2.2 高效 VLA 推理与压缩
TinyVLA 把紧凑多模态 Transformer 和轻量扩散头结合;EfficientVLA 剪掉冗余语言层并复用中间表示;VLA-Cache 复用静态视觉 token 的 KV;MoLe-VLA 用 mixture-of-layers 跳过非必要计算。这些工作主要改结构或执行路径,数值精度讨论较少。在显存和带宽很紧时,量化是结构优化之外的必要手段,对必须保住动作块相关激活分布和去噪动态的扩散 AE 尤其如此。
2.3 LLM、VLM、DiT 与 VLA 的训练后量化
对 VLA 动作专家,差别不只是量化范围,还有迭代生成动作时用什么信息来选激活 scale。表 1 按 PTQ 类别整理了这一点,并标出 CHASE-VLA 补上的缺口。
| PTQ 类别 | scale 选择信号 | 量化范围 |
|---|---|---|
| LLM / VLM PTQ | 权重 / 激活统计 | Transformer 编码器 / 解码器 |
| 扩散 PTQ | 去噪步信号 | 扩散去噪块 |
| VLA PTQ | 静态模块校准 | 仅 AE 的 MLP |
| CHASE-VLA(本文) | 上一动作块 + 去噪步分组 | AE 的 MLP + 注意力投影 |
PTQ 不需要完整重训就能减小预训练 Transformer 的显存和推理代价。SmoothQuant、GPTQ、AWQ 通过压激活离群、补偿权重量化误差或重分配激活能量来做低比特部署。它们适合量化 VLA 里负责语义落地的 VLM 主干,但 scale 主要按生成 token 的 Transformer 来设计,并不显式建模扩散 AE 的迭代去噪和动作上下文变化。把这些假设直接搬到 VLA 动作生成上,量化误差会扰动连续控制指令。
扩散模型和扩散 Transformer(DiT)的激活统计也随去噪步变化。PTQ4DiT、Q-DiT 用步感知校准、更细的分组、动态量化或低秩残差补偿。它们和 VLA 相关,因为扩散 AE 同样沿去噪步细化输出。但这些方法面向图像或视频生成,scale 适应通常只绑在去噪过程上,不用预测出的动作块作为后续 AE 推理的因果上下文。去噪步感知的扩散量化和动作上下文感知的 VLA 量化之间仍有空隙。
更近的 VLA PTQ 开始直接处理数值敏感性。QuantVLA 分析 DiT 式 VLA 动作专家的 scale 漂移,用基于校准的稳定化;其 AE 量化是选择性的:注意力投影留在浮点,低比特目标集中在 MLP。DA-PTQ 处理另一侧的跨空间失配,对齐从视觉—语言主干传到动作解码器的条件表示,这和在反复执行的 AE 内部改激活 scale 不是一回事。这些方法提高了稳定性,但 AE 内部 MLP 与注意力投影同时做 W4A4 仍是开放问题。CHASE-VLA 用上一动作块和去噪步分组作为条件,直接对准迭代生成动作块时、随动作上下文和去噪步变化的 scale 失配。
3. 方法
3.1 预备知识与静态 PTQ
现代 VLA 通常把视觉—语言分支和扩散 AE 配在一起。记 \(t\) 为策略被查询的控制时刻,\(\tau \le H\) 为下次查询前执行的动作数。给定观测图像 \(I_t\) 和语言指令 \(L\),视觉—语言分支产生条件表示 \(F_t = \mathrm{VLM}(I_t, L)\)。它与本体感觉状态 \(r_t\) 一起条件化 AE。AE 迭代细化动作隐变量,并解码成动作块 \(A_t = [a_{t,0}, \ldots, a_{t,H-1}]\),其中 \(a_{t,h} \in \mathbb{R}^{d_a}\) 是块内第 \(h\) 个动作,\(d_a\) 是动作维,\(H\) 是动作视野。在去噪步 \(k \in \{0, \ldots, K-1\}\) 上,记 \(x_k\) 为该步的动作隐变量,更新为
最终去噪隐变量由动作解码器映射成可执行块:
CHASE-VLA 对准的就是这条被反复走的动作生成路径。\(f_\theta\) 里每个目标线性层都会跨去噪步和重规划块被调用,rollout 期间访存被反复放大;这条路径上的数值误差直接扰动连续动作,而不只是语义 token 概率。
对目标线性层 \(l\),记 \(u_{t,l,k}\) 为生成块 \(A_t\)、去噪步 \(k\) 时的输入激活。均匀 PTQ 把它量化为
\(q(u;s)\) 是整数量化,\(\hat{u}(s)\) 是反量化值,\(s\) 是激活 scale。对称有符号 \(a_{\mathrm{bits}}\) 比特激活下 \(q_{\max} = 2^{a_{\mathrm{bits}}-1}-1\),\(q_{\min} = -q_{\max}\),逐元素作用。\(s\) 决定对称裁剪范围。静态 PTQ 从校准集得到每层 scale 后,推理全程固定。式 (3) 里固定 \(s\) 把裁剪阈值设成 \(q_{\max}\cdot s\):实际范围更大就被裁,小很多则量化步长过粗、分辨率下降。但这个范围随去噪步和策略查询变化,因为每次查询生成的动作块不同。固定 scale 跟不上按查询、按步变化的范围。
3.2 块感知的 scale 估计
选激活 scale 应同时考虑去噪步和正在生成的具体动作。固定校准 scale 两者都忽略;只按去噪步的规则仍会给同一去噪步上的不同动作块同一套 scale。如图 3,CHASE-VLA 保留式 (3) 的量化算子,用上一块已经生成的动作,为下一块预计算分组激活 scale。它不独立预测绝对 scale,而是预测相对校准基 scale 的乘性调整,条件是已生成的动作上下文和去噪步分组。
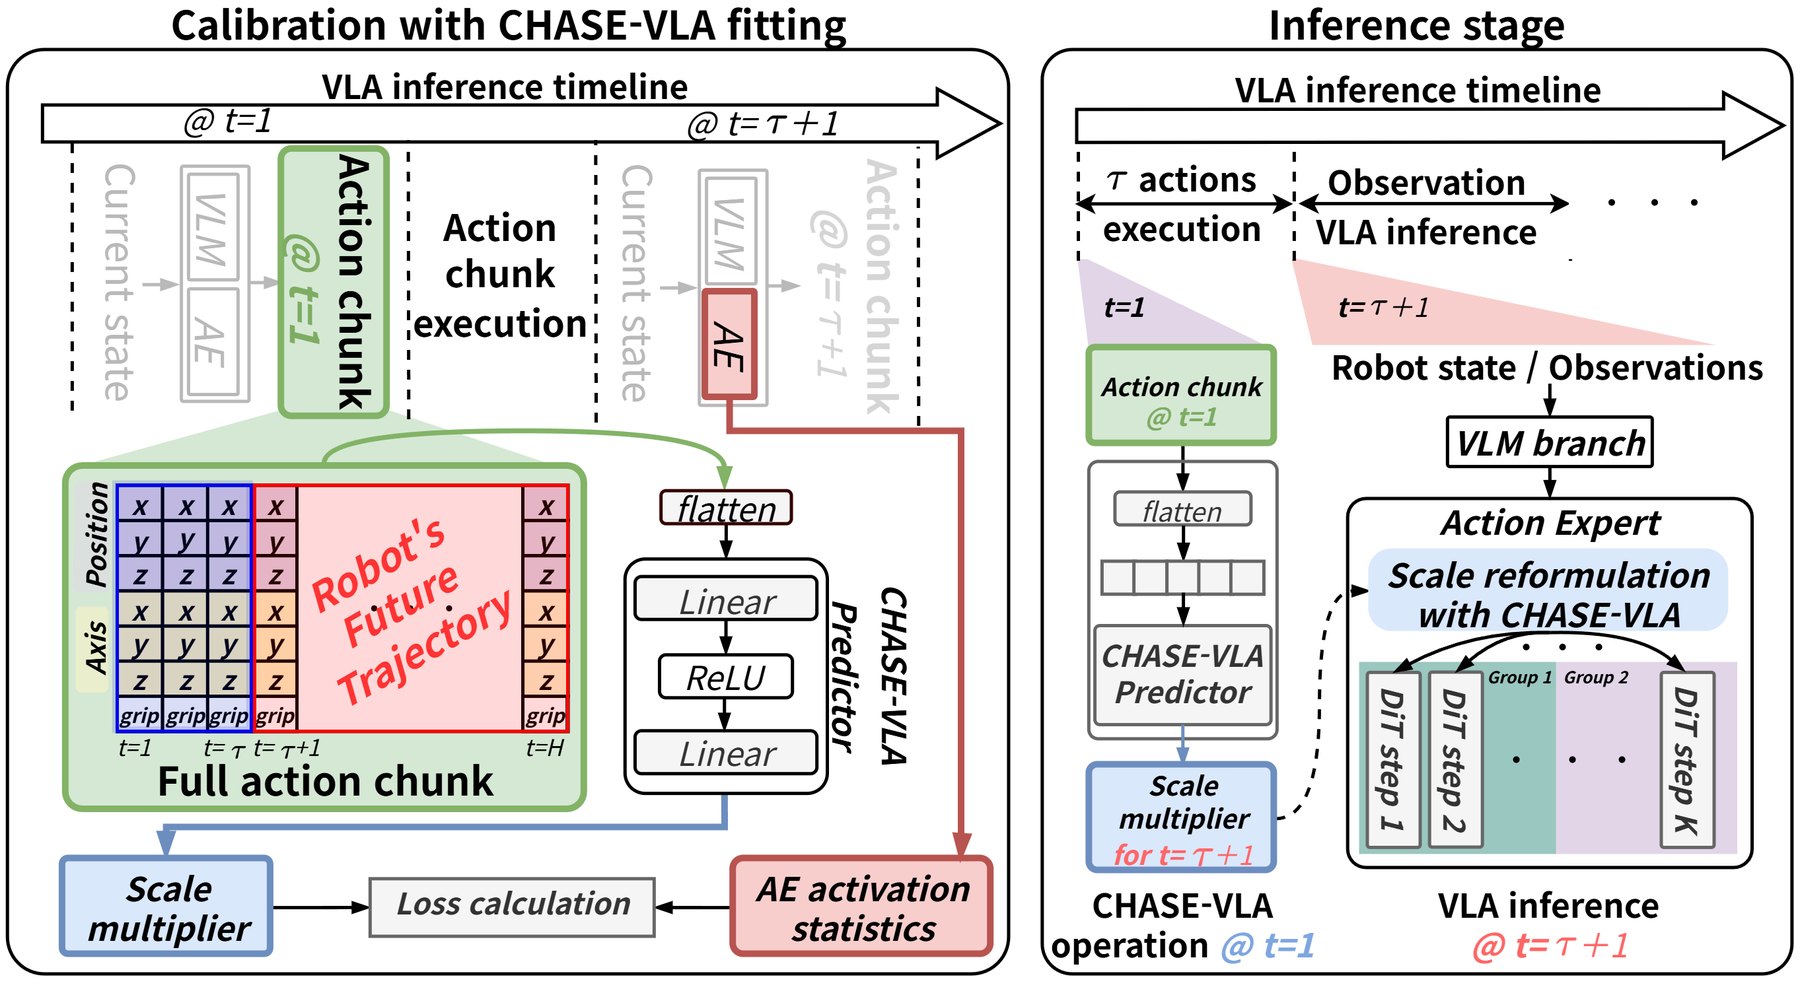
动作上下文来自策略先前预测的动作块。时刻 \(t\) 的查询之前,\(t-\tau\) 的查询生成了完整块 \(A_{t-\tau}\),机器人只执行了开头 \(\tau\) 个动作就重规划。未执行的后缀仍是已执行前缀的预测延续,编码了近期运动意图。因此当前块 \(A_t\) 的激活 scale 条件于整个上一块,包括前缀和后缀。这给出运动幅度和时间结构,而不需要未来动作的真值或 rollout 标注。
scale 调整也条件于去噪步。每个调整是基 scale 上的乘性因子。CHASE-VLA 不给每一步单独一个因子,而是把 \(K\) 个去噪步映射到 \(M\) 组,\(m \in \{1,\ldots,M\}\),每组预测一个因子。分组让预测器输出保持紧凑,同时仍能区分早期粗细化和后期精细化的不同激活范围。
先确定基 scale,再按动作条件的组参数调整。\(\tilde{u}_{l,m}\) 是层 \(l\)、去噪步组 \(m\) 上记录的校准激活。组特异的初始 scale 为
\(\mathrm{absmax}(\cdot)\) 取校准激活集合上的最大绝对值,\(\epsilon_s\) 是很小的 scale 下界。一段 episode 的第一块没有上一块可用,就用这些初始 scale;它们也锚定后续查询的相对调整。时刻 \(t\) 的查询把上一块展平为动作上下文:
\(z_t\) 在 AE 生成当前块 \(A_t\) 之前就算好,因此条件过程是因果的。如图 3,这形成一条循环的 scale 更新路径:\(t-\tau\) 生成的完整块(含未执行后缀)在时刻 \(t\) 被复用。
对每个目标线性层 \(l\),\(f_{\phi_l}\) 是图 3 中的轻量预测器。它把归一化后的动作上下文映射成每个去噪步组的一个对数 scale 调整和一个不确定性估计:
\(\hat{y}_{t,l,m}\) 是组 \(m\) 的对数 scale 调整,\(\log\hat{\sigma}_{t,l,m}^{2}\) 是对数方差,\(\mathrm{norm}(\cdot)\) 用校准集的均值和标准差做标准化。组 \(m\) 上,预测输出被转成带不确定性的 scale 乘子:
其中 \(\hat{\sigma}_{t,l,m} = \exp(0.5 \log \hat{\sigma}_{t,l,m}^{2})\),\(\alpha\) 是固定裕度。预测不确定时,不确定性项会缓和针对该上下文的调整,避免在偏离校准分布的动作上把 scale 缩得过狠。自适应因子在去噪步组 \(m\) 内共享,对应图 3 的 scale 乘子,用来调制组初始 scale,得到最终组 scale:
去噪时,AE 的每一步使用所属组预先算好的 scale。式 (8) 因此用两个来源定义当前查询的激活 scale:上一块 \(A_{t-\tau}\),以及当前这次线性调用所在的去噪步组。
拟合预测器时,每条收集到的校准查询是一个监督对:上一块是输入,生成对应“当前块”时记录的激活统计是目标。第 \(i\) 条查询在时刻 \(t_i\),输入是存下的上下文 \(\mathrm{vec}(A_{t_i-\tau})\),\(\hat{u}_{t_i,l,m}\) 是 AE 生成当前块 \(A_{t_i}\) 时观察到的激活。这些统计只用于离线构造校准目标,推理时不用。与式 (4) 那个与查询无关的初始 scale 不同,当前块 scale 对每条收集到的查询和每个去噪步组分别计算:
用小常数 \(\epsilon\),组目标是当前块组 scale 与初始组 scale 的以 10 为底的对数比:
这个目标训练 CHASE-VLA:用第 \(i\) 条查询的上一块,预测当前块在 \(t_i\) 需要校准组范围中的多少。学到的调整是去调制已经校准的组 scale,在基范围过宽时找回量化分辨率,而不是从零回归一个绝对激活 scale。预测器在收集到的校准查询上拟合,目标是对数 scale 上的 pinball 损失、对数方差头的高斯负对数似然,以及较小的参数正则。损失的详细分析在补充材料。整个校准中预训练 VLA 策略保持冻结,因此这是训练后量化,不是策略微调。
3.3 量化目标与推理路径
CHASE-VLA 把 W4A4 集中在扩散 AE 内部被反复调用的线性投影上:前馈 MLP 投影,以及 AE 注意力模块里的线性投影。这些层在反复去噪路径上,scale 失配会直接伤害低比特动作生成。覆盖比以往 VLA PTQ 更激进——后者通常只量化 AE 的 MLP,注意力投影留在浮点。注意力投影每个去噪步也会被调用,留在浮点会在 AE 里留下可观的反复数据搬运。第 3.2 节的自适应 scale 让注意力投影可以留在 W4A4 目标里。
如图 3,推理时 CHASE-VLA 是 AE 的 scale 更新模块。第一次策略查询还没有上一块,目标线性层使用式 (4) 的初始 scale。AE 一旦生成 \(A_t\),CHASE-VLA 立刻把 \(\mathrm{vec}(A_t)\) 映射成按组的缩放因子,并更新下一次查询(时刻 \(t+\tau\))所有目标层、所有去噪步组的激活 scale。因此在 AE 开始生成 \(A_{t+\tau}\) 之前,式 (8) 的 \(s_{t+\tau,l,m}^{\mathrm{CHASE\text{-}VLA}}\) 已经固定。下一次去噪中,每个目标线性层只读取自己那一组的预计算 scale。\(A_{t+\tau}\) 产出后,同样用 \(\mathrm{vec}(A_{t+\tau})\) 更新再下一次查询。预训练策略权重和去噪日程不变,变的只是各目标线性层在两次策略查询之间使用的激活 scale。
4. 实验
4.1 实验设置
在三个 VLA 上评估:π₀.₅、GR00T N1.6、CogACT,覆盖不同 AE 结构和规模。全部在 LIBERO 的四个任务套件上评估:Spatial、Object、Goal、Long。每个套件内每个任务报告 20 个 episode 的平均成功率。
对比 FP16 参考、QuantVLA,以及改到 AE 上的扩散 PTQ 基线 PTQ4DiT 与 Q-DiT。同一模型内,各 PTQ 方法使用同一校准集和评测协议。扩散基线方面:PTQ4DiT 使用通道显著度平衡和 Spearman \(\rho\) 引导的显著度校准;Q-DiT 使用自动粒度分配和按样本的动态激活量化。QuantVLA 按其校准和静态 scale 匹配实现,含注意力温度匹配和输出头平衡。评测聚焦 AE;VLM 线性层用面向 LLM 的低比特 PTQ(DuQuant),与 QuantVLA 对 VLM 的处理一致,因此报告的差别只来自 AE 量化。另外报告 AE 延迟、量化线性层的存储与访存,以及预测器开销。
4.2 量化后的 VLA 表现
| 方法 | 精度 | MLP | 注意力投影 | Spa. | Obj. | Goal | Long | 平均 |
|---|---|---|---|---|---|---|---|---|
| FP16 | FP16 | — | — | 98.5 | 99.0 | 97.5 | 93.5 | 97.1 |
| QuantVLA | W4A8 | √ | — | 98.5 | 98.0 | 98.0 | 96.0 | 97.6 |
| QuantVLA(扩大目标) | W4A4 | √ | √ | 98.5 | 98.5 | 93.5 | 90.5 | 95.3 |
| Q-DiT | W4A4 | √ | √ | 97.0 | 97.5 | 95.0 | 88.0 | 94.4 |
| PTQ4DiT | W4A4 | √ | √ | 97.5 | 94.5 | 94.0 | 88.0 | 93.5 |
| CHASE-VLA(无动作上下文) | W4A4 | √ | √ | 98.5 | 97.5 | 93.5 | 92.5 | 95.5 |
| CHASE-VLA | W4A4 | √ | √ | 97.0 | 99.5 | 98.0 | 94.5 | 97.3 |
QuantVLA 既按原设定评了 W4A8、只量化 MLP,也在与 CHASE-VLA 相同的扩大 W4A4 目标上评了一次。CHASE-VLA(无动作)去掉上一块条件,只保留去噪步分组。
在共同的 W4A4 目标上,CHASE-VLA 平均成功率 97.3%,比扩大目标的 QuantVLA、Q-DiT、PTQ4DiT 分别高 2.0、2.9、3.8 个百分点。其 95% 置信区间 [95.9, 98.2]% 与 FP16 的 [95.7, 98.1]% 重叠,点估计也接近。去掉动作上下文后为 95.5%,下降 1.8 个点,Goal 和 Long 更低。
| 模型 | 方法 | 精度 | Spa. | Obj. | Goal | Long | 平均 |
|---|---|---|---|---|---|---|---|
| CogACT | FP16 | FP16 | 87.5 | 98.0 | 95.5 | 91.5 | 93.1 |
| QuantVLA(扩大) | W4A4 | 89.5 | 57.5 | 73.5 | 81.0 | 75.4 | |
| Q-DiT | W4A4 | 81.0 | 73.5 | 83.5 | 73.5 | 77.9 | |
| PTQ4DiT | W4A4 | 87.5 | 77.5 | 80.5 | 73.0 | 79.6 | |
| CHASE-VLA | W4A4 | 86.5 | 97.0 | 88.0 | 90.5 | 90.5 | |
| GR00T N1.6 | FP16 | FP16 | 99.0 | 99.5 | 97.5 | 96.0 | 98.0 |
| QuantVLA(扩大) | W4A4 | 53.0 | 55.0 | 56.0 | 33.5 | 49.4 | |
| Q-DiT | W4A4 | 6.5 | 69.5 | 12.0 | 3.5 | 22.9 | |
| PTQ4DiT | W4A4 | 6.0 | 62.5 | 9.0 | 2.5 | 20.0 | |
| CHASE-VLA | W4A4 | 90.5 | 99.5 | 92.0 | 84.0 | 91.5 |
CogACT 和 GR00T N1.6 上,CHASE-VLA 分别为 90.5% 和 91.5%。95% 置信区间 [88.3, 92.3]% 与 [89.4, 93.2]% 都高于所对比的 W4A4 基线。差距在 GR00T N1.6 上最大:扩大目标的 QuantVLA、Q-DiT、PTQ4DiT 分别只有 49.4%、22.9%、20.0%。详细置信区间见补充材料。
4.3 消融
表 4 原文。 前缀 / 后缀指上一动作块中已执行和未执行的部分。加粗为默认配置对应的数字(下表用 加粗 标出该档)。
| 因素 | 测试设定 | 平均成功率(%) |
|---|---|---|
| 去噪分组数 \(M\) | 1 / 3 / 5 / 10 | 95.5 / 97.3 / 97.1 / 97.4 |
| 不确定性裕度 \(\alpha\) | 0 / 1 / 3 / 5 | 96.3 / 96.9 / 97.3 / 94.8 |
| 动作上下文 | 前缀 / 后缀 / 完整块 | 95.9 / 96.3 / 97.3 |
| 预测器共享 | 共享 / 每层一个 | 96.4 / 97.3 |
| 校准轨迹数 | 2 / 4 / 6 | 96.1 / 96.8 / 97.3 |
三组去噪步得到 97.3%,一组只有 95.5%。十组是 97.4%,但预测器输出更多,因此默认 \(M=3\)。不确定性裕度 \(\alpha=3\) 成功率最高;增到 5 会放宽 scale 范围,降到 94.8%。完整上一块为 97.3%,只使用已执行前缀为 95.9%,只使用未执行后缀为 96.3%。每层一个预测器为 97.3%,共享预测器为 96.4%。两、四、六条校准轨迹分别为 96.1%、96.8%、97.3%。默认是从被评套件以外的每个套件各取两条轨迹。
4.4 效率与开销
存储和访存对比的是 QuantVLA 原始的“只量化 MLP”目标。AE 延迟在 NVIDIA A100 上、batch size 为 1 测量。
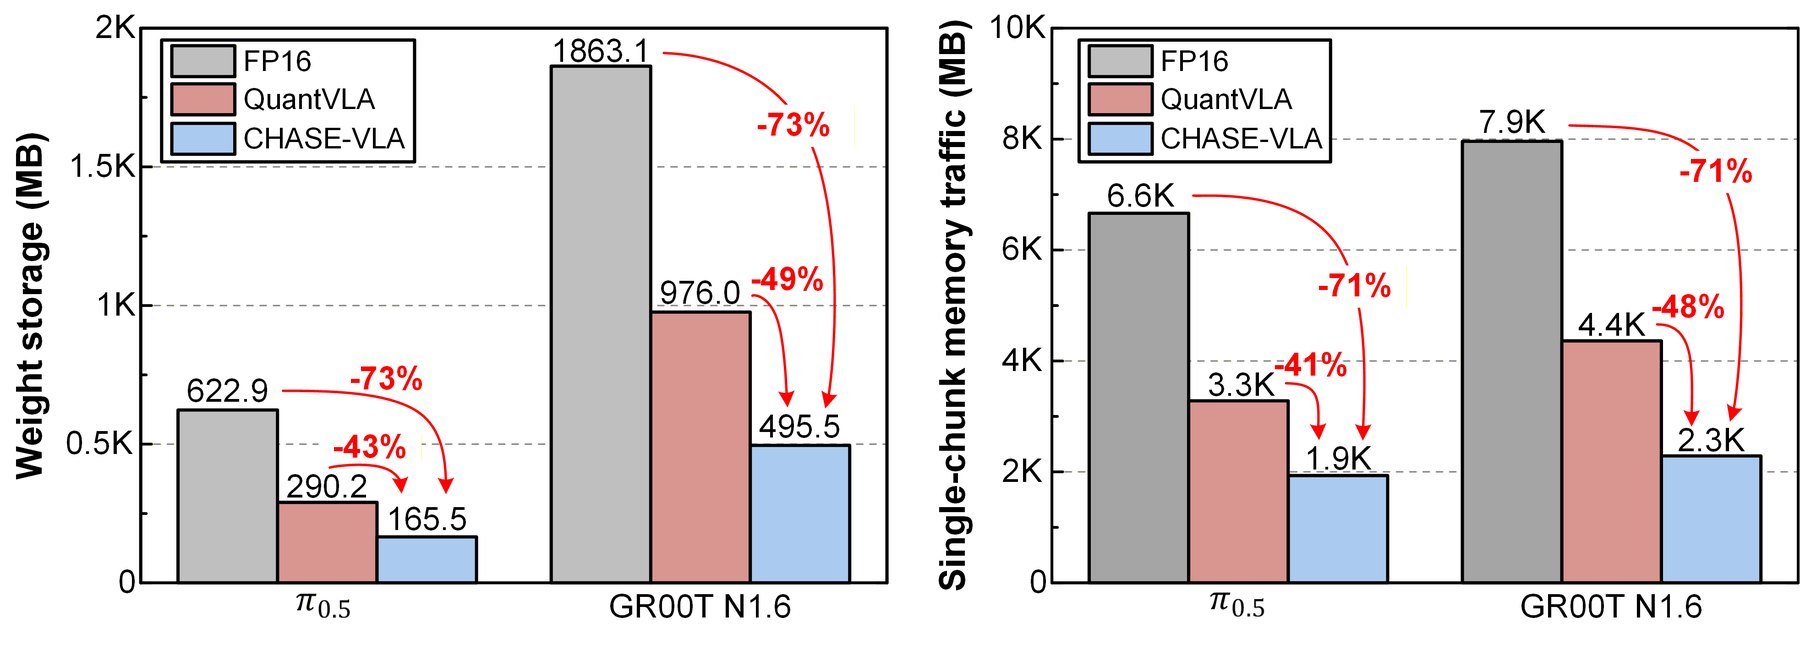
图 4 显示两个模型上,量化 AE 线性层的权重存储都减少 73.4%;QuantVLA 在 π₀.₅ 和 GR00T N1.6 上分别只减少 53.4% 和 47.6%。相对 FP16,单块访存分别下降 70.9% 和 71.2%,绝对值到 1935.55 MB 和 2288.65 MB。
表 5 原文。 CHASE-VLA 对动作专家中全部 MLP 与注意力线性投影做 W4A4。加速比相对各自的 FP16 基线。
| 模型 | FP16 延迟 (ms) | W4A8 延迟 (ms) | W4A8 加速 | CHASE-VLA 延迟 (ms) | CHASE-VLA 加速 |
|---|---|---|---|---|---|
| π₀.₅ | 26.957 | 25.585 | 1.054× | 21.069 | 1.279× |
| GR00T N1.6 | 43.003 | 41.889 | 1.027× | 37.563 | 1.145× |
相对 FP16,CHASE-VLA 把 AE 延迟在 π₀.₅ 上降低 21.8%,在 GR00T N1.6 上降低 12.7%;相对 W4A8 分别降低 17.7% 和 10.3%。预测器存储开销很小:π₀.₅ 上 5.76 MB,GR00T N1.6 上 11.50 MB,分别是所省权重存储的 1.26% 和 0.84%。
5. 结论
CHASE-VLA 把已经生成的动作块当作因果信号,用来估计扩散 VLA 动作专家的激活 scale。在去噪步分组上做动作条件缩放之后,反复执行的 AE 里 MLP 和注意力投影都可以做 W4A4,且不必改预训练策略。AE 线性层为 W4A4 时,π₀.₅ 的 LIBERO 平均成功率回到 FP16 水平(97.3%),CogACT 和 GR00T N1.6 分别为 90.5% 和 91.5%。两个模型上量化 AE 线性层的权重存储都减少 73.4%;单块访存分别减少 70.9% 和 71.2%。预测器开销只占所省存储的 1.26% 和 0.84%。
致谢。本工作由韩国政府(MSIT)资助的国家研究基金会(NRF)项目(RS-2025-02264052、RS-2025-09322969),以及 MSIT 资助的信息通信技术规划与评估院(IITP)项目(RS-2026-25531289,面向新环境的增量自适应端侧学习技术)支持。
参考文献
- Ashkboos 等. QuaRot: Outlier-free 4-bit inference in rotated LLMs. NeurIPS 2024.
- Bjorck 等. GR00T N1. arXiv:2503.14734.
- Black 等. π₀.₅: A vision-language-action model with open-world generalization. CoRL 2025.
- Black 等. π₀. arXiv:2410.24164.
- Brohan 等. RT-2. arXiv:2307.15818.
- Brohan 等. RT-1. arXiv:2212.06817.
- Bu 等. Uni-VLA. arXiv:2505.06111.
- Chen 等. Q-DiT. CVPR 2025.
- Chi 等. Diffusion Policy. IJRR 2025. arXiv:2303.04137.
- Frantar 等. GPTQ. arXiv:2210.17323.
- Ghosh 等. Octo. arXiv:2405.12213.
- Jacob 等. Quantization and training of neural networks for efficient integer-arithmetic-only inference. CVPR 2018.
- Kim 等. Fine-tuning VLA. arXiv:2502.19645.
- Kim 等. OpenVLA. arXiv:2406.09246.
- Li 等. CogACT. arXiv:2411.19650.
- Lin 等. DuQuant. NeurIPS 2024.
- Lin 等. AWQ. MLSys 2024. arXiv:2306.00978.
- Liu 等. LIBERO. NeurIPS 2023.
- Liu 等. RDT-1B. ICLR 2025.
- Nagel 等. Adaptive rounding for PTQ. ICML 2020.
- Peebles, Xie. Scalable diffusion models with transformers. ICCV 2023.
- Wang 等. BitVLA. arXiv:2506.07530.
- Wang 等. VQ-VLA. ICCV 2025.
- Wen 等. DexVLA. arXiv:2502.05855.
- Wen 等. TinyVLA. RA-L 2025.
- Wen 等. DiffusionVLA. ICML 2025.
- Wu 等. PTQ4DiT. NeurIPS 2024.
- Xiao 等. SmoothQuant. ICML 2023. arXiv:2211.10438.
- Xu 等. VLA-Cache. NeurIPS 2025.
- Xu 等. DA-PTQ. arXiv:2604.11572.
- Xu 等. QVLA. arXiv:2602.03782.
- Yang 等. EfficientVLA. NeurIPS 2025.
- Zhang 等. QuantVLA. CVPR 2026.
- Zhang 等. MoLe-VLA. AAAI 2026.
- Zhao 等. ViDiT-Q. ICLR 2025.
- Zheng 等. DyQ-VLA. arXiv:2603.07904.
补充材料
以下为原文补充材料的译文。公式编号在补充材料内单独计数,并标成 (S1)–(S9),以免和正文 (1)–(10) 混淆。
S1. 各 VLA 的动作专家结构
| 模型 | AE 块数 | 去噪步 | 动作块 \(H \times d_a\) | 目标层数 | MLP | 注意力投影 |
|---|---|---|---|---|---|---|
| π₀.₅ | 18 | 10 | 50 × 7 | 126 | 54 | 72 |
| CogACT | 12 | 10 | 16 × 7 | 48 | 24 | 24 |
| GR00T N1.6 | 32 | 4 | 16 × 7 | 192 | 64 | 128 |
动作块列是 CHASE-VLA 做块条件时使用的形状。CogACT 使用融合的注意力投影,π₀.₅ 和 GR00T N1.6 使用分开的注意力投影。GR00T N1.6 的 AE 块更多、注意力投影分开,量化目标比另外两个模型更大。
S2. 预测器结构
每个被量化的 AE 线性层有自己的 scale 预测器,因为各层激活 scale 统计不同。预测器以 FP16 存储,把动作上下文送进两层 MLP,中间是 ReLU,输出 \( f_{\phi_l}(\mathrm{norm}(z)) \in \mathbb{R}^{2M} \)(S1)。 \(z\) 是对应模型展平后的上一动作块。输出按每个去噪步组安排一个对数 scale 调整和一个对数方差。
| 模型 | 预测器个数 | \(d_{\mathrm{in}}\) | \(d_{\mathrm{hid}}\) | \(M\) | \(d_{\mathrm{out}}\) |
|---|---|---|---|---|---|
| π₀.₅ | 126 | 350 | 64 | 3 | 6 |
| CogACT | 48 | 112 | 256 | 3 | 6 |
| GR00T N1.6 | 192 | 112 | 256 | 2 | 4 |
\(d_{\mathrm{in}}\) 是展平后的动作上下文维,\(d_{\mathrm{hid}}\) 是隐层宽度,\(d_{\mathrm{out}}=2M\)。π₀.₅ 用 \(H=50\)、\(d_a=7\),故 \(d_{\mathrm{in}}=350\);CogACT 与 GR00T N1.6 用 \(H=16\)、\(d_a=7\),故 \(d_{\mathrm{in}}=112\)。
S3. 预测器损失
预测器在训练后校准中拟合,预训练 VLA 和 AE 权重冻结,只优化 \(\phi_l\)。对层 \(l\)、组 \(m\),校准目标仍是当前块 scale 与组初始 scale 的以 10 为底对数比(S2,即正文式 10)。预测器输入动作上下文,每个组输出一个对数 scale 调整和一个对数方差(S3)。\(\tau\) 是下次策略查询前执行的动作数。对数空间残差为 \(\Delta_{t_i,l,m} = y^{*} - \hat{y}\)(S4)。
目标由 pinball 项、对数方差头的异方差高斯负对数似然,以及参数均方惩罚组成。pinball 项为
\(\mathcal{D}_l\) 是观察到层 \(l\) 的校准查询集合,\(\beta\) 是分位数。最小化 \(\mathcal{L}_{\mathrm{pin}}\) 拟合的是对数比目标的高分位而不是条件均值,使预测调整反映低比特激活量化下关键的大激活范围。异方差 NLL 为
该项在对数 scale 空间监督方差头;预测标准差乘以 \(\alpha\) 后,成为 scale 乘子 \(\gamma\) 里的不确定性裕度。参数惩罚 \(\mathcal{L}_{\mathrm{reg}} = \sum_{p \in \phi_l} \mathrm{mean}(p^{2})\)(S7)正则化轻量预测器,减轻对校准查询的过拟合。总目标
评测中 \(\beta=0.95\),\(\lambda=0.5\),\(\eta=10^{-2}\)。推理时不确定性只用来构造乘在组初始 scale 上的乘子(S9):\(\alpha=3.0\),\(\gamma_{t,l,m} = 10^{\hat{y}_{t,l,m} + \alpha \hat{\sigma}_{t,l,m}}\)。
S4. 量化细节
校准在预训练策略和 AE 权重全程冻结下进行,用来估计目标 AE 线性层的量化 scale,以及拟合预测器所需的激活统计。对每个 LIBERO 评测套件,校准集从其他套件各随机抽两条轨迹,被评套件不参与抽样,避免校准与评测轨迹重叠。该集合只用于估计激活 scale 统计和拟合预测器。
从校准到推理,量化配置固定。AE 线性层权重使用对称、按行的 4 比特量化,舍入到最近。去噪步对每个 AE 只划分一次,得到的 \(M\) 组在校准和评测中复用。π₀.₅ 与 CogACT 有 \(K=10\) 步,三组大小为 3、4、3,步下标为 \(\{0,1,2\}\)、\(\{3,4,5,6\}\)、\(\{7,8,9\}\)。GR00T N1.6 有 \(K=4\) 步,两组大小都是 2,步下标为 \(\{0,1\}\) 和 \(\{2,3\}\)。
S5. LIBERO 成功率的置信区间
扩大目标的 QuantVLA 与 CHASE-VLA 一样,对 AE 的 MLP 和注意力投影都做 W4A4。
| 方法 | π₀.₅ | CogACT | GR00T N1.6 |
|---|---|---|---|
| FP16 | [95.7, 98.1] | [91.2, 94.7] | [96.8, 98.8] |
| QuantVLA(扩大) | [93.6, 96.5] | [72.3, 78.2] | [45.9, 52.8] |
| Q-DiT | [92.6, 95.8] | [74.9, 80.6] | [20.1, 25.9] |
| PTQ4DiT | [91.6, 95.0] | [76.7, 82.3] | [17.4, 22.9] |
| CHASE-VLA | [95.9, 98.2] | [88.3, 92.3] | [89.4, 93.2] |
π₀.₅ 上 CHASE-VLA 与 FP16 的区间重叠,点估计也接近。CogACT 和 GR00T N1.6 上,CHASE-VLA 的区间高于且不与其他 W4A4 基线重叠。
S6. 无预测器的 scale 基线
在 π₀.₅ 的 LIBERO 上,与三条不使用预测器的规则比较。Prev-query AbsMax 复用上一次查询在每层、每组上的激活最大值。AbsMax EMA 用 \(\rho=0.9\) 的指数滑动平均平滑这些最大值。Motion lookup 把上一动作块的能量和变化映射到校准好的 scale 表。
| scale 调整 | Spatial | Object | Goal | Long | 平均 |
|---|---|---|---|---|---|
| Prev-query AbsMax | 97.0 | 98.0 | 96.5 | 92.0 | 95.9 |
| AbsMax EMA | 97.5 | 98.5 | 95.5 | 92.5 | 96.0 |
| Motion lookup | 97.0 | 98.5 | 97.5 | 92.5 | 96.4 |
| CHASE-VLA | 97.0 | 99.5 | 98.0 | 94.5 | 97.3 |
CHASE-VLA 比最强的无预测器基线 Motion lookup 平均高 0.9 个百分点。
S7. SimplerEnv
在 SimplerEnv 上评 GR00T N1.6,设置包括 Variant Aggregation(VA)和 Visual Matching(VM)。量化方法里 VLM 保持 FP16,AE 的 QKVO 投影和 MLP 使用 W4A4。相对 FP16,CHASE-VLA 在 Google Robot (VA)、Google Robot (VM)、WidowX (VM) 上分别差 +0.45、−2.67、−1.72 个百分点。
| 评测设置 | FP16 | QuantVLA | CHASE-VLA |
|---|---|---|---|
| Google Robot (VA) | 46.54 | 29.47 | 46.99 |
| Google Robot (VM) | 56.00 | 43.67 | 53.33 |
| WidowX (VM) | 64.86 | 59.71 | 63.14 |