DemoSpeedup:基于熵引导示范加速的视觉运动策略加速
中文译文,原文 DemoSpeedup: Accelerating Visuomotor Policies via Entropy-Guided Demonstration Acceleration (arXiv:2506.05064)。图、表见 arXiv HTML 与 PDF。 项目页: demospeedup.github.io。
关键词: 模仿学习 · 操作 · 示范加速
1 引言
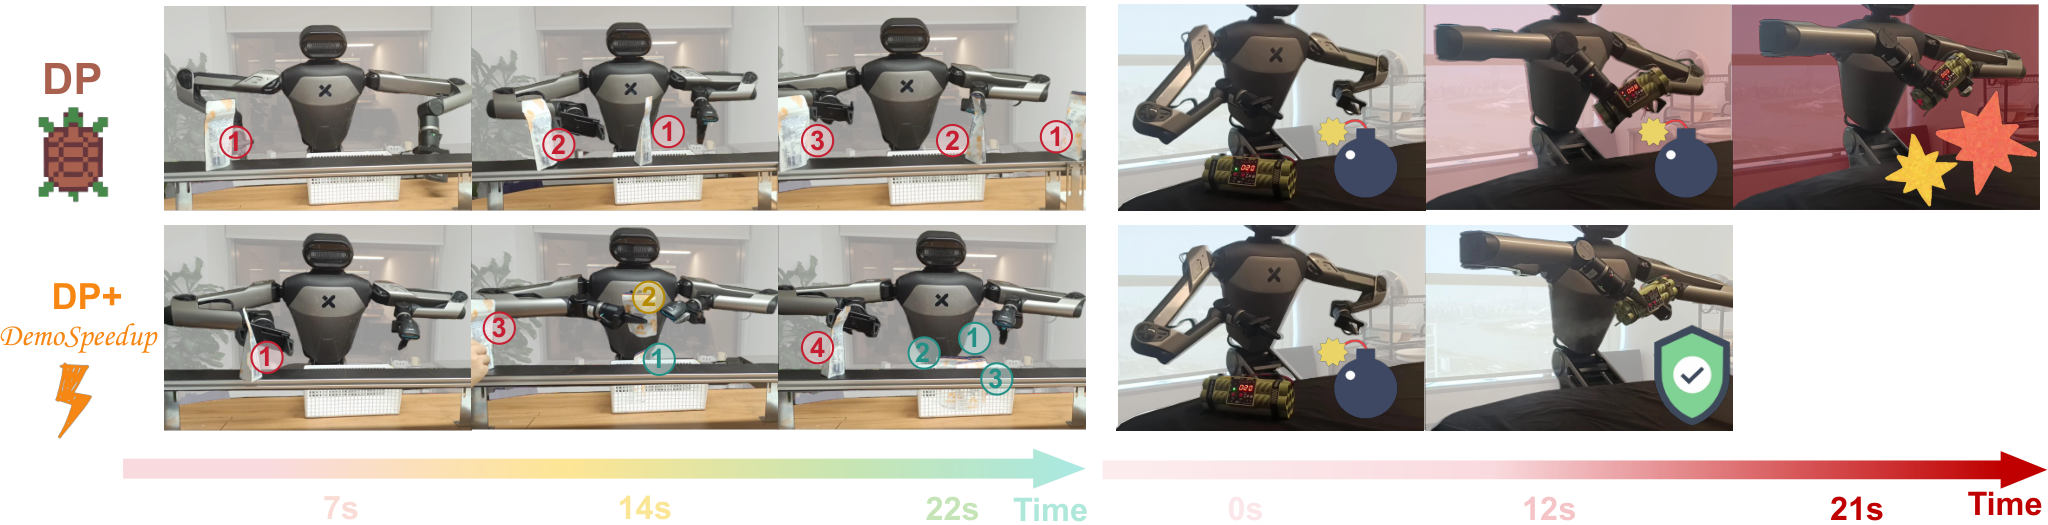
从任务完成率角度看,模仿学习已在机器人操作中取得显著成功 [1, 2, 3, 4],但视觉运动策略的时间效率往往不够理想。为了呈现更流畅的效果,策略学习社区已形成惯例:展示视频常被加速 $2\times\sim 10\times$ [1, 2, 5]。然而,在照看婴幼儿与老人、产线制造等对时间敏感的真实场景中,低效率本身就会成为问题。
近来出现一些测试时策略加速技术:在测试时对即将执行的动作块(action chunk)做朴素下采样 [6, 7]。但当加速比较高(例如 $2\times$)时,部署阶段的速度分布偏移往往导致明显性能下降。
本文假设:人类操作员采集的偏慢示范,是行为克隆策略执行缓慢的主因。经验上,即便有超过 $100$ 小时经验的熟练采集者也很难像用手一样流畅地遥操作机械臂。在 VR [8, 9, 10] 与运动学示教 [11, 12, 13, 14] 中,缺乏对三维场景全方位、无遮挡的观测,以及缺失触觉本体感觉,都是难以更快运动的主要障碍。此外,人机形态差异与设备时延进一步增加遥操作难度、拖慢数据采集。
针对人类示范偏慢的问题,我们提出 DemoSpeedup,在不牺牲任务完成性能的前提下提升策略执行效率。不同于以恒定倍率对整条轨迹做朴素下采样,DemoSpeedup 保留高精度段落(如抓取物体),仅在低精度段落(如空中接近物体)加速,从而在加速后仍促进任务成功率。
DemoSpeedup 的核心是熵引导的精度度量机制,可自适应调整加速倍率,且无需额外人工标注或任务专用先验。我们观察到:在低精度段落,操作员往往有多种随意却合理的选择;在高精度段落,行为更一致以保证成功。因此,反映动作随机性的动作熵,可作为精度需求的隐式指标。然而,示范轨迹中记录的离散动作在多维连续动作空间中极为稀疏,这是离线从人类示范直接计算动作熵的主要障碍。
DemoSpeedup 通过从自监督代理策略估计动作熵来克服该障碍:代理策略可以是在未加速源数据上训练的任意生成式行为学习策略。它不负责动作预测,只用于蒸馏源数据中的动作熵信息。随后用基于聚类的方案,将代理推断的逐帧熵处理为带精度标签的轨迹分段,以便分段变速率加速。最终,加速数据集用于训练加速后的行为克隆策略——这是部署时用于动作预测的 DemoSpeedup 终产物。
我们以 ACT [15] 与 Diffusion Policy (DP) [1] 实例化 DemoSpeedup,并在仿真与真实世界多样任务上验证:时间效率可达约 $1.7\times\sim 3\times$,任务成功率与未加速数据训练的同策略持平,有时甚至更高。
2 相关工作
从人类示范学习。 从人类示范学习已成为机器人操作的主流路径。模仿学习训练的生成式策略(如 ACT [15]、Diffusion Policy [1])可达到与示范匹配的性能;泛化能力亦逐年提升 [16, 17, 18]。但当前范式的执行速度仍受慢示范制约。这一问题在遥操作采集的大规模数据 [19, 20, 21, 22] 中同样存在:用这些数据训练的 VLA [19, 23, 24, 25] 虽泛化强,但大量慢示范使策略远慢于正常人类速度,阻碍日常落地。
面向操作的数据整理。 若干工作通过整理数据提高成功率:[26] 训练并交叉验证分类器以区分成功/失败 rollout,过滤异构示范;[27, 28] 用几何或人工标注指标下采样示范,显示缩短 episode 长度可降低复合误差 [29] 并提高成功率,但依赖闭环控制、反而拉长操作时间。总体而言,这些方法聚焦成功率;本文整理数据的目标是提升操作速度,同时 episode 变短,可能顺带提升性能。
3 方法
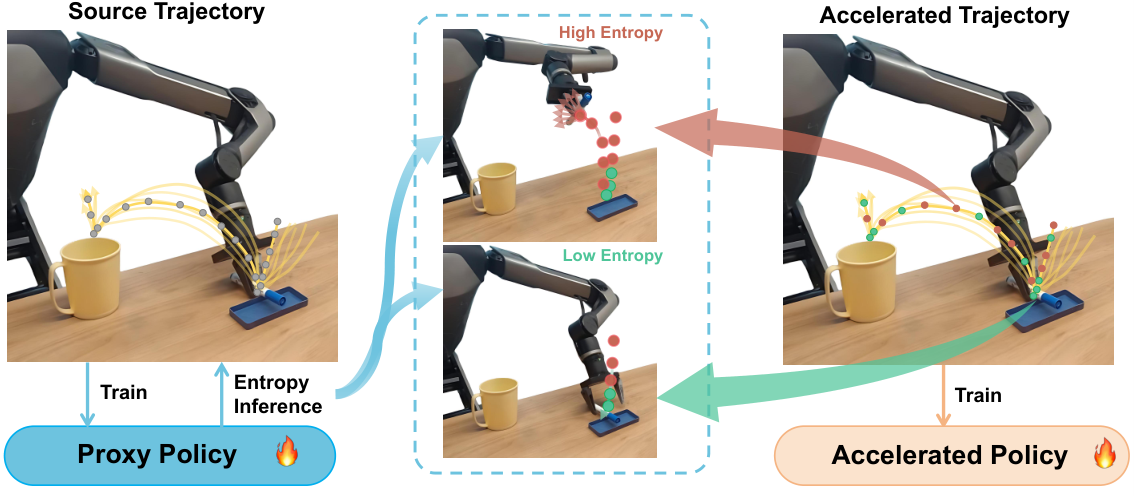
本节介绍 DemoSpeedup:用熵引导加速示范以加快策略执行。如图 2,先用源数据训练代理策略,以非参数方式估计动作熵;再用基于密度的聚类将轨迹分为高精度与低精度集合,并按精度水平分段下采样;最后给出若干训练与部署细节以保证加速策略性能。
3.1 动作熵估计
我们用动作熵反映人类示范中某动作所需精度。为估计示范帧的条件动作熵,DemoSpeedup 先在原始速度示范源集上训练代理策略。将行为克隆策略表示为 $\pi_{\theta}(A_{t}|o_{t})$,其中动作块 $A_{t}=\{a_{t}[t],a_{t}[t+1],\ldots,a_{t}[t+K-1]\}$ [30],$K$ 为块长度。为计算熵,在当前观测 $o_{t}$ 条件下采样 $N$ 个动作块样本 $\{a^{i}_{t}[t],\ldots,a^{i}_{t}[t+K-1]\}_{i=1}^{N}$。再做高斯核密度估计 [31],得到条件于当前观测的动作概率密度:
其中 $h$ 为带宽。随后在 $o_{t}$ 处估计条件动作熵:
对数据集中所有轨迹的所有时间步执行上述逐帧操作。代理策略实例化为 ACT [15] 或 DP [1]。对 ACT,通过在 CVAE 先验中采样不同潜变量得到动作样本,即 $x\sim\mathcal{N}(0,1)$;对 DP,则在给定观测下采样多条噪声序列生成动作样本。
3.2 熵引导的示范加速
估计得到的熵用于识别不同片段的精度水平并以不同倍率加速。我们设计基于聚类的方法确定精度水平,并用熵引导示范加速。
熵预处理。 遥操作数据噪声较大、不利聚类,故先用 Isolation Forest [32] 检测单条轨迹中的异常熵值,异常点用相邻正常值替换。然后将每帧熵 $\hat{H}(a_{t}|o_{t})$ 与时间索引 $t$ 拼接以保留时序属性,并对该 episode 内所有熵点归一化以备聚类。
聚类以标注精度。 采用基于密度的聚类将熵点划分为细粒度(高精度)与粗粒度(低精度)区域。具体使用层次密度聚类 HDBSCAN [33]。高熵点标为离群,低熵区域形成簇。为进一步排除噪声,仅保留平均熵低于零的簇。保留簇中的时间索引构成集合 $P$(精度集),其余为集合 $C$(随意集)。
先复制再下采样(Replicate-before-downsample, RBD)。 获得精度标签后,可对时间片段以不同倍率下采样加速。但对整条轨迹 $\{(o_{t},a_{t})\}_{t=1}^{T}$ 朴素下采样会显著减少访问状态多样性,浪费示范并严重掉点。为避免信息损失,我们采用简单的 RBD:保留源数据中出现的全部观测帧。具体地,在加速倍率 $N\times$ 时,将目标动作块复制为 $N$ 份;第 $i$ 份以偏移 $i$ 帧、倍率 $N\times$ 下采样。策略本质上把块拆成 $N$ 个加速子块,而非跳过中间帧,从而保持与源示范相同的访问状态多样性。
几何一致性。 动作块长度对模仿学习性能至关重要,需确定加速策略的块长度。我们选择使动作块走过的几何路程与原策略大致相同。这样,对示范中相同片段,加速策略只需拟合更少动作标签,有利于收敛并降低复合误差。
控制器要求。 采集与部署加速动作需要高精度机器人控制器。若控制器不准,原速与加速动作的控制动力学会差异很大,导致掉点。评估中发现部分夹爪控制器无法跟踪高速而导致失败;简单提高夹爪增益即可解决。
4 实验
| 方法 | Transfer Cube | Insertion | Sandwich Remove | Move Plate | Load Cups | Put Cups | ||||||
|---|---|---|---|---|---|---|---|---|---|---|---|---|
| 成功率$\uparrow$ | 长度$\downarrow$ | 成功率$\uparrow$ | 长度$\downarrow$ | 成功率$\uparrow$ | 长度$\downarrow$ | 成功率$\uparrow$ | 长度$\downarrow$ | 成功率$\uparrow$ | 长度$\downarrow$ | 成功率$\uparrow$ | 长度$\downarrow$ | |
| ACT | $72\%$ | $291$ | $21\%$ | $452$ | $53\%$ | $368$ | $\mathbf{54\%}$ | $157$ | $\mathbf{61\%}$ | $319$ | $61\%$ | $288$ |
| ACT-2× | $70\%$ | $162$ | $13\%$ | $238$ | $46\%$ | $193$ | $46\%$ | $119$ | $50\%$ | $195$ | $54\%$ | $141$ |
| ACT+DemoSpeedup | $\mathbf{81\%}$ | $\mathbf{121}$ | $\mathbf{30\%}$ | $\mathbf{151}$ | $\mathbf{77\%}$ | $\mathbf{156}$ | $53\%$ | $\mathbf{91}$ | $59\%$ | $\mathbf{176}$ | $\mathbf{62\%}$ | $\mathbf{132}$ |
| DP | $66\%$ | $281$ | $16\%$ | $431$ | $52\%$ | $352$ | $\mathbf{52\%}$ | $170$ | $15\%$ | $419$ | $12\%$ | $386$ |
| DP-2× | $61\%$ | $146$ | $12\%$ | $245$ | $51\%$ | $247$ | $41\%$ | $125$ | $11\%$ | $177$ | $7\%$ | $243$ |
| DP+DemoSpeedup | $\mathbf{74\%}$ | $\mathbf{107}$ | $\mathbf{29\%}$ | $\mathbf{218}$ | $\mathbf{54\%}$ | $\mathbf{217}$ | $49\%$ | $\mathbf{113}$ | $\mathbf{38\%}$ | $\mathbf{171}$ | $\mathbf{21\%}$ | $\mathbf{205}$ |
| 方法 | Saucepan to Hob | Drawers Close | Open Trays | Flip Cutlery | Cupboard Open | 平均 | ||||||
|---|---|---|---|---|---|---|---|---|---|---|---|---|
| 成功率$\uparrow$ | 长度$\downarrow$ | 成功率$\uparrow$ | 长度$\downarrow$ | 成功率$\uparrow$ | 长度$\downarrow$ | 成功率$\uparrow$ | 长度$\downarrow$ | 成功率$\uparrow$ | 长度$\downarrow$ | 成功率$\uparrow$ | 加速比$\uparrow$ | |
| ACT | $86\%$ | $383$ | $\mathbf{100\%}$ | $119$ | $\mathbf{100\%}$ | $244$ | $\mathbf{63\%}$ | $193$ | $\mathbf{100\%}$ | $146$ | $77\%$ | $1.0\times$ |
| ACT-2× | $81\%$ | $224$ | $87\%$ | $84$ | $93\%$ | $149$ | $49\%$ | $\mathbf{121}$ | $96\%$ | $103$ | $69\%$ | $1.7\times$ |
| ACT+DemoSpeedup | $\mathbf{92\%}$ | $\mathbf{163}$ | $\mathbf{100\%}$ | $\mathbf{63}$ | $\mathbf{100\%}$ | $\mathbf{105}$ | $62\%$ | $141$ | $\mathbf{100\%}$ | $\mathbf{81}$ | $\mathbf{82\%}$ | $\mathbf{2.1\times}$ |
| DP | $\mathbf{79\%}$ | $324$ | $\mathbf{96\%}$ | $114$ | $94\%$ | $245$ | $\mathbf{22\%}$ | $175$ | $\mathbf{100\%}$ | $181$ | $55\%$ | $1.0\times$ |
| DP-2× | $41\%$ | $242$ | $81\%$ | $65$ | $86\%$ | $157$ | $18\%$ | $127$ | $94\%$ | $161$ | $45\%$ | $1.6\times$ |
| DP+DemoSpeedup | $\mathbf{79\%}$ | $\mathbf{169}$ | $89\%$ | $\mathbf{59}$ | $\mathbf{96\%}$ | $\mathbf{138}$ | $17\%$ | $\mathbf{98}$ | $\mathbf{100\%}$ | $\mathbf{103}$ | $\mathbf{59\%}$ | $\mathbf{1.9\times}$ |
表 1: 仿真结果。DemoSpeedup 在不同平台与任务上取得显著加速,同时保持可比成功率。
4.1 仿真实验
对比方法。 将在 DemoSpeedup 加速数据集上训练的策略,与在原速示范上训练的同款 ACT/DP 对比;并与测试时朴素 $2\times$ 下采样动作块 [6] 对比(记为 ACT-$2\times$、DP-$2\times$)。
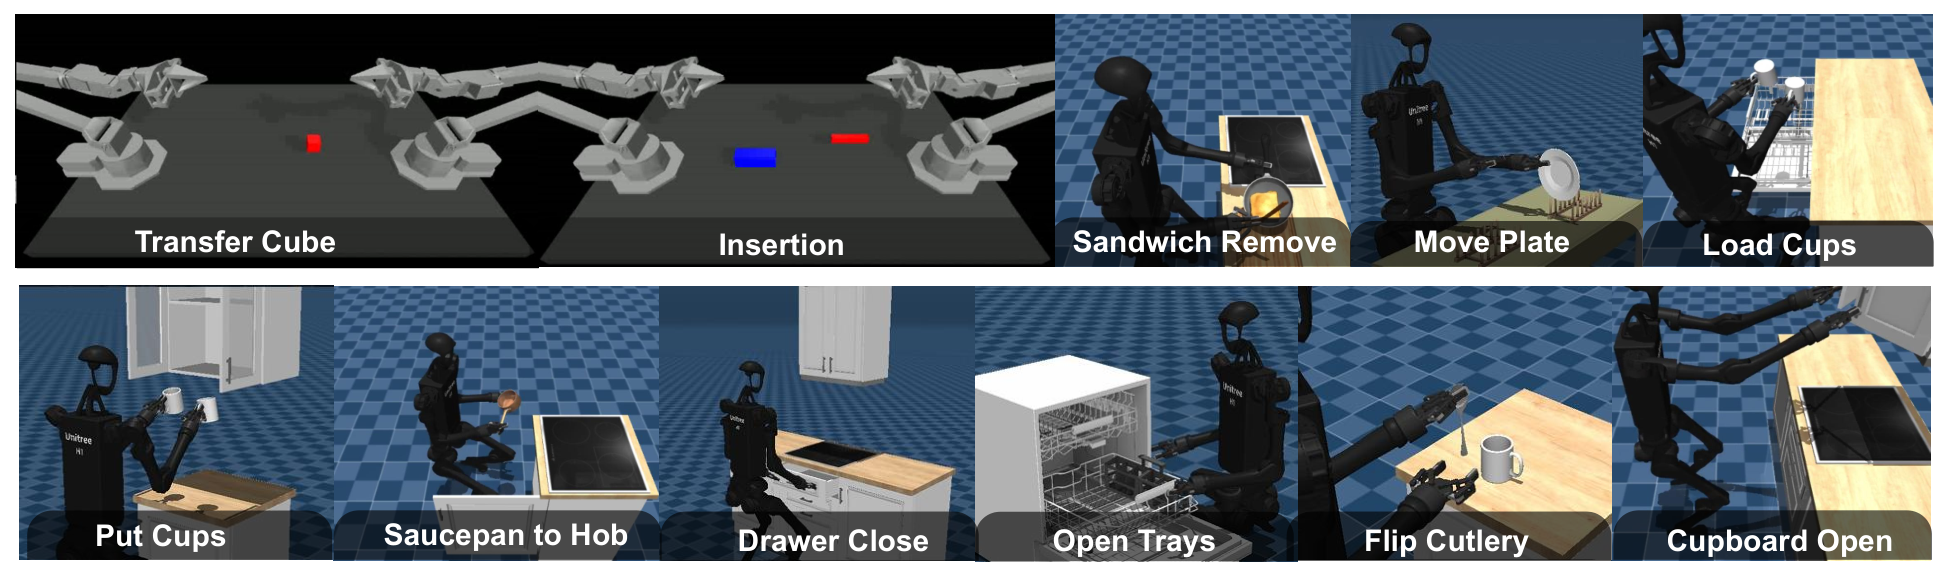
任务。 共 $11$ 个任务,选自 Aloha [15] 与 BiGym [34],见图 3。Aloha 侧重高精度:Transfer Cube、Insert,各 $50$ 条人类示范。BiGym 侧重移动操作与长时程;我们对 ACT/DP 做了两项改进:(1) 底盘动作空间改为位置控制;(2) DP 中用 Multi-view Vision Transformer [36] 替换 ResNet [35] 以增强多视角融合。为公平评估,回放基准示范并过滤失败样本 [37];排除成功率极低($<10\%$)的任务。最终选 $9$ 个 BiGym 任务,示范数量不等,控制频率 $20\,\mathrm{Hz}$–$50\,\mathrm{Hz}$。
指标。 报告任务成功率,以及成功 rollout 的平均 episode 长度以衡量时间效率。Aloha:取验证损失最小 checkpoint [27, 15],各 $50$ 次 rollout。BiGym:报告训练过程中 $50$ 次评估里的最高成功率及对应平均长度。结果在 $3$ 个种子上平均。
结果。 见表 1。相对原速示范训练的 ACT/DP,DemoSpeedup 加速数据训练的同策略完成时间最短且性能可比。整体平均约 $2\times$ 加速,最高约 $3\times$。测试时下采样虽缩短时间,但平均成功率下降超过 $8\%$,凸显示范加速相对测试时加速的优势。
4.2 真实世界实验
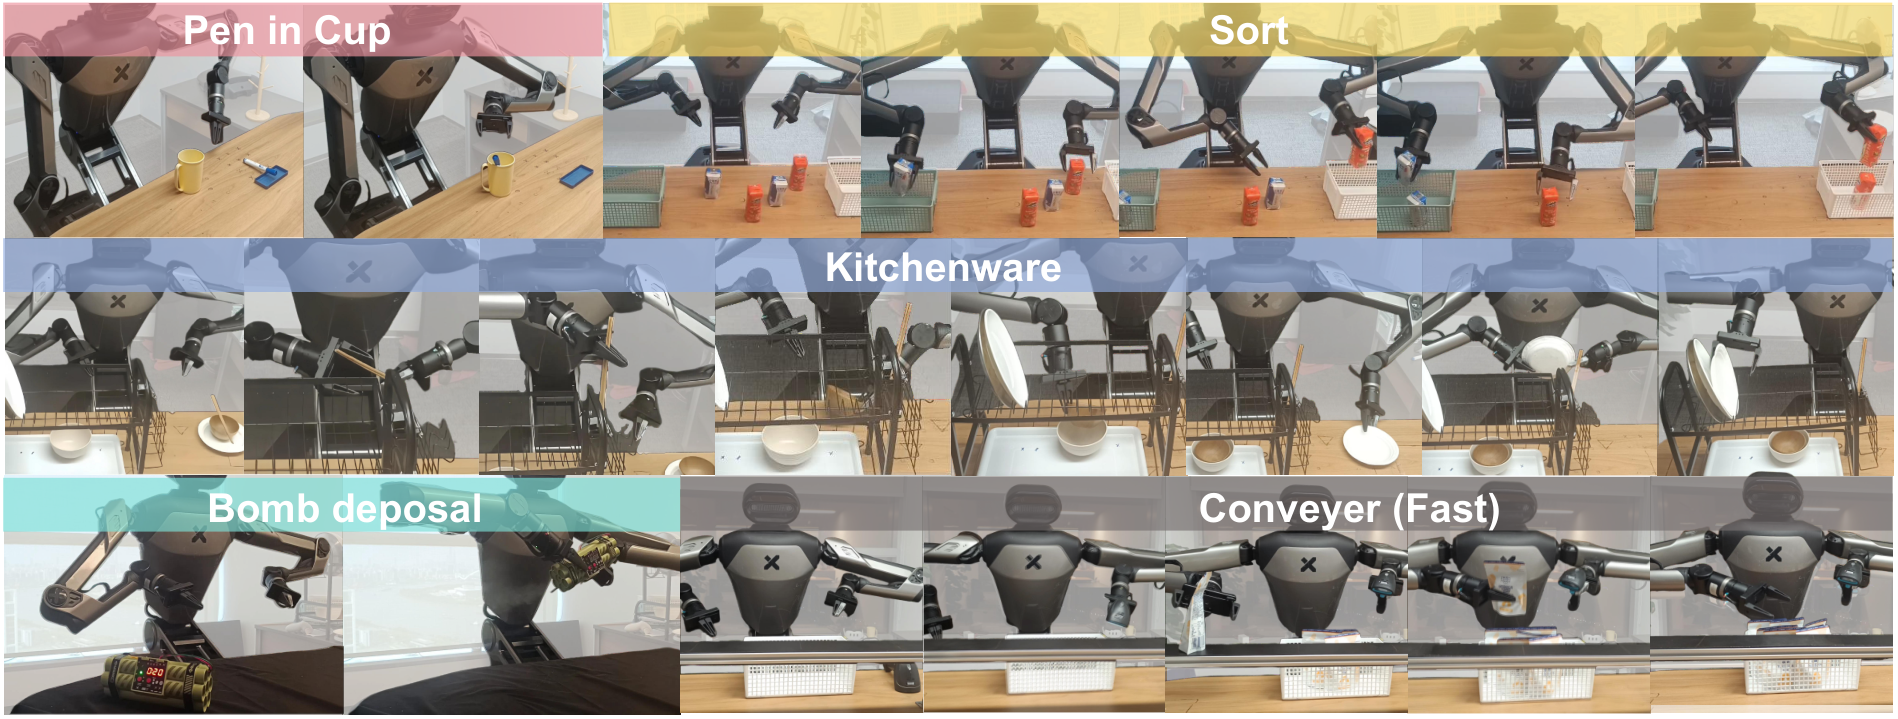
任务。 在双臂人形平台 Galaxea R1 上设计 $5$ 个任务及一个变体(图 4):
- Pen in Cup: 拾起笔并放入杯中。
- Sort: 将白色酸奶瓶放入绿色篮、红色放入白色盒。
- Kitchenware: 左臂依次抓取筷子、碗、盘,转交右臂并放到指定位置——长时程、多技能(传递、插入)。
- Bomb Deposal: 抓住玩具炸弹移至胸前,双臂精确协作拆除电池线。
- Conveyer: 拿起扫码枪,抓住传送带上运动的袋子扫码,再放入篮中;袋子由人持续放入。
- Conveyer Fast: 用与 Conveyer 相同 checkpoint,在 $2\times$ 更快传送带上评估,模拟希望机器人比采集数据时更高效的场景。
RGB 观测来自头部 Zed2;用 GalaxeaVR [38] 各采 $100$ 条示范。物体配置在采集与评估中均随机化。
指标。 每任务约 $30$ 次评估,报告成功次数与平均耗时。秒表从机器人离开默认关节位开始,到完成任务并回到默认位结束。
| 方法 | Pen in Cup | Sort | Bomb Deposal | Kitchenware | Conveyer | Conveyer Fast | ||||||
|---|---|---|---|---|---|---|---|---|---|---|---|---|
| 成功率$\uparrow$ | 耗时$\downarrow$ | 成功率$\uparrow$ | 耗时$\downarrow$ | 成功率$\uparrow$ | 耗时$\downarrow$ | 成功率$\uparrow$ | 耗时$\downarrow$ | 成功率$\uparrow$ | 耗时$\downarrow$ | 成功率$\uparrow$ | 耗时$\downarrow$ | |
| ACT | $16/30$ | $19.45s$ | $29/40$ | $56.78s$ | $\mathbf{7/27}$ | $42.13s$ | $6/33$ | $66.32s$ | $18/30$ | $13.14s$ | $2/30$ | $12.68s$ |
| ACT+Ours | $\mathbf{24/30}$ | $\mathbf{8.28s}$ | $\mathbf{31/40}$ | $\mathbf{20.38s}$ | $6/27$ | $\mathbf{26.31s}$ | $\mathbf{7/33}$ | $\mathbf{27.26s}$ | $\mathbf{21/30}$ | $\mathbf{6.57s}$ | $\mathbf{16/30}$ | $\mathbf{6.28s}$ |
| DP | $15/30$ | $15.69s$ | $32/40$ | $39.29s$ | $6/27$ | $35.69s$ | $\mathbf{19/33}$ | $61.12s$ | $\mathbf{28/30}$ | $13.39s$ | $7/30$ | $12.96s$ |
| DP+Ours | $\mathbf{23/30}$ | $\mathbf{7.52s}$ | $\mathbf{38/40}$ | $\mathbf{18.32s}$ | $\mathbf{11/27}$ | $\mathbf{19.18s}$ | $17/33$ | $\mathbf{39.23s}$ | $25/30$ | $\mathbf{6.24s}$ | $\mathbf{27/30}$ | $\mathbf{6.03s}$ |
表 2: 真实世界结果。DemoSpeedup 有效加速视觉运动策略,并有潜力提升成功率。
加速效率。 表 2 显示 DemoSpeedup 在多数任务取得最低耗时并保持性能。对 Bomb Deposal、Kitchenware 等高精度任务,至少约 $1.6\times$ 加速;对精度要求不高的任务更高,如 Sort 上 ACT 约 $2.78\times$、DP 约 $2.14\times$。ACT 上加速往往高于 DP,部分因 DP 推理延迟:更快运动间的突然停顿使动作略抖,削弱加速收益。
提升成功率的潜力。 有趣的是,DemoSpeedup 在部分任务还能提高成功率。我们认为部分原因是决策视界缩短,从而降低模仿学习复合误差 [29];另一原因是示范越慢,每时间步变化越小,动作边际信息越少,复杂数据更难拟合 [39]。例如 Pen in Cup 中,测试杯位被训练覆盖,但原速示范训练的策略比加速示范更容易错过正确位置。此外,真实世界与 Aloha 示范慢于 BiGym,故 DemoSpeedup 增益在前两者更明显——说明数据质量与速度相关,DemoSpeedup 有助于拟合数据。
4.3 消融实验
| 消融 | ACT | DP |
|---|---|---|
| DemoSpeedup | $\mathbf{56\%}$ | $\mathbf{52\%}$ |
| 无 RBD 策略 | $29\%$ | $26\%$ |
| 无几何一致性 | $31\%$ | $34\%$ |
| 无高精度控制 | $53\%$ | $41\%$ |
表 3: 消融成功率(任务平均)。
在 Aloha 两任务上用 ACT/DP 做消融:整条轨迹朴素下采样(去掉 RBD);使用相同动作块长度(去掉几何一致性);夹爪无高精度控制。表 3 显示这些设计对 DemoSpeedup 性能均重要。
4.4 可视化分析
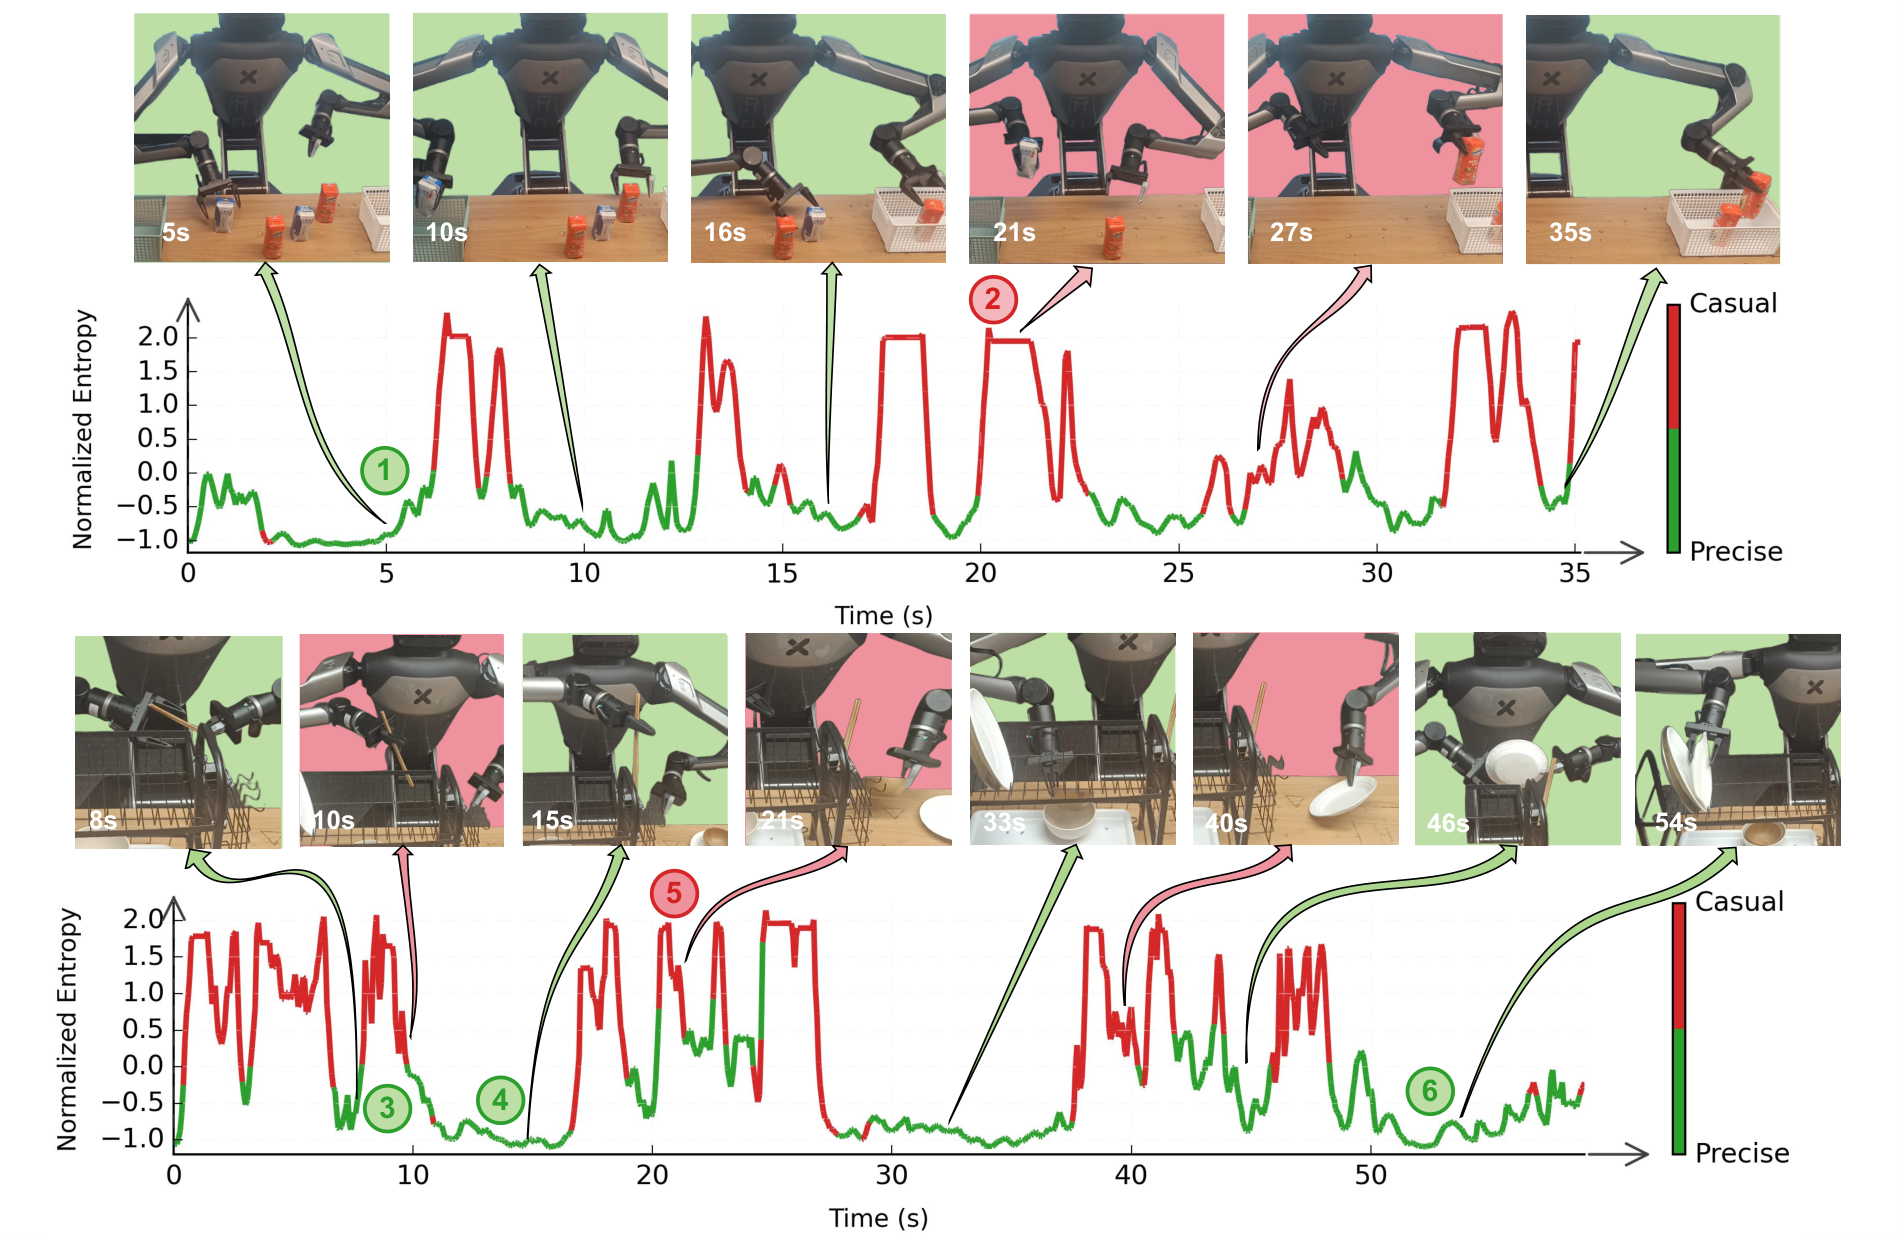
为深入理解熵捕捉的模式,我们将熵曲线与示范快照对照(图 5)。熵与分段方法能有效区分精确技能与随意运动。接近物体(标记 2)或空中搬运(标记 5)等多被识别为随意部分;精度部分不仅包含接触丰富技能(抓酸奶标记 1、传递筷子标记 3),也包括无接触但需谨慎的动作(从已插入盘中小心抽出夹爪以免碰倒,标记 6;将筷子对齐窄缝,标记 4)。
5 结论
本文提出 DemoSpeedup:自监督加速视觉运动策略执行的方法。它利用生成式策略估计的动作熵引导示范加速;用聚类按熵将示范分为不同精度水平,再以随熵增大的倍率下采样。实验表明,DemoSpeedup 可在多种模仿学习算法与机器人平台上取得显著加速并保持任务性能。
局限。 其一,虽在部分任务提高成功率,偶有轻微掉点,可能因原速与加速示范间动力学不匹配。其二,作为自监督流程,避免了人工监督;但不同操作员采集速度差异使可加速潜力不同,期望加速倍率仍需人工选定。其三,未考虑影响执行加速的 DP 推理延迟;可用蒸馏 [40, 41] 或流式策略 [2] 缓解。
致谢。 感谢 Galaxea 的硬件支持与维护;感谢焦振宇、董珂、李一秀在控制器上的技术支持;感谢盛珂、齐正浩在 VR 设置与 Galaxea R1 模仿学习调参上的建议;感谢胡凯哲对方向的初期讨论,以及袁哲成协助数据采集。本项目获清华大学笃实计划支持。
6 DemoSpeedup 伪代码
算法 1 给出完整伪代码。
7 补充对比
7.1 与其他示范加速方法对比
将熵引导分段加速替换为以下基线:
- Contact Oracle: 基于接触的启发式分段。场景中出现新物体对接触/脱离时,接触状态变化前后恒定时间窗标为精度,其余为随意。需 oracle 与精确三维先验,真实世界仅 2D 相机时难获得。
- AWE*: 调整 AWE [27] 的动态规划下采样。原 AWE 在关节角轨迹分段线性逼近误差阈值约束下将轨迹缩至约 $7\times$–$10\times$,但到达路点更慢。我们调阈值使长度约缩至 $2\times$,并以原控制频率部署以加速;并用熵对逼近误差重加权。
- Constant $2\times$ / $3\times$: 整条示范恒定倍率下采样。
其余因素(RBD、几何一致性)保持一致。Aloha 上用 ACT/DP。与 Contact Oracle 对比时,因原数据无特权信息,用训练好的 ACT 重新采集 $50$ 条含接触信息的示范,三方法同数据训练。
| 方法 & 算法 | Transfer Cube & ACT | Insertion & ACT | Transfer Cube & DP | Insertion & DP | ||||
|---|---|---|---|---|---|---|---|---|
| 成功率$\uparrow$ | 长度$\downarrow$ | 成功率$\uparrow$ | 长度$\downarrow$ | 成功率$\uparrow$ | 长度$\downarrow$ | 成功率$\uparrow$ | 长度$\downarrow$ | |
| Origin | $\mathbf{40\%}$ | $321$ | $11\%$ | $435$ | $47\%$ | $289$ | $12\%$ | $329$ |
| Contact Oracle | $37\%$ | $140$ | $15\%$ | $142$ | $37\%$ | $124$ | $11\%$ | $\mathbf{127}$ |
| DemoSpeedup | $\mathbf{40\%}$ | $\mathbf{137}$ | $\mathbf{22\%}$ | $\mathbf{125}$ | $\mathbf{49\%}$ | $\mathbf{121}$ | $\mathbf{16\%}$ | $145$ |
表 4: 与 Contact Oracle 对比。DemoSpeedup 成功率与 Origin 可比且常优于 Contact Oracle,加速相近。
| 方法 & 算法 | Transfer Cube & ACT | Insertion & ACT | Transfer Cube & DP | Insertion & DP | ||||
|---|---|---|---|---|---|---|---|---|
| 成功率$\uparrow$ | 长度$\downarrow$ | 成功率$\uparrow$ | 长度$\downarrow$ | 成功率$\uparrow$ | 长度$\downarrow$ | 成功率$\uparrow$ | 长度$\downarrow$ | |
| Origin | $72\%$ | $291$ | $21\%$ | $452$ | $66\%$ | $281$ | $16\%$ | $431$ |
| AWE* | $63\%$ | $148$ | $14\%$ | $183$ | $53\%$ | $169$ | $9\%$ | $221$ |
| Constant $2\times$ | $80\%$ | $167$ | $27\%$ | $242$ | $\mathbf{75\%}$ | $152$ | $20\%$ | $247$ |
| Constant $3\times$ | $47\%$ | $126$ | $7\%$ | $163$ | $39\%$ | $109$ | $4\%$ | $\mathbf{198}$ |
| DemoSpeedup | $\mathbf{81\%}$ | $\mathbf{121}$ | $\mathbf{30\%}$ | $\mathbf{151}$ | $74\%$ | $\mathbf{107}$ | $\mathbf{29\%}$ | $218$ |
表 5: 与其他下采样基线对比。DemoSpeedup 在成功率与速度间取得最佳平衡。
Contact Oracle 常低于 Origin:接触模式无法覆盖全部精度模式。例如 Insertion 中,一块与另一块首次接触后接触模式不变,难以捕捉后续插入的接触丰富阶段;接触变化时刻附近的恒定时间窗也无法准确估计精度段时长。
DemoSpeedup 与 Constant $2\times$ 成功率相近,与 Constant $3\times$ 加速相近。AWE* 在加速设定下甚至差于 Constant $2\times$,因其动态规划未考虑所选动作平滑性,加速策略动作抖动。这说明“加速执行”不同于传统下采样设定的独特挑战。
7.2 与传统下采样方法的差异
- 执行频率。 我们降低示范频率,但不降低策略执行频率。例如 $50\,\mathrm{Hz}$ 示范传统方法可能下采样到 $20\,\mathrm{Hz}$ 并以 $20\,\mathrm{Hz}$ 部署;我们按约 $20\,\mathrm{Hz}$ 下采样示范,但以原 $50\,\mathrm{Hz}$ 部署以加速执行。
- 新挑战。 核心是加速同时几乎不容许成功率下降(即便 $<5\%$)。先前如 Keyframes [42] 依赖闭环到达路点,速度甚至慢于原示范;本文执行远快于示范,因而对精度模式识别要求更高。传统启发式在此挑战下表现不佳(见 7.1);DemoSpeedup 用熵较好缓解并保持性能。
8 超参数
8.1 高低下采样倍率
关键超参是 $r_{high}$ 与 $r_{low}$。多数任务保持相同,显示鲁棒性;若未加速示范已够快或任务极需精度,则需少量试验微调。经验上倍率取整数即可;可并行训练多种倍率再评估择优。
| 任务 | $\{r_{low},r_{high}\}$ | 任务 | $\{r_{low},r_{high}\}$ |
|---|---|---|---|
| Transfer Cube | {2, 4} | Open Trays | {2, 4} |
| Insertion | {2, 4} | Flip Cutlery | {1, 3} |
| Sandwich Remove | {2, 4} | Cupboard Open | {2, 4} |
| Move Plate | {2, 4} | Pen in Cup | {2, 4} |
| Load Cups | {2, 4} | Sort | {2, 4} |
| Put Cups | {2, 4} | Kitchenware | {2, 4} |
| Saucepan to Hob | {2, 4} | Bomb Deposal | {2, 3} |
| Drawer Close | {2, 4} | Conveyer | {2, 4} |
表 6: ACT 的高低下采样倍率。
| 任务 | $\{r_{low},r_{high}\}$ | 任务 | $\{r_{low},r_{high}\}$ |
|---|---|---|---|
| Transfer Cube | {2, 4} | Open Trays | {2, 4} |
| Insertion | {2, 4} | Flip Cutlery | {1, 3} |
| Sandwich Remove | {2, 4} | Cupboard Open | {2, 4} |
| Move Plate | {2, 3} | Pen in Cup | {2, 4} |
| Load Cups | {2, 4} | Sort | {2, 4} |
| Put Cups | {2, 3} | Kitchenware | {2, 3} |
| Saucepan to Hob | {2, 4} | Bomb Deposal | {2, 3} |
| Drawer Close | {2, 4} | Conveyer | {2, 4} |
表 7: DP 的高低下采样倍率。
8.2 ACT 超参数
各任务共用表 8 配置。块长度用时间时长表示(控制频率不同);具体块大小 = 时长 × 频率。ACT+DemoSpeedup 取 ACT 块长一半以保持几何一致性(实验中多数加速约 $2\times$)。
| 超参数 | ACT | ACT + DemoSpeedup |
|---|---|---|
| learning rate | $1\times10^{-5}$ | $1\times10^{-5}$ |
| # encoder layers | 4 | 4 |
| # decoder layers | 7 | 7 |
| feedforward dimension | 3200 | 3200 |
| hidden dimension | 512 | 512 |
| # heads | 8 | 8 |
| chunk length | $1\,\mathrm{s}$ | $0.5\,\mathrm{s}$ |
| beta | 10 | 10 |
| dropout | 0.1 | 0.1 |
表 8: ACT 与 ACT+DemoSpeedup 超参数,主要差异是块长减半。
8.3 Diffusion Policy 超参数
Aloha / BiGym / 真实世界分别配置(表 9、10),均为 CNN 版 DP。DemoSpeedup 版本主要减小 chunk size。
| 超参数 | Aloha | Bigym | Real-world |
|---|---|---|---|
| observation horizon | 1 | 1 | 1 |
| diffusion_step_embed_dim | 128 | 256 | 128 |
| down_dims | [512,1024,2048] | [256,512,1024] | [512,1024,2048] |
| kernel_size | 5 | 5 | 5 |
| n_groups | 8 | 8 | 8 |
| vision_model | Resnet18 | MVT [36] | Resnet18 |
| chunk size | 48 | 16 | 24 |
| Lr | $1\times10^{-4}$ | $1\times10^{-4}$ | $1\times10^{-4}$ |
| WDecay | $1\times10^{-6}$ | $1\times10^{-6}$ | $1\times10^{-6}$ |
| scheduler | DDIM | DDIM | DDIM |
| $D$-Iters Train | 100 | 100 | 100 |
| $D$-Iters Eval | 10 | 10 | 10 |
表 9: Diffusion Policy 超参数。
| 超参数 | Aloha | Bigym | Real-world |
|---|---|---|---|
| observation horizon | 1 | 1 | 1 |
| diffusion_step_embed_dim | 128 | 256 | 128 |
| down_dims | [512,1024,2048] | [256,512,1024] | [512,1024,2048] |
| kernel_size | 5 | 5 | 5 |
| n_groups | 8 | 8 | 8 |
| vision_model | Resnet18 | MVT [36] | Resnet18 |
| chunk size | 24 | 8 | 12 |
| Lr | $1\times10^{-4}$ | $1\times10^{-4}$ | $1\times10^{-4}$ |
| WDecay | $1\times10^{-6}$ | $1\times10^{-6}$ | $1\times10^{-6}$ |
| scheduler | DDIM | DDIM | DDIM |
| $D$-Iters Train | 100 | 100 | 100 |
| $D$-Iters Eval | 10 | 10 | 10 |
表 10: DP+DemoSpeedup 超参数,主要差异是 chunk size 减小。
参考文献
- C. Chi et al. Diffusion policy: Visuomotor policy learning via action diffusion. IJRR, 2023.
- K. Black et al. $\pi_0$: A vision-language-action flow model for general robot control. arXiv:2410.24164, 2024.
- T. Z. Zhao et al. Aloha unleashed: A simple recipe for robot dexterity. arXiv:2410.13126, 2024.
- Y. Ze et al. 3D diffusion policy. arXiv:2403.03954, 2024.
- Z. Xue et al. DemoGen. arXiv:2502.16932, 2025.
- Figure AI Helix logistics. https://www.figure.ai/news/helix-logistics. Accessed 2025-2-26.
- J. Xie et al. Subconscious robotic imitation learning. arXiv:2412.20368, 2024.
- X. Cheng et al. Open-Television. arXiv:2407.01512, 2024.
- R. Ding et al. Bunny-VisionPro. arXiv:2407.03162, 2024.
- Y. Ze et al. Generalizable humanoid manipulation with improved 3D diffusion policies. arXiv:2410.10803, 2024.
- Z. Fu, T. Z. Zhao, C. Finn. Mobile ALOHA. arXiv:2401.02117, 2024.
- P. Wu et al. GELLO. IROS, 2024.
- S. Yang et al. ACE. arXiv:2408.11805, 2024.
- Y. Jiang et al. Behavior Robot Suite. arXiv:2503.05652, 2025.
- T. Z. Zhao et al. Learning fine-grained bimanual manipulation with low-cost hardware (ACT). arXiv:2304.13705, 2023.
- Physical Intelligence et al. $\pi_{0.5}$. arXiv:2504.16054, 2025.
- D. Qu et al. SpatialVLA. arXiv:2501.15830, 2025.
- J. Liu et al. HybridVLA. arXiv:2503.10631, 2025.
- Q. Bu et al. AgiBot World Colosseo. arXiv:2503.06669, 2025.
- K. Wu et al. RoboMind. arXiv:2412.13877, 2024.
- A. Khazatsky et al. DROID. arXiv:2403.12945, 2024.
- A. O’Neill et al. Open X-Embodiment. ICRA, 2024.
- J. Bjorck et al. GR00T N1. arXiv:2503.14734, 2025.
- M. J. Kim et al. OpenVLA. arXiv:2406.09246, 2024.
- Q. Li et al. CogACT. arXiv:2411.19650, 2024.
- A. S. Chen et al. Curating demonstrations using online experience. arXiv:2503.03707, 2025.
- L. X. Shi et al. Waypoint-based imitation learning (AWE). arXiv:2307.14326, 2023.
- S. Belkhale, Y. Cui, D. Sadigh. HYDRA. CoRL, 2023.
- S. Belkhale, Y. Cui, D. Sadigh. Data quality in imitation learning. NeurIPS, 2023.
- L. Lai, A. Z. Huang, S. J. Gershman. Action chunking as policy compression. 2022.
- J. Heer. Fast & accurate Gaussian KDE. IEEE VIS, 2021.
- D. Xu et al. Improved anomaly detection based on Isolation Forest. ISCID, 2017.
- L. McInnes et al. hdbscan: Hierarchical density based clustering. JOSS, 2017.
- N. Chernyadev et al. BiGym. arXiv:2407.07788, 2024.
- K. He et al. Deep residual learning for image recognition. CVPR, 2016.
- Y. Seo et al. Multi-view masked world models. ICML, 2023.
- Y. Seo, P. Abbeel. Coarse-to-fine Q-network with action sequence…
- Galaxea R1 VR Teleop. https://docs.galaxea-ai.com/zh/Guide/R1/R1_VR_Teleop_Usage_Tutorial/
- K. Pertsch et al. FAST. arXiv:2501.09747, 2025.
- A. Prasad et al. Consistency Policy. arXiv:2405.07503, 2024.
- G. Lu et al. ManiCM. arXiv:2406.01586, 2024.
- M. Shridhar, L. Manuelli, D. Fox. Perceiver-Actor. CoRL, 2023.