SAIL:模仿学习策略的超示教速度执行
中文译文,原文 SAIL: Faster-than-Demonstration Execution of Imitation Learning Policies (arXiv:2506.11948,CoRL 2025)。图、表链回 arXiv HTML 与 PDF。 项目页: sail-robot.github.io · nadunranawaka1.github.io/sail-policy。 关键词:Imitation Learning · Diffusion Policy · Speed Adaptation · Classifier-Free Guidance。
1. 引言
速度对真实世界的机器人学习应用至关重要。近期的离线模仿学习方法 [1, 2] 在可变形物体操作、非抓取式操作等复杂任务上表现出色,但它们的表现高度依赖人类示教,而人类示教通常很慢,策略也就继承了迟缓的动作。因此本文要回答的问题是:如何让已学好的视觉运动策略跑得比示教还快?难点在于,执行速度一旦提高,机器人动力学就变了,跟踪误差和各种动态效应随之出现;这又会让观测分布发生偏移,反过来把策略推离它所学到的先验分布。此外,实际能加速多少还受推理延迟、传感器延迟和控制带宽的限制 [3],所以提速本身是一个全栈 (full-stack) 问题。以往工作通常默认训练与部署时的执行速度一致。
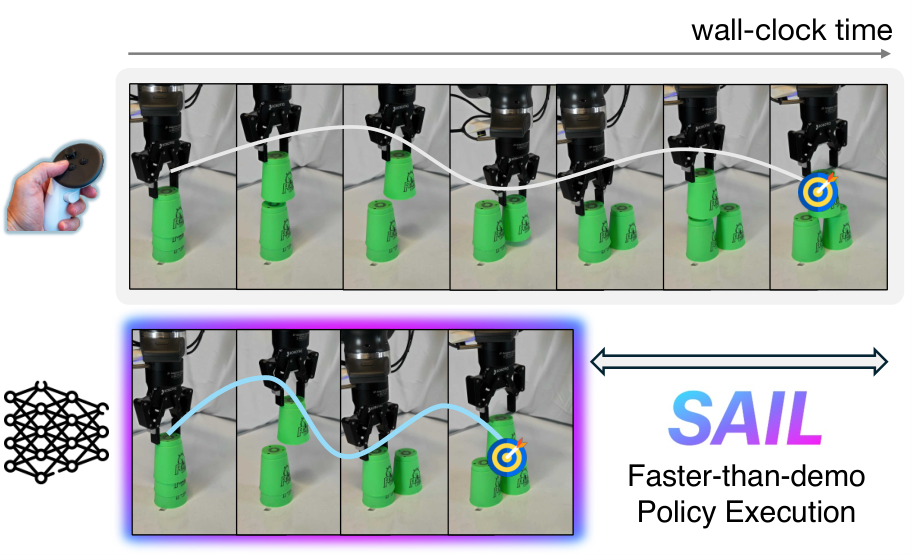
我们提出 SAIL(Speed Adaptation for Imitation Learning)作为解决该问题的全栈框架(图 1)。核心洞察是:要让策略成功加速,必须同时处理机器人动力学的变化,以及由此引起的状态—动作分布偏移。在策略层面,SAIL 包含两部分:(1) 一种控制器误差感知的生成式引导算法,能在不同执行速度下给出时间上一致的动作预测(第 4.1 节);(2) 自适应速度调制,根据任务需求动态调整执行速度,需要精度时放慢,其余时间加快(第 4.3 节)。在系统层面,SAIL 还包含两部分:(1) 训练策略去预测与控制器无关的动作目标,并用高保真控制器去跟踪这些目标,以缓解动力学偏移(第 4.2 节);(2) 对动作执行做自适应调度,使机器人在存在传感与计算延迟时仍能保持实时控制(第 4.4 节)。
这套全栈方案使 SAIL 在多种操作任务上取得明显更高的任务吞吐量。我们在仿真中验证了关键技术洞察和设计选择:SAIL 相对示教速度最高可加速 \(4\times\),同时保持较高的任务成功率。我们还在两套控制器与动力学各不相同的真实机器人系统上演示了 SAIL,在 7 个任务上最高加速 \(3.2\times\),这些任务涉及长时程、高精度和双臂协同等挑战。
2. 相关工作
离线模仿学习。 离线模仿学习(也称从示教中学习,LfD)是给机器人编程、使其从人类示教中学会行为的常用手段 [4, 5, 6, 7]。其中行为克隆 (BC) [7] 用深度网络从示教数据里学出观测到动作的映射。近期 BC 工作引入了深度生成模型 [2, 1],以保留真实轨迹的多模态特性。然而如先前工作所述 [2, 8],从这类学到的轨迹分布中采样,可能破坏相邻预测步之间的时间依赖,而执行速度越快,这个问题越严重。与“速度自适应模仿”关系较近的是状态空间框架,例如动态运动基元 (Dynamic Movement Primitives, DMP) [9, 10, 11] 与黎曼运动策略 (Riemannian Motion Policies, RMP) [12],它们在理论上支持对运动做时间调制。虽然已有一些方法 [13, 14, 15, 16] 把这类技术融入端到端的模仿学习,但领域内更广泛采用的仍是 Diffusion Policy [1] 这类较简单的算法。
优于示教的模仿学习。 有多条研究线索试图学出优于专家的策略 [17, 18, 19]。例如 T-REX [17] 利用基于排序的奖励函数去评估未见过的策略行为,从而学出优于示教的策略。另一些工作 [3, 20] 依赖后续的自监督在线学习,并配合任务相关的奖励设计 [21],能把执行速度提高 1.1–1.3 倍,但代价是成功率下降。此外,这类方法通常处于逆强化学习 (Inverse Reinforcement Learning) [22, 23, 24] 的设定中,需要在环境中交互学习。相比之下,我们关注纯离线设定:把离线学到的策略在运行时执行得更快。
SPHINX [25] 等近期工作在执行时间和加速比上有一定改善,但这些收益通常只是其方法的副产物,而我们把更快执行明确作为首要目标。
模仿学习的系统集成。 近期工作已不再局限于纯算法创新,开始构建面向模仿学习的全栈系统 [2, 26, 27, 28, 29],其中 Mobile-ALOHA [26] 与 UMI [29] 等系统展示了把底层机器人控制器与学习算法联合优化的巨大价值。但这些工作都没有考虑“有意让策略执行速度不同于示教速度”这一问题。我们的核心贡献在于:明确这一新问题设定下的关键挑战,并提出一套能让策略以快于示教的速度执行的系统。
3. 预备知识、挑战与问题定义
策略与控制器层级。 我们考虑一个两层结构的机器人控制系统:(1) 高层神经网络策略 \(\pi(x,o)\),根据当前机器人状态 \(x\) 与传感观测 \(o\) 生成动作指令 \(a\);(2) 底层机器人控制器 \(\mathcal{K}\),把 \(a\) 转换成关节力矩 \(u\)。为使方法具有普适性,我们沿用常见设定 [1, 29, 30],假设 \(\pi\) 输出的是动作轨迹
其中 \(H\) 为预测时域 (prediction horizon),每个 \(x^{\mathrm{d}}_i\) 包含期望的 SE(3) 末端执行器位姿与夹爪指令。控制器 \(\mathcal{K}\) 负责跟踪这条轨迹:给定当前状态 \(x_t\) 以及参考配置之间固定的时间间隔 \(\delta^{*}\),它为每个期望位姿 \(x^{\mathrm{d}}_t\) 算出力矩 \(u_t=\mathcal{K}(x^{\mathrm{d}}_t,x_t,\delta^{*})\)。\(\mathcal{K}\) 的运行频率通常远高于策略推理频率,会执行多个控制步来跟踪每个 \(x^{\mathrm{d}}_t\)。策略一般以滚动时域 (receding-horizon) 方式部署:只执行轨迹的一部分(\(H^{\mathrm{e}}<H\) 步)就重新规划。
离线模仿学习。 我们关注离线模仿学习:策略 \(\pi\) 从遥操作采集的静态数据集 \(\mathcal{D}=\{(o_t,x_t,x^{\mathrm{d}}_t)\}_{t=1}^{n}\) 中学得。每条数据包含传感观测 \(o_t\)、机器人状态 \(x_t\) 和遥操作者下达的期望配置 \(x^{\mathrm{d}}_t\),采样间隔固定为 \(\delta^{*}\)。训练用的动作监督 \(a_t\) 由示教中连续的未来期望配置 \([x^{\mathrm{d}}_t,\cdots,x^{\mathrm{d}}_{t+H-1}]\) 构成。本文以 Diffusion Policy (DP) [1] 作为代表性的高性能策略模型。DP 以当前的 \((o_t,x_t)\) 为条件,通过迭代去噪生成多步动作轨迹,其去噪更新为
其中 \(\epsilon_\theta\) 是学到的去噪网络。这种动作块 (action chunking) 能力 [1, 2, 30] 有利于应对推理延迟。但训练数据有限、策略本身又带概率性,相邻两次预测出的轨迹可能在时间上不一致 [8],高速时尤其容易造成动作抖动。另外,网络推理带来的延迟必须在实时高速控制中加以处理(第 4.4 节)。需要说明的是,系统中除一个组件外,其余都可用于 ACT [2] 等其他生成式策略模型,我们在附录 K 中给出了结果。
挑战与问题定义。 让学到的策略比示教更快地执行,会带来超出标准模仿学习的关键挑战。首先,提速会显著加剧分布偏移:系统动力学改变、控制器出现误差,把策略推入陌生的分布外 (Out-of-Distribution, OOD) 状态,误差累积 [31] 随之导致失败。其次,提速也考验执行保真度:底层控制器可能跟不上快速轨迹,“示教与执行时控制器行为一致”的假设不再成立,而且高精度阶段本来就需要放慢。最后,真实系统延迟对控制回路频率设定了硬性物理上限,从根本上限制了可达到的最高速度。于是核心研究问题是:给定以时间间隔 \(\delta^{*}\) 训练的策略 \(\pi\),如何以更快、随时间变化的间隔
来执行它(\(c_t\) 为加速因子,越小越快),在克服分布偏移、执行保真度与延迟这些相互交织的挑战的同时,显著提高成功完成任务的吞吐量?
4. 方法:模仿学习的速度自适应 (SAIL)
4.1 通过误差自适应引导实现一致的动作预测
显著快于示教的执行会从根本上改变控制器动力学,导致跟踪误差增大,使机器人状态 \((o_t,x_t)\) 相对训练时数据集 \(\mathcal{D}\) 中的经验变为分布外 (OOD)。这给基于滚动时域的视觉运动策略带来关键挑战:上一步执行中的跟踪误差造成 OOD 输入后,策略 \(\pi\) 给出的下一段动作预测 \(\hat{a}_{0:H}\) 可能与刚刚执行完的动作 \(a_{H^{\mathrm{e}}:H^{\mathrm{e}}+H^{\mathrm{f}}}\) 不一致。如图 3 所示,规划步之间的这种预测发散,在机器人上表现为抖动或不稳定的运动。
为缓解这一点,一种想法是用无分类器引导 (Classifier-Free Guidance, CFG) [32] 强制时间平滑性。CFG 让下一段动作序列 \(\hat{a}_{0:H}\) 的预测以先前规划序列的尾部 \(a^{\mathrm{c}}=a_{H^{\mathrm{e}}:H^{\mathrm{e}}+H^{\mathrm{f}}}\) 为条件,从而鼓励一致性。具体做法是用引导权重 \(w\) 把条件得分估计 \(\epsilon_{\theta}(a^{\mathrm{f}},a^{\mathrm{c}}|o_t,x_t)\) 与无条件得分估计 \(\epsilon_{\theta}(a^{\mathrm{f}},\emptyset|o_t,x_t)\) 混合:
然而在高速执行时直接套用 CFG 引导(\(w>0\))可能适得其反。如果执行 \(a^{\mathrm{c}}\) 期间出现了显著的跟踪误差,那么条件模型 \(\epsilon_{\theta}(\cdot,a^{\mathrm{c}}|o_t,x_t)\) 的输入 \((x_t,a^{\mathrm{c}})\) 实际上已是 OOD。强烈依赖这种不可靠信息只会给出误导性的引导,甚至进一步加剧发散。这也暴露出现有思路的局限:它们要么在动作生成之后再做事后平滑 [8, 2],要么隐含假设执行动力学一致 [1, 33],都没有在生成过程中直接处理由控制器偏移引起的 OOD 输入。
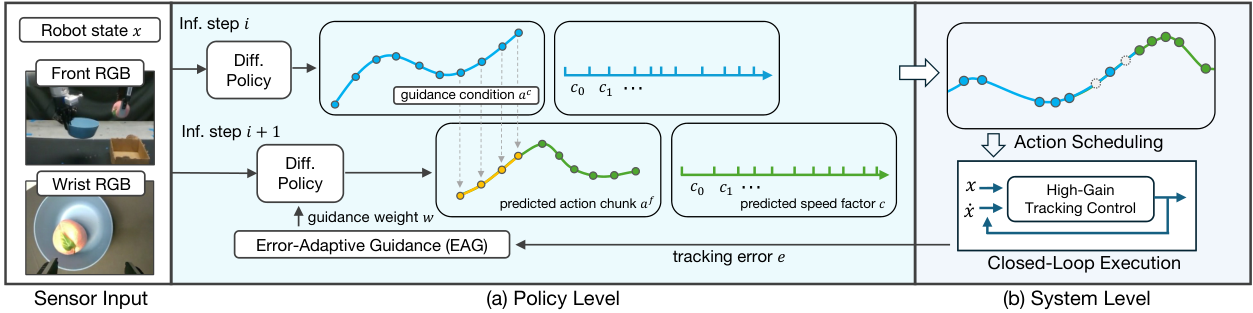
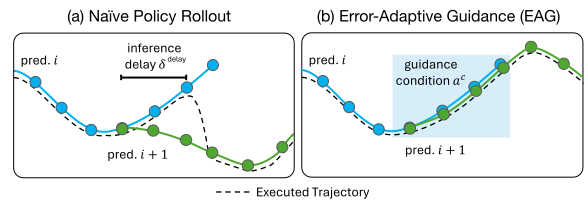
为此我们提出误差自适应引导 (Error-Adaptive Guidance, EAG)。我们认识到,CFG 条件化是否有用,取决于条件信号的质量,而这一质量会随跟踪误差增大而下降。因此我们用当前末端执行器的跟踪误差 \(e=\mathrm{err}(x^{\mathrm{d}},x^{\mathrm{current}})\) 作为这种潜在 OOD 状态的高效代理指标(在附录 H.3 中验证)。算法会动态调整 CFG 的引导权重 \(w\):若跟踪准确(\(e\le\rho\)),则认为条件可靠,使用标准 CFG 引导(\(w>0\));反之若误差较大(\(e>\rho\)),说明条件输入 \(a^{\mathrm{c}}\) 很可能因 OOD 状态而不可靠,此时关闭引导(\(w=0\)),只依赖无条件预测 \(\epsilon_{\theta}(a^{\mathrm{f}},\emptyset|o_t,x_t)\)。写成统一形式即
并把 \(w_{\mathrm{eff}}\) 代入式 (1)。这种自适应机制使 SAIL 在跟踪准确时强制保持时间一致性,在遇到控制器偏移时又避免被可能错误的引导误导,从而保住鲁棒性。图 2 展示了 EAG 如何融入整个系统,算法 2(附录 H)给出了具体实现:位置误差取 \(e_{\mathrm{pos}}=\lVert a_{\mathrm{pos}}-x_{\mathrm{pos}}\rVert\),姿态误差取 \(e_{\mathrm{ori}}=\arccos\bigl(\tfrac{\operatorname{tr}(R_{\triangle})-1}{2}\bigr)\),其中 \(R_{\triangle}=R(a_{\mathrm{ori}})^{\top}R(x_{\mathrm{ori}})\),任一超过阈值就把条件替换为空 token \(\emptyset\)。
4.2 用与控制器无关的动作目标减小控制器偏移
4.1 节是从算法层面自适应地处理 OOD 状态,而高速执行时分布偏移的一个主要来源,是底层控制器行为的变化。标准模仿学习通常训练策略 \(\pi\) 去预测遥操作采集到的指令位姿 (commanded pose) \(x^{\mathrm{d}}\)(采集间隔为 \(\delta^{*}\),且为保证操作者体验往往使用低增益控制器),部署时再用同一个遥操作控制器 \(\mathcal{K}^{\mathrm{teleop}}\) 去执行。可是当 \(\mathcal{K}^{\mathrm{teleop}}\) 在更短的间隔 \(\delta_t<\delta^{*}\) 下运行时,其动力学和跟踪误差特性都会改变,给策略喂进 OOD 的状态输入,拖累性能(图 4 中)。
为在系统层面缓解这一问题,我们首先改变策略预测的对象。策略不再预测指令位姿 \(x^{\mathrm{d}}\),而是直接从示教数据中学习预测到达位姿 (reached pose) \(x\)(图 4 右)。到达位姿反映机器人真实走过的轨迹,天然是可实现的。更关键的是,这个目标在很大程度上不依赖于数据采集时所用的、可能偏柔顺或带噪声的 \(\mathcal{K}^{\mathrm{teleop}}\) 的具体动力学,因而在不同执行速度下为策略提供了更稳定的预测目标。
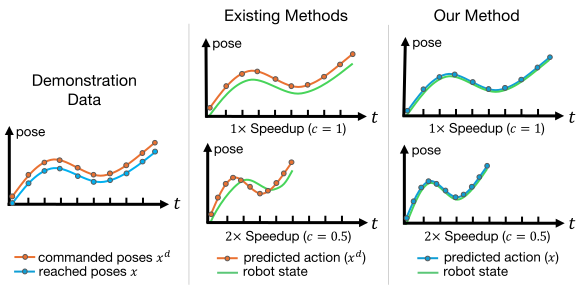
与此配合,我们也改变预测动作的执行方式。高速部署时,用一个专为快速、准确运动优化的高保真跟踪控制器 \(\mathcal{K}^{\mathrm{e}}\) 取代原来的 \(\mathcal{K}^{\mathrm{teleop}}\)。它以策略预测的到达位姿 \(x_t\) 为目标,生成力矩
即使在缩短后的间隔 \(\delta_t\) 下也能紧密跟随目标。用高性能控制器(如附录 D 中的高增益 OSC,也可以是 MPC 等)去跟踪这个不变的到达位姿目标,就把策略执行与遥操作控制器的可变动力学解耦,减少了控制器引起的分布偏移。
4.3 自适应速度的策略执行
在整个操作任务中一律以最高速度执行,会损害成功率,抓取、对准等精细交互阶段尤其如此。SAIL 会自动识别这类关键动作 (critical action),并按实时上下文动态调整瞬时加速因子 \(c_t\):关键动作放慢,其余时间加速。
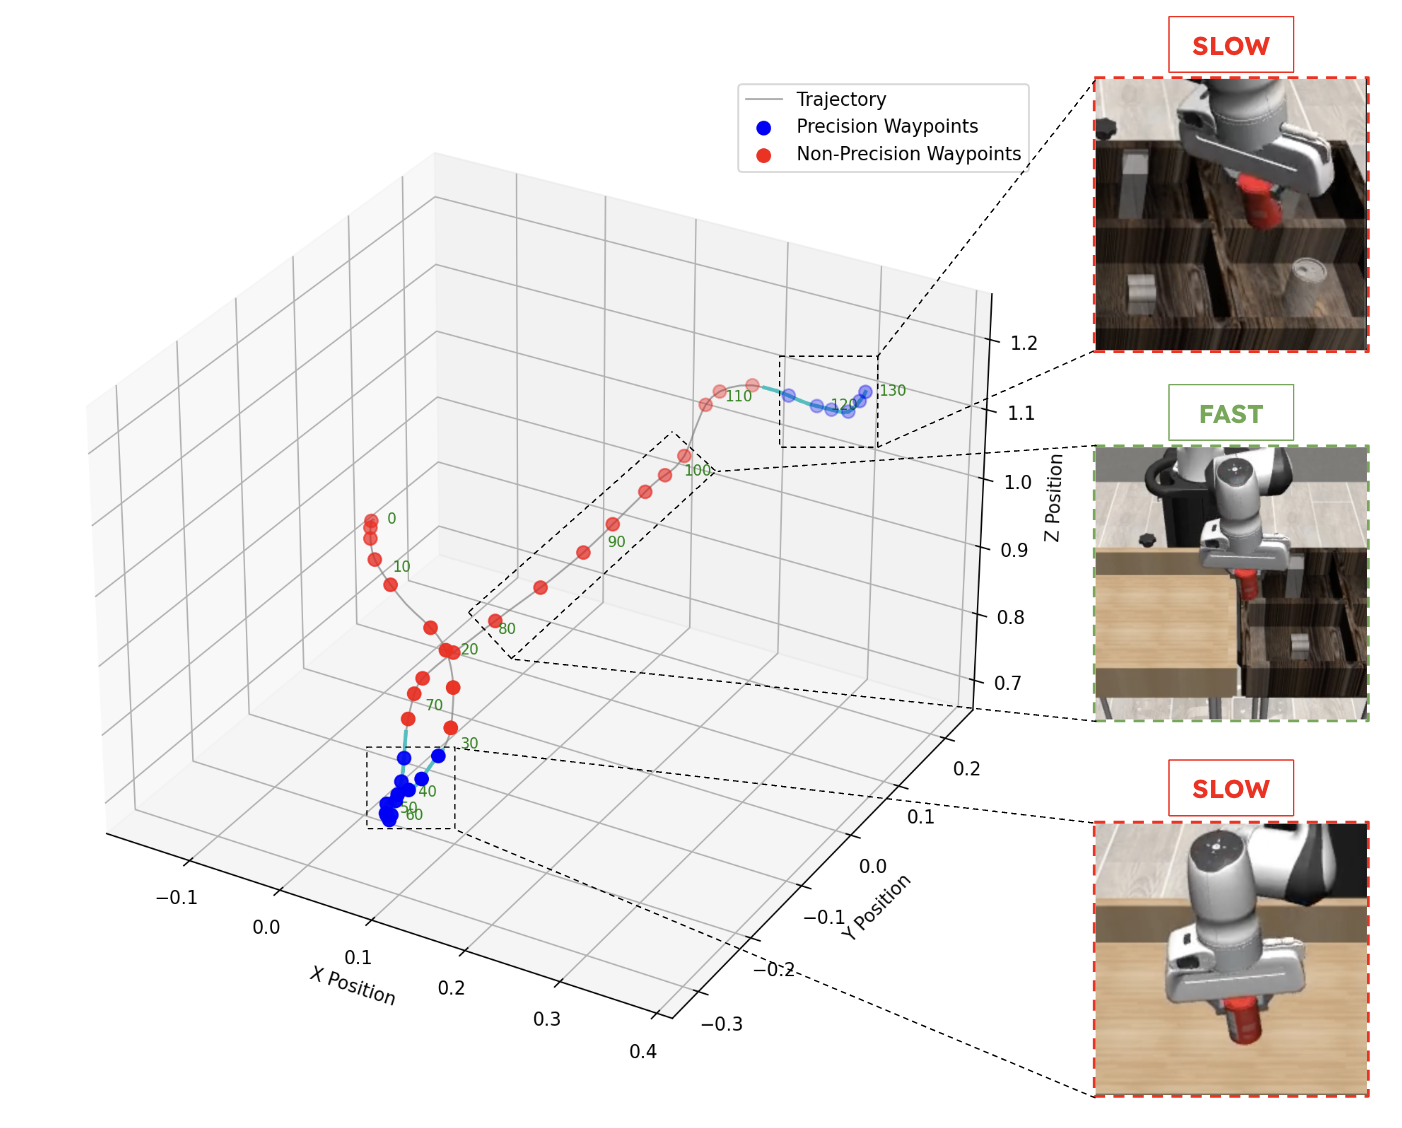
我们结合示教数据分析和运行时预测,用两种互补方法识别关键动作。(1) 运动复杂度分析:受 AWE [34] 启发,对示教离线分析(例如对示教路点做 DBSCAN 聚类 [35]),标出几何复杂度高的片段;然后训练策略 \(\pi\) 在输出动作的同时,预测当前动作是否对应需要复杂而谨慎运动的阶段。(2) 夹爪事件检测:运行时用一个简单的启发式来识别可能的交互阶段,即检测策略输出动作序列 \(a_{t:t+H}\) 中预测夹爪状态的变化(张开或闭合)。两种方法都为当前时刻 \(t\) 给出一个二值关键动作标志 \(k_t\in\{0,1\}\),\(k_t=1\) 表示关键动作。我们在预设的慢速值 \(c^{\mathrm{slow}}\) 与快速值 \(c^{\mathrm{fast}}\) 之间调制加速因子:
这样 SAIL 就能在需要精度时自动减速,在伸手靠近等简单运动时自动加速。更多细节见附录 F。
4.4 在系统延迟下保持高速实时控制
动作调度。 自适应调制决定了期望执行速度 \(c_t\),但要在较高平均速度下保持稳定控制,还必须显式处理系统固有的延迟 [29]。从请求传感数据(时刻 \(t^{o}\))到收到策略算出的动作序列(时刻 \(t^{a}\))之间,存在无法消除的感知到动作延迟 \(\delta^{\mathrm{delay}}\)。为保持机器人连续运动、避免停顿,SAIL 在这段 \(\delta^{\mathrm{delay}}\) 内继续执行上一次推理规划好的动作。新的动作序列 \(\hat{a}_{0:H}\) 在 \(t^{a}\) 到达后,系统按自适应确定的间隔 \(\delta_t=c_t\delta^{*}\) 调度其执行,并在从旧计划过渡时丢弃旧计划中被安排在 \(t^{a}\) 之后的动作。这个过程如图 E.2 所示(见下文“附录摘录”)。
速度上界。 关键在于,延迟 \(\delta^{\mathrm{delay}}\) 对可达到的最大平均加速比施加了根本性的物理限制。为避免“动作耗尽”,即下一次推理完成之前就把指令用光,实际执行间隔 \(\delta_t\) 必须有下界。这个下界
(\(H^{\mathrm{p}}\) 为预测时域,\(H^{\mathrm{c}}\) 为条件长度,推导见附录 E)表示维持连续运行所需的单步最短时间。因此自适应选出的期望间隔 \(c_t\delta^{*}\) 必须遵守这一物理极限,控制器在时刻 \(t\) 实际采用的最终执行间隔为
这保证了 SAIL 既按 \(c_t\) 动态改变速度,又不会超过系统因延迟而决定的物理能力,哪怕在高速下也如此。
5. 实验
我们检验以下假设。H1:误差感知引导 (EAG) 生成时间上一致的动作,从而提升高速下的策略表现。H2:SAIL 的所有组件对于在保持高成功率的同时实现超示教速度执行都不可或缺。H3:SAIL 可以通用地部署到真实机器人的现实任务上。
评价指标。 主要指标是带遗憾的吞吐量 (throughput-with-regret, TPR\(\uparrow\)),它奖励更快的成功,并对所有失败给予同等惩罚,因此能反映策略在更高执行速度下维持成功率的能力(定义见附录 B 式 (2))。我们另外考察两组指标。第一组关注任务表现与效率:任务成功率 (SR\(\uparrow\))、TPR、成功 rollout 的平均耗时 (ATR\(\downarrow\)) 以及相对示教的加速比 (speedup-over-demo, SOD\(\uparrow\))。第二组刻画生成运动轨迹的特性(如平滑度):一致性 (CON\(\downarrow\))、谱弧长 (SPARC\(\uparrow\)) [36]、对数无量纲加加速度 (LDLJ\(\downarrow\)) [36] 以及加权欧氏距离 (WED\(\downarrow\)) [8]。各指标的详细说明见附录 B。
5.1 仿真评测:SAIL 取得高任务吞吐量
设置。 我们在 RoboMimic [37] 与 MimicGen [38] 的标准操作基准上评测 SAIL 及多个基线,任务包括 Lift、Can、Square、Stack 和 Mug Cleanup,更多设置见附录 C。由于几乎没有模仿学习方法直接解决执行加速问题,我们自行设计了若干基线,其中包括 AWE [34],它基于路点的做法会附带产生加速效果。基线为:(1) DP [1]:以原始示教速度执行动作,是主要对照基线。(2) DP-Fast:用低增益控制器、以更高的固定频率执行 Diffusion Policy 的动作,代表朴素的提速做法。(3) Aggregated Actions:在增量笛卡尔空间 (delta Cartesian space) 中,把方向相近的连续动作聚合(详见附录 I)。(4) AWE [34]:用自动提取的路点生成绝对动作标签。(5) BID-Fast:与 DP-Fast 相同,但使用 BID [8] 在滚动时域 rollout 中强化相邻预测间的一致性。网络架构和参数细节见附录 J。
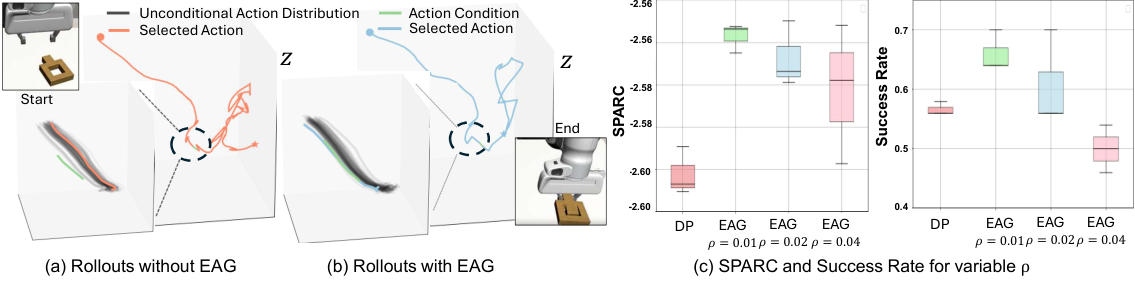
EAG 在高速下生成时间上一致的运动(H1)。 为评估 EAG 的效果,我们同时考察轨迹平滑度与任务表现。图 5 的定性运动结果和定量指标(SPARC)表明,EAG 显著增强了运动一致性,进而提升了加速执行时的任务成功率(SR)。表 K.6 中的消融 SAIL(-C) 也进一步证实:去掉保持一致性的轨迹生成会使性能下降。此外我们还观察到,当被条件化的未来动作落在无条件动作分布之内时,一致性引导最有效。执行速度越快,观测与条件动作之间的错位就越明显,这与跟踪误差的增大高度相关。附录 H.1 中的详细结果证实,自适应的跟踪误差截断对于有效的条件引导至关重要。
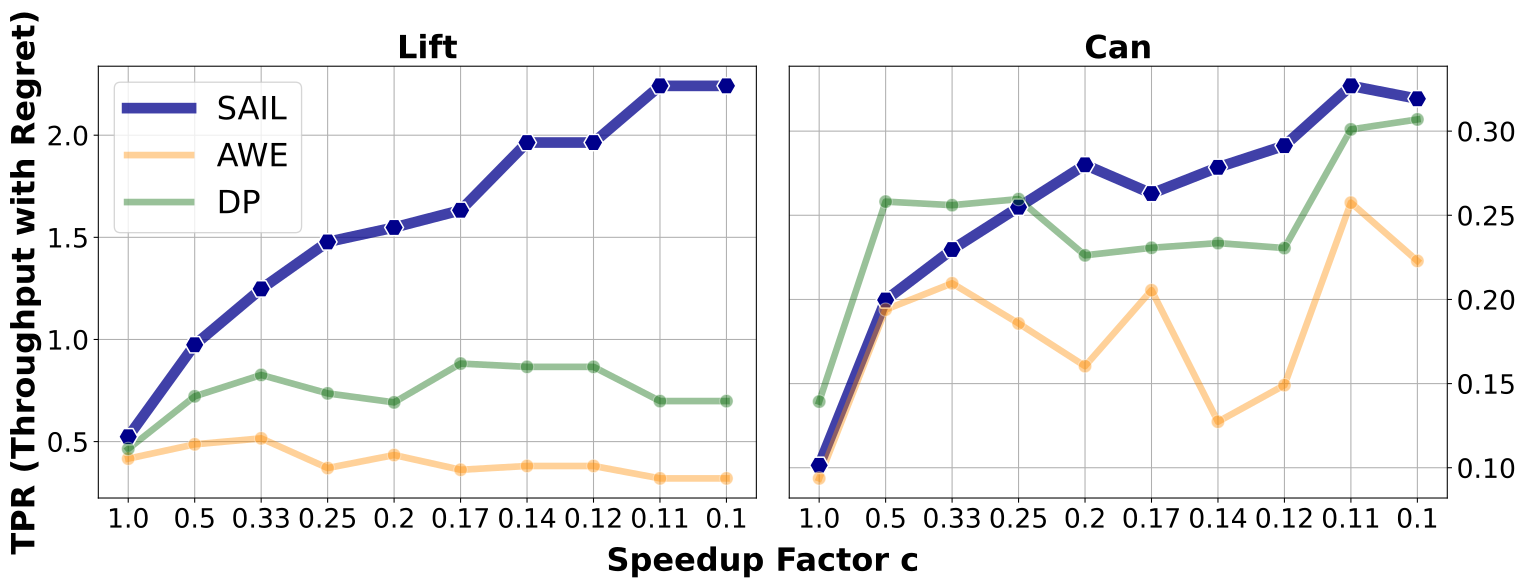
SAIL 的吞吐量远高于各基线(H1)。 (译注:原文此处标记为 H1,按上下文应对应 H2。) 如表 1 所示,在 Can 和 Stack 任务上,SAIL 的吞吐量最高可达 DP [1] 等基线的 \(3\times\),同时不牺牲成功率。我们把这归功于多个组件的结合,包括高增益控制器、对到达位姿的跟踪以及自适应速度调制。此外,我们还在图 6 中细致研究了随着 \(c_t\) 变化吞吐量 (TPR) 的走向。SAIL 的 TPR 随 \(c_t\) 减小而平滑提升,直到 \(c_t=0.1\)(\(10\times\) 加速)都表现稳健,至少在理想的仿真环境中如此。
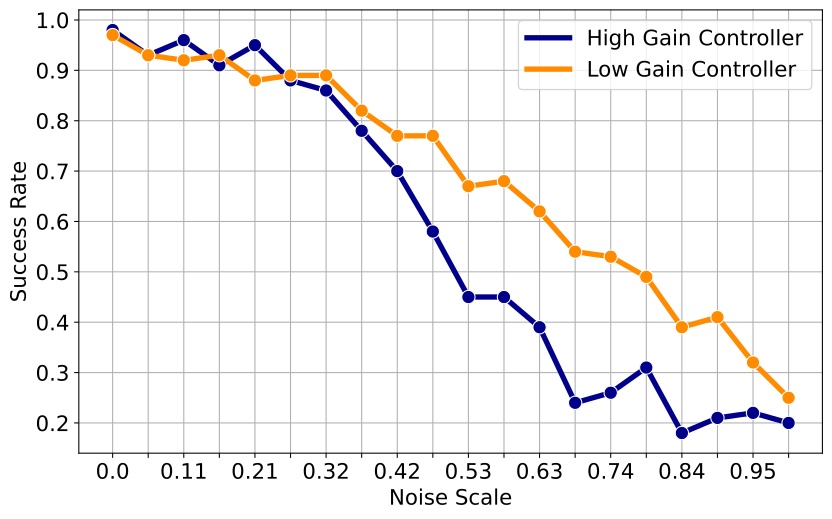
组件消融(H2)。 这里给出对 SAIL 关键组件的消融结论,完整结果见附录。第一,高增益控制器虽是快速跟踪所必需,但对参考轨迹的噪声很敏感。如第 G.2 节图 G.5 所示,带噪声的参考会让高增益控制的成功率急剧下降,说明需要 EAG 这类机制提供平滑的参考轨迹。第二,模仿到达位姿对高速执行至关重要。换成指令位姿会显著降低性能,在更快地重放示教或使用更高增益时尤为明显(见第 G.1 节)。表 K.6 量化了这一点:使用指令位姿而非到达位姿,会使 Square 的成功率下降 55%,使各任务平均 TPR 比完整 SAIL 低 0.08。第三,自适应速度调制 (AS) 非常关键,对精度要求高的任务尤其如此。在表 K.6 中对比 SAIL 与 SAIL(-AS)(去掉自适应速度的 SAIL),可见没有 AS 时成功率明显更低,在 Square 和 Mug 上最多下降 31%。这凸显了动态调节速度的重要性,在 Square 这类高精度场景中尤其如此。
| 方法 | Lift | Can | Square | Stack | Mug | |||||||||||||||
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| SR↑ | TPR↑ | ATR↓ | SOD↑ | SR↑ | TPR↑ | ATR↓ | SOD↑ | SR↑ | TPR↑ | ATR↓ | SOD↑ | SR↑ | TPR↑ | ATR↓ | SOD↑ | SR↑ | TPR↑ | ATR↓ | SOD↑ | |
| DP [1] | 1.00 | 0.46 | 2.23 | 1.08 | 0.97 | 0.18 | 5.52 | 1.05 | 0.83 | 0.10 | 7.56 | 0.99 | 1.00 | 0.19 | 5.50 | 0.98 | 0.68 | 0.03 | 17.44 | 0.97 |
| DP-Fast | 0.95 | 1.02 | 1.52 | 1.59 | 0.87 | 0.37 | 2.34 | 2.48 | 0.55 | 0.15 | 3.42 | 2.20 | 0.98 | 0.44 | 2.37 | 2.28 | 0.56 | 0.05 | 9.67 | 1.74 |
| AWE [34] | 1.00 | 0.44 | 2.35 | 1.02 | 0.96 | 0.17 | 5.80 | 1.00 | 0.83 | 0.10 | 8.13 | 0.93 | 0.98 | 0.11 | 9.01 | 0.60 | 0.75 | 0.02 | 28.79 | 0.59 |
| Agg. Act. | 0.91 | 0.52 | 1.78 | 1.37 | 0.82 | 0.16 | 4.77 | 1.22 | 0.29 | 0.03 | 4.81 | 1.57 | 0.82 | 0.17 | 6.18 | 0.87 | 0.59 | 0.03 | 15.86 | 1.06 |
| BID-Fast [8] | 0.86 | 0.91 | 0.97 | 2.50 | 0.79 | 0.34 | 2.39 | 2.34 | 0.49 | 0.12 | 3.45 | 2.18 | 0.99 | 0.47 | 2.61 | 2.07 | 0.62 | 0.06 | 8.71 | 1.94 |
| SAIL (Ours) | 1.00 | 1.68 | 0.61 | 3.98 | 0.92 | 0.51 | 1.81 | 3.20 | 0.86 | 0.13 | 6.41 | 1.18 | 0.98 | 0.66 | 1.56 | 3.47 | 0.72 | 0.08 | 8.09 | 2.09 |
5.2 真机评测:SAIL 在硬件上取得高吞吐量
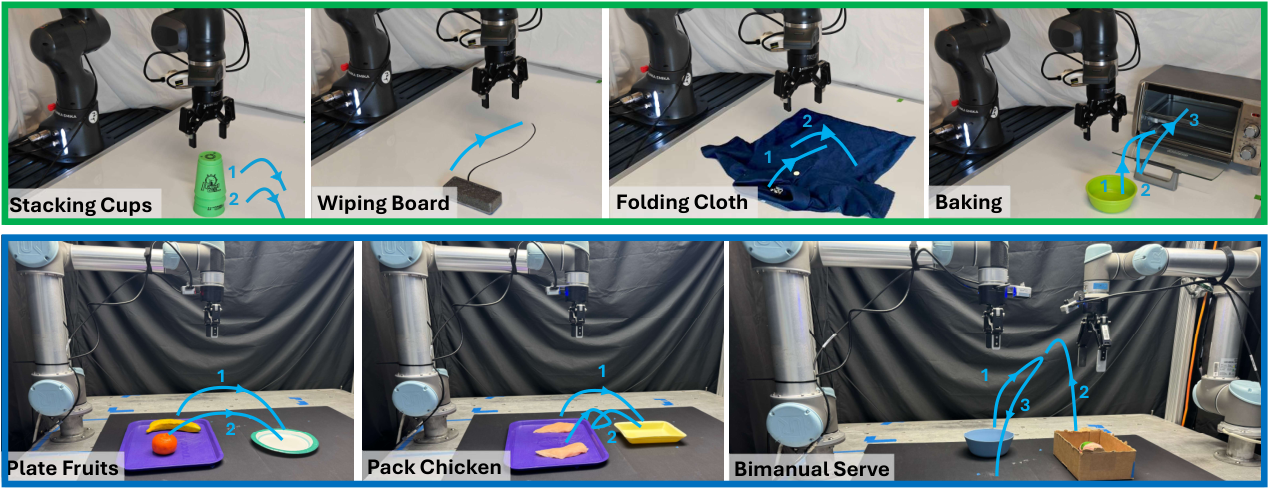
设置。 我们在两种机器人平台(Franka Emika Panda 和双臂 UR5)上评测方法,共 7 个有挑战的操作任务(见图 7),涉及长时程、高精度步骤和双臂协同(详见第 D.3 节)。两个平台都运行高保真跟踪控制器(详见附录 D)。我们把 \(5\times\) 加速的 SAIL 与同为 \(5\times\) 加速的 DP-Fast 对比,每种方法在每个任务上评测 10 次 rollout。
| 方法 | Stacking Cups(叠杯) | Wiping Board(擦板) | Baking(烘焙) | Folding Cloth(叠衣) | ||||||||||||
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| SR↑ | TPR↑ | ATR↓ | SOD↑ | SR↑ | TPR↑ | ATR↓ | SOD↑ | SR↑ | TPR↑ | ATR↓ | SOD↑ | SR↑ | TPR↑ | ATR↓ | SOD↑ | |
| DP-Fast | 0.10 | -2.28 | 14.00 | 1.85 | 0.90 | 3.48 | 14.54 | 2.34 | 0.90 | 3.06 | 16.15 | 2.26 | 0.10 | -2.28 | 14.60 | 2.08 |
| SAIL | 0.40 | -0.12 | 14.71 | 1.76 | 0.70 | 3.18 | 10.44 | 3.26 | 1.00 | 4.20 | 14.39 | 2.54 | 0.30 | -0.78 | 13.68 | 2.22 |
| 方法 | Plate Fruits(摆水果) | Pack Chicken(装鸡肉) | Bimanual Serve(双臂上菜) | |||||||||
|---|---|---|---|---|---|---|---|---|---|---|---|---|
| SR↑ | TPR↑ | ATR↓ | SOD↑ | SR↑ | TPR↑ | ATR↓ | SOD↑ | SR↑ | TPR↑ | ATR↓ | SOD↑ | |
| DP-Fast | 0.60 | 2.22 | 13.74 | 1.66 | 0.40 | 0.51 | 17.33 | 1.25 | 0.40 | 1.00 | 12.01 | 1.43 |
| SAIL | 0.80 | 5.46 | 8.53 | 2.67 | 0.90 | 5.22 | 9.40 | 2.30 | 0.70 | 5.40 | 7.19 | 2.39 |
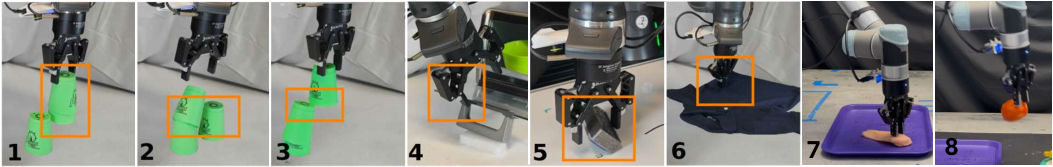
结果:SAIL 克服了 DP-Fast 的失败模式(H3)。 在控制系统、机器人动力学和任务各不相同的情况下,SAIL 普遍提升了任务吞吐量。表 2 显示,在 7 个有挑战的任务中有 6 个任务的吞吐量 (TPR) 与 SOD 同时得到改善,说明 SAIL 相对加速后的扩散策略具有稳定的速度优势。从定性角度(图 8)看,SAIL 克服了 DP 在高速执行时的常见失败模式。其一,DP 在推理滞后时常因动作耗尽而停顿,SAIL 则通过平滑的动作调度保持持续运动。其二,高速会加剧 DP 抓取不精确的问题,而 SAIL 的自适应速度调制会在关键阶段放慢,因此在摆水果、装鸡肉、叠杯这类中高精度任务上提高了成功率。其三,低保真的运动跟踪经常导致 DP 失败,对叠衣、烘焙这类需要精确定位的动作尤其如此,SAIL 相比原始遥操作控制器 \(\mathcal{K}^{\mathrm{teleop}}\) 显著降低了跟踪误差,从而改善了精度要求高的阶段的表现。其四,DP 的动作预测不一致会造成运动抖动,在更高速度下难度更大,这在双臂上菜任务中最为明显:SAIL 得到更平滑的轨迹,吞吐量高出 \(5.4\times\),成功率约高 \(1.8\times\)。最后需要指出,SAIL 在擦板任务上略逊于 DP。我们推测原因在于,高增益跟踪控制器无法适应更高速度下新的机器人—物体动力学(擦拭时持续接触)。更多讨论见“局限”一节。
6. 结论
我们形式化并明确了一个新问题的挑战:让视觉运动策略以快于示教的速度执行。我们提出的框架 SAIL 从全栈角度解决这个问题,综合了误差自适应引导、与控制器无关的目标、自适应速度调制以及延迟感知的调度。实验表明,在多样的任务上,SAIL 在保持较高成功率的同时,仿真中最高实现 \(4\times\) 加速,真机上最高实现 \(3.2\times\) 加速。
7. 局限
通过形式化“超示教速度执行”这一新问题并给出方案,我们也发现了若干根本性的挑战,它们为机器人学界打开了新的研究方向。首先,SAIL 主要处理由控制器动力学偏移带来的观测—动作漂移,并没有显式解决机器人与物体交互的动力学偏移。这在更高速度下机器人—物体动力学变得复杂得多的操作任务中表现得最明显,例如在仿真的 Can 任务里,我们观察到执行速度提高后,动量增大可能使机器人不小心把罐子甩出工作空间。与之相关,离线模仿学习的数据有限,因此容易受分布偏移影响,仅靠改进策略学习算法解决不了这个问题。未来研究可以探索把显式动力学建模引入策略:或利用已知的动力学模型,或在训练阶段从基于仿真的数据中学习。
随着学习式操作持续走向真实场景,我们认为一个重要方向是让机器人学习系统能联合优化底层控制,以及预测动作在不同执行速度下将产生的动态效应。希望这项工作能为学得的策略在真实工业应用中的更广泛采用开辟新路径。
致谢(节译):作者感谢佐治亚州与佐治亚理工农业技术研究计划对本工作的支持;也感谢美国商务部经济发展署资助的 Georgia AIM 项目(AI Manufacturing Pilot Facility,Award 04-79-07808)、NSF CCF 项目(Award 2211815)以及 NSF Award 1937592。
附录摘录
原文附录篇幅较长,这里不做全文翻译,只概括各节内容,并摘录与方法理解最相关的公式和图。附录依次为:A 目录;B 评价指标的公式与说明(TPR、ATR、SOD、CON、SPARC、LDLJ、WED);C 仿真实验设置;D 真机硬件、数据采集与 7 个任务的描述;E 动作间隔下界的推导;F 自适应速度调制(运动复杂度与夹爪事件两种识别方法及算法 1);G 验证各组件作用的小实验;H 针对 EAG 的实验与算法 2;I 动作聚合基线 (Aggregated Actions) 的算法 3;J 策略与控制器的超参数;K 详细消融以及 SAIL 配合 ACT 的结果。完整内容请阅读 arXiv HTML 或 PDF。
E. 动作间隔下界 \(\delta^{\mathrm{lb}}\) 的推导与动作调度(图 E.2)
为推出能保持控制回路连续的动作间隔 \(\delta\)(即最大加速)下界,设 \(H^{\mathrm{p}}\) 为策略预测时域,\(\delta^{\mathrm{lb}}\) 为待求的 \(\delta_t\) 的常数下界。考虑三个关键参数:(a) 感知—推理延迟 \(\delta^{\mathrm{delay}}=t^{a}-t^{o}\);(b) 最短可能的动作执行时间 \(H^{\mathrm{p}}\cdot\delta^{\mathrm{lb}}\);(c) 用于一致性条件化的动作块的最短长度 \(H^{\mathrm{c}}\)(见第 4.1 节,对应那里的尾部条件长度)。要保证连续执行,可用的动作序列必须比“感知—推理延迟加条件时域”更长,于是
加长预测时域 \(H^{\mathrm{p}}\) 能降低 \(\delta^{\mathrm{lb}}\)(允许更高加速),但这要求在更长时域上准确预测动作,本身就很难 [44]。因此实践中预测时域 \(H^{\mathrm{p}}\) 与感知—推理延迟 \(\delta^{\mathrm{delay}}\) 共同决定了 \(\delta_t\) 的最小界,进而决定加速因子的取值范围:
还要注意,第 4.3 节的 \(c_t\) 不影响这一计算:下界给出的是最坏情形保证,即便 \(c_t\) 在某些阶段增大(放慢),我们也不能事先依赖它来推算保证连续执行的 \(\delta^{\mathrm{lb}}\)。
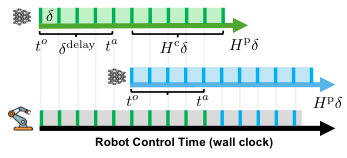
F. 自适应速度调制(图 F.3)
我们要在示教数据里识别出关键动作,训练策略同时预测动作及其关键动作标签,并在执行时据此动态调整加速因子 \(c\)。两种识别方法各返回一个二值标志 \(k_t\in\{0,1\}\),据此设定 \(c_t=k_t\cdot c^{\mathrm{slow}}+(1-k_t)\cdot c^{\mathrm{fast}}\)(式 (10)),其中 \(c^{\mathrm{slow}},c^{\mathrm{fast}}\in(0,1]\),且 \(c^{\mathrm{slow}}>c^{\mathrm{fast}}\),因为加速比是 \(c\) 的倒数;二者按任务取经验验证过的预设值,\(c_t\) 还要受附录 E 的下界约束。
运动复杂度:受 AWE [34] 启发,用一组由线性段连接的路点去近似示教中的指令末端位姿;在给定的误差预算下,运动越复杂,生成的路点越多。随后用 DBSCAN [35] 在三维空间对路点聚类,它比 k-means 等球形或质心类聚类更善于发现任意形状的簇,还会隐式滤除不代表显著运动变化的噪声点。为把每个时间步与路点对应,在时间上对路点做线性插值;给定最小簇大小后,若时刻 \(t\) 的路点落在某个簇内则令 \(k_t=1\),否则令 \(k_t=0\)(算法 1)。夹爪事件:关键动作往往发生在与物体、环境交互时,这与夹爪状态变化相关,因此当时刻 \(t\) 夹爪正在张开或闭合时令 \(k_t=1\),否则 \(k_t=0\)。
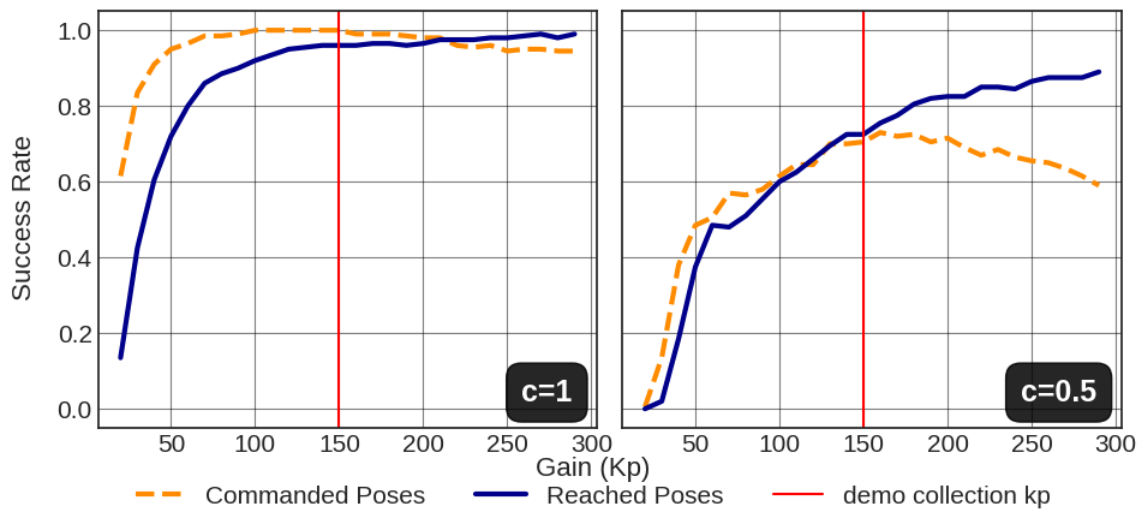
G. 各组件作用的小实验(图 G.4、G.5 与表 G.1)
G.1 加速需要高增益控制器。 我们在 Can 任务上以不同速度重放示教,并记录给定控制器增益 \(K_p\) 下的成功率,比较重放指令位姿 \(x^{\mathrm{d}}\) 与到达位姿 \(x\) 的差别。图 G.4 表明,高增益控制配合到达位姿跟踪,可以在不同执行速度下保持一致的行为:指令位姿在高增益下加速执行时会产生超调并导致任务失败;而只要控制器增益足够高、能保证精确跟踪,用到达位姿作参考轨迹就能在更高速度下一直保持较高成功率。
G.2 高增益控制器需要平滑的参考轨迹。 更快的执行可能产生 OOD 观测,使策略输出噪声更大的参考轨迹。图 G.5 显示,随着噪声幅度增大,高增益控制器的性能下降得比低增益控制器更快(每个噪声幅度取 100 次 rollout 的平均成功率)。这揭示了系统中一个重要的耦合:高增益控制是高速下精确跟踪所必需的,但同时会放大预测参考轨迹中的任何不一致,这就解释了为什么需要对轨迹做平滑处理。
G.3 动作条件化提高预测间的时间一致性。 不一致的动作预测是参考轨迹不平滑、加速执行失败的主要原因,因此我们检验动作条件化是否改善了时间一致性与平滑度:在 5 个任务上、加速因子为 0.2 时,对比有无动作条件化的 rollout,用 SPARC、CON 和 WED 评估。表 G.1 显示,动作条件化得到更平滑的动作,体现为更高的 SPARC 和更低的 CON、WED(相对基线 DP)。
| 任务 | 方法 | SR↑ | SPARC↑ | CON↓ | WED↓ |
|---|---|---|---|---|---|
| Lift | SAIL | 0.97 | -2.80 | 0.091 | 0.348 |
| BID [8] | 0.53 | -2.85 | 0.116 | 0.395 | |
| Baseline | 0.92 | -2.83 | 0.094 | 0.376 | |
| Can | SAIL | 0.76 | -2.80 | 0.232 | 0.885 |
| BID [8] | 0.62 | -2.93 | 0.325 | 0.525 | |
| Baseline | 0.73 | -2.83 | 0.230 | 0.930 | |
| Square | SAIL | 0.87 | -2.74 | 0.107 | 0.916 |
| BID [8] | 0.12 | -3.06 | 0.217 | 0.327 | |
| Baseline | 0.81 | -2.80 | 0.121 | 0.957 | |
| Stack | SAIL | 0.90 | -2.50 | 0.168 | 0.634 |
| BID [8] | 0.92 | -2.56 | 0.641 | 0.794 | |
| Baseline | 0.89 | -2.56 | 0.156 | 0.739 | |
| Mug | SAIL | 0.63 | -2.80 | 0.228 | 1.192 |
| BID [8] | 0.40 | -2.62 | 0.831 | 0.679 | |
| Baseline | 0.59 | -2.88 | 0.276 | 1.210 |
H. EAG 实验(图 H.8、H.9)
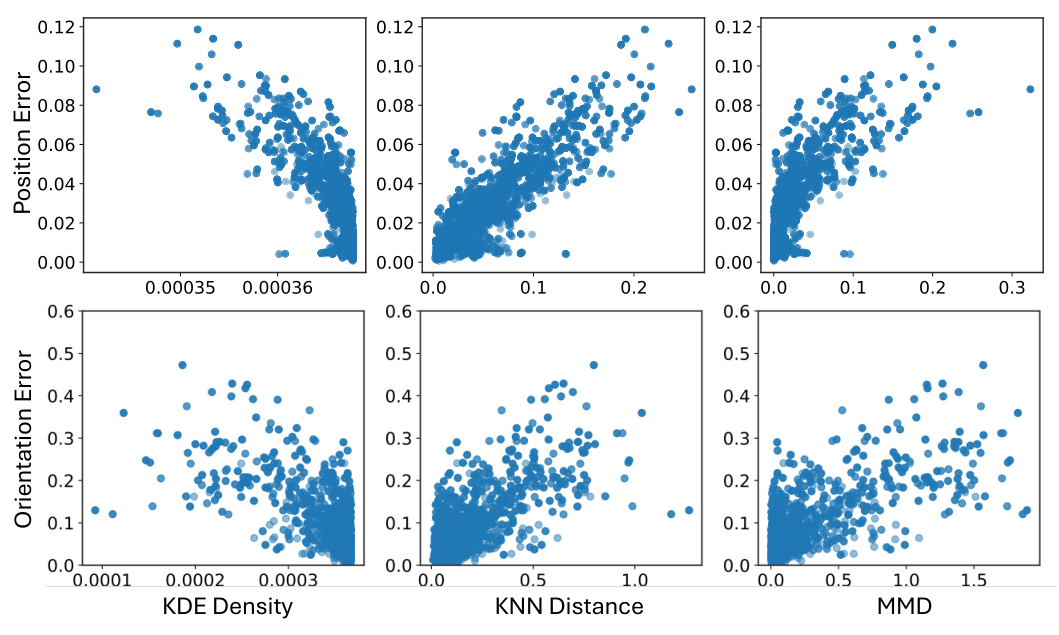
附录 H 先给出误差自适应引导的算法 2,随后验证三个驱动一致性生成设计的假设:H-EAG1,条件动作与观测对齐时,一致性引导有益;H-EAG2,策略加速会使观测与条件动作之间的错位加剧;H-EAG3,跟踪误差与观测—动作错位高度相关。前两项实验的做法是:固定观测,从无条件动作分布中采样 64 条动作序列,选一条作为未来动作条件,再用权重为 1 的 CFG 生成 64 条序列;之后对条件施加时间平移和空间扰动(均匀噪声幅度 0.02),观察条件分布是否仍贴合条件动作。结果表明,只有当条件落在无条件动作分布内时,CFG 才能可靠对齐,这说明这类条件很可能在训练数据中出现过;而条件偏离无条件分布(例如由跟踪误差引起)时,模型难以算出合适的条件得分。在 H.2 中,作者又用 KDE、kNN 距离(\(k=8\))和 MMD 三种 OOD 指标,证实加速因子越大,条件动作越容易落到分布之外。
H.3 的关键是:OOD 指标计算代价高,不适合实时部署,于是改用跟踪误差作代理。位置与姿态跟踪误差定义为
其中 \(R(\cdot)\) 把任意姿态表示映射为 SO(3) 旋转矩阵,\(\operatorname{tr}(\cdot)\) 为矩阵的迹。图 H.8 显示跟踪误差越大,条件动作越可能落在无条件分布之外,说明它是检测“条件错位”的有效代理指标。
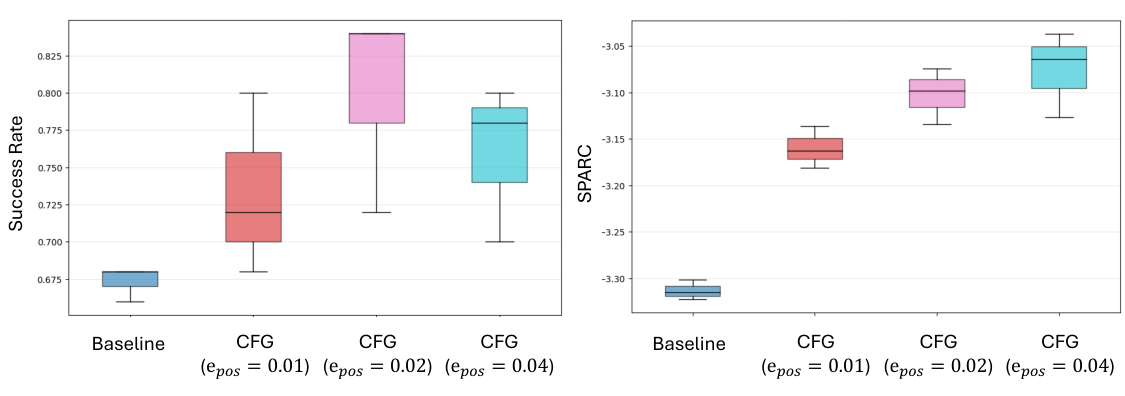
在 Square 任务、加速因子 \(c=0.33\) 下,作者把位置跟踪误差阈值设为 0.01、0.02、0.04,每个策略评测 50 个场景、每个场景 3 次,只在误差低于阈值时施加 CFG,并与无引导基线比较。三种阈值下实际施加引导的推理步比例(guided inference ratio)分别为 0.27、0.47 和 0.78。结果显示,不加区分地使用 CFG(引导比例高)会降低成功率,大概是观测与动作条件错位所致;相反,只在跟踪误差较低时才施加 CFG,则成功率和平滑度同时改善,适中的阈值整体最好,最高的阈值(0.04)会拉低成功率。需要注意最优阈值与任务相关:参考轨迹越复杂,跟踪误差天然越大;文中数值是针对 Square 任务调参得到的。
J. 超参数
策略骨干为带 ResNet18 视觉编码器的 Diffusion Policy(UNet,下采样维度 256/512/1024;DDIM,训练 100 步、推理 10 步;序列长度与预测时域均为 32,观测时域 4;batch size 128,训练 2000 个 epoch,使用 EMA)。未来动作条件化的时域为 4,训练时以 \(p_{\mathrm{cond}}=0.3\) 的概率把条件替换成空 token(取零),引导权重为 1.0。下面是一致性引导和控制器的关键参数。
| 任务 | CFG 权重 | TEB (Ori.) | TEB (Pos.) |
|---|---|---|---|
| Can | 0 | 0.05 | 0.02 |
| Lift | 1 | 0.05 | 0.02 |
| Square | 1 | 0.05 | 0.02 |
| Mug Cleanup | 1 | 0.05 | 0.02 |
| Stack | 0 | 0.03 | 0.01 |
| lift | can | square | stack | mug cleanup | |
|---|---|---|---|---|---|
| \(K_p\) | 3000 | 3000 | 1000 | 3000 | 2000 |
| damping | 0.5 | 0.5 | 1 | .75 | .75 |
| slowdown \(c\) | 0.2 | 0.5 | 1.0 | 0.2 | 0.5 |
| 示教采集 | SAIL 执行 | |
|---|---|---|
| \(K_p^{pos}\) | 150 | 300 |
| \(K_v^{pos}\) | 24.5 | 34.6 |
| \(K_p^{rot}\) | 250 | 400 |
| \(K_v^{rot}\) | 31.6 | 40.0 |
K. 详细消融与 SAIL + ACT
表 K.6 给出对 SAIL 各组件的细致消融:-HG 去掉高增益控制器,-AS 去掉自适应速度,-C 去掉保持一致性的条件引导,Commanded Poses 改为预测指令位姿(正文结论即由此表得出)。表 K.7 则展示了 SAIL 搭配 ACT [2] 的结果,此时只是用时间集成 (temporal ensembling) 取代 CFG 来保持相邻预测的一致性。
| 任务 | 指标 | DP [1] | SAIL | -HG | -AS | -C | Commanded Poses |
|---|---|---|---|---|---|---|---|
| Lift | SR↑ | 1.00 | 1.00 | 0.67 | 0.97 | 0.98 | 0.89 |
| TPR↑ | 0.46 | 1.68 | 0.25 | 1.57 | 1.58 | 1.8 | |
| ATR↓ | 2.23 | 0.61 | 3.39 | 0.63 | 0.63 | 0.52 | |
| SOD↑ | 1.08 | 3.98 | 0.71 | 3.85 | 3.84 | 4.63 | |
| Can | SR↑ | 0.97 | 0.92 | 0.83 | 0.95 | 0.89 | 0.63 |
| TPR↑ | 0.18 | 0.51 | 0.18 | 0.60 | 0.50 | 0.37 | |
| ATR↓ | 5.52 | 1.81 | 4.36 | 1.61 | 1.79 | 1.65 | |
| SOD↑ | 1.05 | 3.20 | 1.33 | 3.60 | 3.23 | 3.52 | |
| Square | SR↑ | 0.83 | 0.86 | 0.59 | 0.64 | 0.79 | 0.31 |
| TPR↑ | 0.10 | 0.13 | 0.06 | 0.25 | 0.13 | 0.04 | |
| ATR↓ | 7.56 | 6.41 | 8.8 | 2.50 | 5.78 | 4.25 | |
| SOD↑ | 0.99 | 1.18 | 0.86 | 3.01 | 1.31 | 1.77 | |
| Stack | SR↑ | 1.00 | 0.98 | 0.9 | 0.94 | 0.95 | 0.82 |
| TPR↑ | 0.19 | 0.66 | 0.15 | 0.61 | 0.62 | 0.43 | |
| ATR↓ | 5.50 | 1.56 | 6.6 | 1.71 | 1.56 | 2.81 | |
| SOD↑ | 0.98 | 3.47 | 0.86 | 3.15 | 3.46 | 1.92 | |
| Mug | SR↑ | 0.68 | 0.72 | 0.53 | 0.44 | 0.68 | 0.54 |
| TPR↑ | 0.03 | 0.08 | 0.01 | 0.07 | 0.08 | 0.03 | |
| ATR↓ | 17.44 | 8.09 | 18.24 | 5.37 | 8.15 | 17.38 | |
| SOD↑ | 0.97 | 2.09 | 0.92 | 3.14 | 2.07 | 0.92 |
| 方法 | Lift | Can | Square | Stack | ||||||||||||
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| SR↑ | TPR↑ | ATR↓ | SOD↑ | SR↑ | TPR↑ | ATR↓ | SOD↑ | SR↑ | TPR↑ | ATR↓ | SOD↑ | SR↑ | TPR↑ | ATR↓ | SOD↑ | |
| ACT | 1.00 | 0.40 | 2.69 | 0.90 | 0.77 | 0.12 | 4.04 | 0.96 | 0.51 | 0.04 | 8.21 | 0.92 | 0.73 | 0.11 | 6.18 | 0.87 |
| SAIL | 0.94 | 1.50 | 0.65 | 3.71 | 0.56 | 0.25 | 2.12 | 2.72 | 0.43 | 0.11 | 3.22 | 2.34 | 0.68 | 0.28 | 3.14 | 1.72 |
B. 吞吐量指标 TPR 的定义(式 (2))
主文反复使用的 TPR 在附录 B 中定义为
其中 \(t_i\) 是 rollout \(i\) 的时长(仿真中的总时钟时间),\(t^{\mathrm{max}}\) 是每次试验允许的最长时间,\(S_i\in\{0,1\}\) 表示第 \(i\) 次试验是否成功。超过 \(t^{\mathrm{max}}\) 仍未成功的试验被中止并判为失败。因此成功越快奖励越多,每次失败则扣固定的 \(1/t^{\mathrm{max}}\)。这也解释了为什么真机表 2 中 SR 很低时 TPR 会出现负值。
参考文献
以下仅列出正文引用中最相关的 15 条,编号沿用原文。完整参考文献列表见 arXiv HTML 参考文献 与 PDF。
- C. Chi, S. Feng, Y. Du, Z. Xu, E. Cousineau, B. Burchfiel, S. Song. Diffusion Policy: Visuomotor Policy Learning via Action Diffusion. RSS 2023. arXiv:2303.04137
- T. Z. Zhao, V. Kumar, S. Levine, C. Finn. Learning Fine-Grained Bimanual Manipulation with Low-Cost Hardware(ACT). 2023. arXiv:2304.13705
- Y. Liu, J. I. Hamid, A. Xie, Y. Lee, M. Du, C. Finn. Bidirectional Decoding: Improving Action Chunking via Closed-Loop Resampling(BID). 2024. arXiv:2408.17355
- N. D. Ratliff, J. Issac, D. Kappler. Riemannian Motion Policies. 2018. arXiv:1801.02854
- D. Brown, W. Goo, P. Nagarajan, S. Niekum. Extrapolating Beyond Suboptimal Demonstrations via Inverse Reinforcement Learning from Observations(T-REX). ICML 2019. arXiv:1904.06387
- P. Sundaresan, H. Hu, Q. Vuong, J. Bohg, D. Sadigh. What's the Move? Hybrid Imitation Learning via Salient Points(SPHINX). 2024. arXiv:2412.05426
- Z. Fu, T. Z. Zhao, C. Finn. Mobile ALOHA: Learning Bimanual Mobile Manipulation with Low-Cost Whole-Body Teleoperation. 2024. arXiv:2401.02117
- C. Chi, Z. Xu, C. Pan, E. Cousineau, B. Burchfiel, S. Feng, R. Tedrake, S. Song. Universal Manipulation Interface: In-The-Wild Robot Teaching Without In-The-Wild Robots(UMI). RSS 2024. arXiv:2402.10329
- S. Ross, G. Gordon, D. Bagnell. A Reduction of Imitation Learning and Structured Prediction to No-Regret Online Learning(DAgger). AISTATS 2011. arXiv:1011.0686
- J. Ho, T. Salimans. Classifier-Free Diffusion Guidance. 2022. arXiv:2207.12598
- S. H. Høeg, Y. Du, O. Egeland. Streaming Diffusion Policy: Fast Policy Synthesis with Variable Noise Diffusion Models. 2024. arXiv:2406.04806
- L. X. Shi, A. Sharma, T. Z. Zhao, C. Finn. Waypoint-Based Imitation Learning for Robotic Manipulation(AWE). CoRL 2023. arXiv:2307.14326
- A. Mandlekar, D. Xu, J. Wong, S. Nasiriany, C. Wang, R. Kulkarni, L. Fei-Fei, S. Savarese, Y. Zhu, R. Martín-Martín. What Matters in Learning from Offline Human Demonstrations for Robot Manipulation(RoboMimic). CoRL 2021. arXiv:2108.03298
- A. Mandlekar, S. Nasiriany, B. Wen, I. Akinola, Y. Narang, L. Fan, Y. Zhu, D. Fox. MimicGen: A Data Generation System for Scalable Robot Learning using Human Demonstrations. CoRL 2023. arXiv:2310.17596
- Y. Zhu, J. Wong, A. Mandlekar, R. Martín-Martín, et al. robosuite: A Modular Simulation Framework and Benchmark for Robot Learning. 2020. arXiv:2009.12293